

اکثر داشبوردهای «دیده شدن در هوش مصنوعی» اعداد اشتباهی را اندازه گیری می کنند. به جای تمرکز بر معیارهای سطحی، باید روی این سه مورد متمرکز شوید: حضور (Presence)، سهم توصیه شدگی (Recommendation Share) و دقت برند (Brand Accuracy).
دیده شدن در نتایج هوش مصنوعی (AI Search Visibility) به «معیار غرور» (Vanity Metric) جدید در دنیای دیجیتال مارکتینگ تبدیل شده است و اکثر تیم ها اعداد اشتباهی را رصد می کنند. ابزارهای فعلی که در بازار زیاد شده اند، صرفاً می شمارند که یک مدل هوش مصنوعی چند بار نام برند شما را در پاسخ به یک پرامپت (دستور) خاص ذکر یا نقل قول کرده است. این عدد حس پیشرفت می دهد، چون شبیه به «رنک ترکینگ» (Rank Tracking) یا رصد رتبه است که بیست سال آن را انجام می دادیم. اما واقعیت این است که این دو موضوع کاملاً متفاوت اند؛ شکاف میان آنچه این ابزارها می شمارند و آنچه واقعاً کسب وکار شما را رشد می دهد، هر روز عمیق تر می شود.
در ادامه، راهنمایی برای شناخت معیارهای واقعی در جستجوی هوش مصنوعی، تشخیص معیارهای نمایشی (که فقط در ظاهر مهم هستند) و نحوه تفکیک آن ها برای شما آماده کرده ایم. این محتوا حاصل گفتگوهای تخصصی پادکست No Hacks با حرفه ای های این حوزه و داده های اخیر است.
چرا «دیده شدن در هوش مصنوعی» معیار اشتباهی است؟
روش غالب فعلی برای اندازه گیری جستجوی هوش مصنوعی، «ردیابی پرامپت» (Prompt Tracking) است و به شکلی که اکثر تیم ها از آن استفاده می کنند، ابزار غلطی است. شیوه کار ساده است: یک ابزار، مجموعه ای از پرامپت ها را در ChatGPT، Perplexity و Google AI Overviews وارد می کند و گزارش می دهد که برند شما چند بار در نتایج نمایش داده شده است. این دقیقاً شبیه رصد رتبه سنتی است و به همین دلیل به راحتی فروش می رود. من هر هفته پیشنهادهای زیادی از شرکت هایی دریافت می کنم که چنین ابزاری ساخته اند و می خواهند در پادکست معرفی شوند. تقاضای بازار باعث شده این ابزارها بیش از حد نیاز ساخته شوند؛ اما تمرکز روی «دیده شدن»، چه مهم باشد و چه نباشد، به مسیر اشتباهی می رود.
جونو آلدرسون (Jono Alderson)، مشاور فنی سئو، اعتراض خود را این گونه مطرح می کند: «ما به جای شمارش دفعات نمایش، باید سعی کنیم بر نحوه درک ماشین از برندمان تأثیر بگذاریم. ردیابی پرامپت، همان کاری است که همه در حال انجامش هستند و جایگاهی دارد، اما بسیار کوچک تر از آن چیزی است که فکر می کنیم.» او تشخیص دقیق تری از بی راهه بودن این داشبوردها دارد: «این فقط کپی-پیست کردن مدل فعلی رنک ترکینگ در یک قالب جدید است. واقعاً منطقی نیست، اما از هیچی بهتر است.»
تصویری از یک میز کار قدیمی و مملو از گزارش های سئوی کاغذی که نشان دهنده تلاش برای اندازه گیری معیارهای سطحی هوش مصنوعی با ابزارهای قدیمی است، در حالی که یک مانیتور مدرن داده های واقعی را نشان می دهد
دام بزرگ: چرا داده های سئو دیگر قابل اعتماد نیستند؟
ردیابی پرامپت بر پایه حدسیاتی درباره رفتار کاربر است که عملاً پایه و اساسی ندارد. شما لیستی از پرامپت ها را که امیدوارید مشتریانتان تایپ کنند، می سازید و سپس عملکرد خود را بر اساس آن ها می سنجید. برای اکثر برندها، این لیست هیچ ارتباطی با آنچه مردم واقعاً می پرسند ندارد؛ به علاوه، یک «پرامپت هوش مصنوعی» با یک «کلمه کلیدی» متفاوت است. اگر بخواهید این پرامپت ها را با داده های واقعی جستجو پیوند بزنید، به مشکل دومی برمی خورید: هوش مصنوعی بسیار سریع تر از آنچه فکرش را بکنید، در حال فاسد کردن (Corrupting) این داده هاست.
من شخصاً شاهد این ماجرا بودم. سال گذشته به بررسی یک نشت عجیب کمک کردم: پرامپت های واقعی کاربران در ChatGPT در Google Search Console (گزارشی که وب سایت ها برای رصد ترافیک استفاده می کنند) ظاهر می شد. با همکاری مشاور تحلیلی، جیسون پکر، این موضوع را بررسی کردیم. دلیل آن، یک باگ در کادر جستجوی ChatGPT بود که باعث می شد تقریباً هر بار جستجو انجام شود و گوگل آن را به عنوان یک پرس وجو شناسایی (Tokenize) کند. نتیجه این بود که صاحبان وب سایت ها، پرامپت های خصوصی افراد غریبه را در داشبورد خود می دیدند. نگرانی من در آن زمان این بود که این نشت داده ها، باعث ایجاد الگوی «دهان کروکودیلی» در سرچ کنسول می شود (جایی که تعداد ایمپرشن ها به شدت بالا می رود اما کلیک ها کاهش می یابد).
این نشت، فقط بخش قابل مشاهده ی مشکلی بود که اکنون همه جا هست. سیستم های هوش مصنوعی دائماً به گوگل ضربه می زنند تا پاسخ های خود را مستند کنند؛ آن ها یک پرامپت واحد را به چندین پرس وجوی موازی تقسیم می کنند و نتایجی را می خوانند که هیچ انسانی هرگز نمی بیند. هر یک از این جستجوها به عنوان یک «ایمپرشن» در صفحاتی که برای آن عبارت رتبه دارند، ثبت می شود. بنابراین وقتی می بینید ایمپرشن های شما بالا می رود اما کلیک ها نه، این به معنای افزایش تقاضای واقعی انسان ها نیست. بخش بزرگی از آن، ماشین هایی هستند که به جای کاربر جستجو می کنند و پاسخ را بدون کلیک کردن، مصرف می کنند. شما می توانید همین تحریف را در داده های روند جستجو (Search Trends) ببینید؛ جایی که نمودارها بالا می روند اما دیگر به شما نمی گویند چه بخشی از این تقاضا انسانی است. سرچ کنسول دیگر مکان قابل اعتمادی برای خواندن رفتار هوش مصنوعی نیست و اکثر ابزارهایی که مردم به سراغشان می روند، عددی را اندازه می گیرند که هوش مصنوعی در حال باد کردن آن است.
در دنیای سئو مدرن، اتکا به داده های سرچ کنسول به تنهایی کافی نیست. ما در «دانش وب» با تلفیق داده های سرچ کنسول و ابزارهای تحلیل رفتار هوش مصنوعی، به شما کمک می کنیم ترافیک واقعی را از ترافیک ناشی از فعالیت ربات ها تفکیک کنید.
«ذکر شدن» به معنای «توصیه شدن» نیست
مهم ترین تمایز در اندازه گیری جستجوی هوش مصنوعی این است: نقل قول (Citation) با توصیه (Recommendation) یکی نیست.
- نقل قول: زمانی است که مدل، صفحه شما را به عنوان یک منبع در انتهای پاسخ ذکر می کند.
- توصیه: زمانی است که مدل به کاربر می گوید شما را انتخاب کند.
بیشتر ابزارها مورد اول را می شمارند و به شما القا می کنند که به معنای مورد دوم است؛ اما اصلاً این طور نیست.
لیلی ری (Lily Ray) پاسخ های هوش مصنوعی را برای ۱۰۰ جستجوی «بهترین نرم افزارهای تجاری» در بازه های زمانی مختلف بررسی کرد. وقتی لیست های تبلیغاتی خودِ یک برند به عنوان منبع ذکر می شد، آن برند در ۶۹٪ مواقع در «توصیه نهایی» هوش مصنوعی غایب بود! گوگل صفحه را می خواند، اما در نهایت رقبای ذکر شده در همان صفحه را به کاربر پیشنهاد می داد. تیم Visibility Labs نیز با آزمایش ۲۰ هزار پاسخ ChatGPT دریافت که توصیه محصولات پس از فعال سازی جستجو، ۸۰.۲٪ تغییر می کند و همبستگی بین ذکر شدن و توصیه شدن فقط ۰.۴٪ است.
آلیسا شارف، مدیر ارشد هوش مصنوعی در Seer Interactive، می گوید: «نقل قول ها حتی معیار بدتری نسبت به حضور در صفحه اول گوگل هستند. ما این ها را به عنوان یک شاخص پیشرو در نظر می گیریم، چیزی شبیه به حضور در صفحه دو یا سه گوگل. تفاوت اینجاست: در نقل قول، وب سایت شما ذکر می شود، اما در توصیه، هوش مصنوعی مشخصاً می گوید که “شما باید با فلان برند کار کنید”. آن مرحله آخر (توصیه)، همان جایی است که پول در آن نهفته است.»
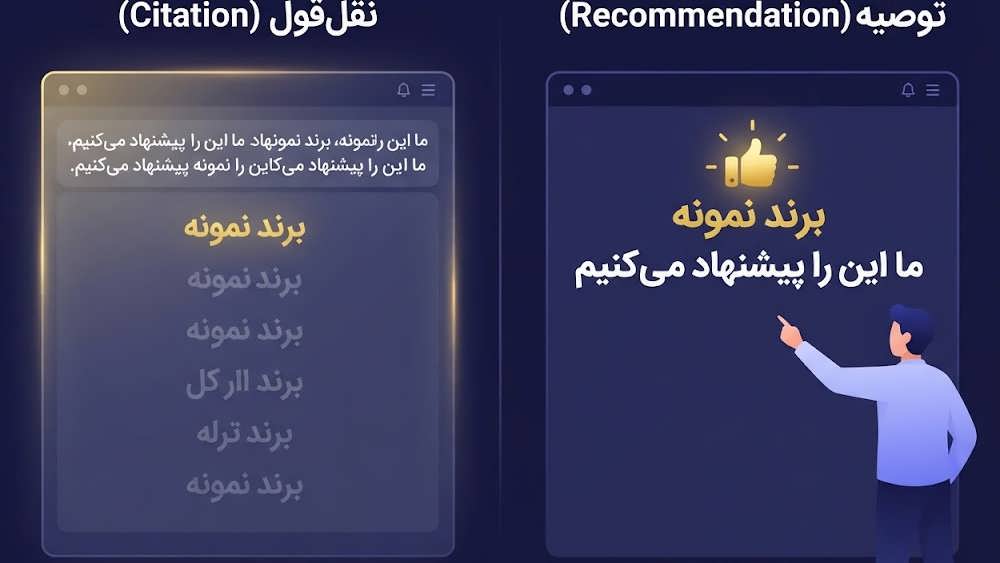
این اینفوگرافیک تفاوت بین ذکر شدن نام برند در یک لیست (نقل قول) و پیشنهاد مستقیم هوش مصنوعی برای انتخاب آن برند (توصیه) را با هایلایت طلایی نشان می دهد
یک بار بپرسید، نویز اندازه گیری می کنید
یک بار اندازه گیری پاسخ هوش مصنوعی تقریباً بی ارزش است، چون پاسخ هر بار متفاوت است. رند فیشکین (Rand Fishkin)، مؤسس شرکت تحقیقاتی SparkToro، این موضوع را با تحقیق خود ثابت کرد: «شما با پرسیدن، یک پاسخ دریافت نمی کنید؛ بلکه یکی از هزاران یا میلیون ها پاسخ احتمالی را دریافت می کنید. هر فردی که سؤال کند، لیست متفاوتی از برندها، تعداد متفاوتی از گزینه ها و ترتیب متفاوتی دریافت می کند.»
او می گوید برای اینکه دو لیست کاملاً مشابه از برندها در پاسخ هوش مصنوعی بگیرید، باید به طور میانگین ۱۵۰۰ بار از Claude یا ChatGPT سؤال کنید!
بنابراین، مسئله این نیست که دیده شدن در هوش مصنوعی غیرقابل اندازه گیری است؛ بلکه مسئله این است که باید آن را مانند «نظرسنجی آماری» اندازه گیری کرد، نه «رصد رتبه». اگر پرامپت های مناسب را تعداد دفعات کافی و با تنوع بپرسید، می توانید به یک عدد آماری دقیق برسید. مشکل ابزارهای موجود این است که یک بار تست می کنند و نتیجه را به عنوان «رتبه» گزارش می دهند.
چه چیزی را به جای آن اندازه بگیریم: حضور و سهم توصیه
عددی که باید جایگزین ردیابی پرامپت شود، «حضور» (Presence) است: برند شما چند بار در فضای پاسخ دهی نام برده شده است؟ آیا این حضور به توصیه و عمل (Action) تبدیل می شود؟
رند فیشکین معتقد است: «درصدِ دیده شدن، تنها عدد صادقانه ای است که یک ابزار ردیابی هوش مصنوعی باید به شما بدهد. این شبیه به رصد رتبه گوگل نیست؛ بیشتر شبیه به این است که برندها در قرن بیستم از مشتریان نظرسنجی می کردند که “آیا نام نایکی را شنیده اید؟ آیا نام آدیداس را شنیده اید؟”»
نکته حیاتی که ویل رینولدز به آن اشاره می کند این است: «اگر شما دیده شدن را ردیابی می کنید اما معیارهایی مثل تعداد کلمات یا برندهای ذکر شده در هر پاسخ را در طول زمان دنبال نمی کنید، متوجه نخواهید شد که مثلاً ChatGPT طول پاسخ هایش را دو برابر کرده است. وقتی طول پاسخ دو برابر می شود، دیده شدن خام شما بالا می رود در حالی که هیچ اتفاق واقعی نیفتاده است.»
(پیشنهاد دانش وب: ما در پروژه های سئو خود، به جای تمرکز بر رتبه های کاذب، بر افزایش «سهم توصیه» (Recommendation Share) شما در مدل های زبانی تمرکز می کنیم تا مشتریان واقعی شما را در لحظه تصمیم گیری انتخاب کنند.)
بر «دقت برند» (Brand Accuracy) تمرکز کنید
اولین معیاری که باید بسازید، «دقت برند» است: آیا هوش مصنوعی موجودیت شما را درست توصیف می کند؟ سهم توصیه در مرحله بعد قرار می گیرد. اگر مدل حقایق اشتباهی درباره شما داشته باشد، تمام اعداد بعدی روی شن ساخته شده اند، زیرا هوش مصنوعی در حال توصیه (یا عدم توصیه) نسخه ای از شماست که واقعی نیست.
دواین فارستر (یکی از بنیان گذاران Schema.org) می گوید: «هدف شما باید این باشد که به عنوان “منبع قابل اعتماد” (Canonical) شناخته شوید، نه فقط کسی که رتبه بالایی دارد. هزینه کردن برای ایجاد اعتماد زمان بر است، اما اگر هوش مصنوعی به شما اعتماد کند، دلیلی ندارد شما را تغییر دهد.»
آلیسا شارف این را به یک ممیزی واقعی تبدیل کرده است: «لیستی از معیارهای عینی تهیه کنید. این نباید “رتبه گیری برای کلمه کلیدی X” باشد؛ بلکه باید این باشد: چه زمانی تأسیس شدید؟ کجا مستقر هستید؟ چه چیزی می فروشید؟ رقبای شما کیستند؟ این لیست را در هر موتور جستجو امتحان کنید و ببینید مدل در هر بار بررسی، چه چیزی را درست و چه چیزی را غلط متوجه می شود.»
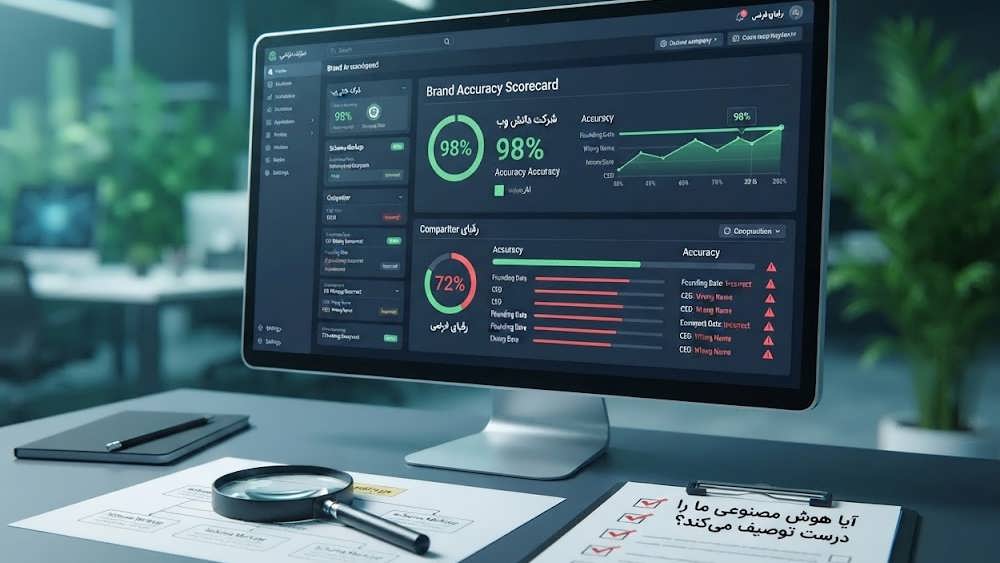
نمایی از یک داشبورد ممیزی دقیق که معیارهای عینی مانند تاریخ تأسیس، مکان و محصولات برند را برای بررسی صحت دانش هوش مصنوعی ارزیابی می کند
دو نقطه کور: تاریخ آموزش و داده های پلتفرم
اندازه گیری صادقانه باید نقاط کور خود را بشناسد:
۱. تاریخ انقضای داده های آموزش (Training Cutoff): بخشی از پاسخ های مدل از داده هایی می آید که قبل از اتصال به اینترنت یاد گرفته است (مدل های منجمد). ما هنوز راه تمیزی نداریم که بفهمیم آیا کارهای سئوی امروز ما، تأثیری بر آن دانش های نهادینه شده دارند یا خیر.
۲. داده های پلتفرم: شرکت های مدل های زبانی (مانند OpenAI یا Anthropic) انگیزه ای ندارند که داده های استفاده را به شما بدهند. گوگل و مایکروسافت در حال حاضر داده های اندکی را از طریق ابزارهای خود در اختیار می گذارند که باز هم بهتر از هیچی است.
خودتان را بشناسید و شفاف باشید
آیا می دانید چه کسی هستید و می خواهید مردم چه تصوری از شما داشته باشند؟ آیا این پیام را در مکان های مختلف به اندازه کافی شفاف منتقل کرده اید که سیستم های هوش مصنوعی بتوانند تصویری دقیق (و نه حدسی) از شما بسازند؟
شفاف و ثابت قدم باشید. این کار شاید ساده به نظر برسد، اما تمام اسکیماها (Schema)، صفحات سایت، پروفایل های اجتماعی و هر جایی که نام شما ذکر می شود، باید دقیقاً یک پیام واحد درباره اینکه شما چه کسی هستید و چه می کنید، داشته باشند.
یک نکته تکان دهنده: اخیراً دادگاهی در آلمان گوگل را مسئول اظهارات نادرست هوش مصنوعی اش درباره یک کسب وکار دانست. این یعنی پلتفرم هایی که از نظر قانونی بابت حرف های هوش مصنوعی شان مسئول هستند، انگیزه ای قوی دارند که فقط برندهایی را نمایش دهند که از “هویت” آن ها اطمینان ۱۰۰٪ دارند. پس شاید مهم ترین چیزی که باید اندازه بگیرید این نیست که چند بار نمایش داده می شوید؛ بلکه این است که هوش مصنوعی چقدر مطمئن است که شما را می شناسد. این قطعیت، تعیین کننده اصلی حضور شما در آینده است.
نتیجه گیری
در دنیای سئو عصر هوش مصنوعی، دوران تعقیب و گریز اعداد پوچ (Vanity Metrics) به پایان رسیده است. اینکه صرفاً در خروجی های هوش مصنوعی «دیده شوید»، گارانتی کننده فروش یا رشد شما نیست. استراتژی موفق، گذر از ردیابی پرامپت های سطحی به سمت «مدیریت موجودیت» (Entity Management) و «برندینگ دیجیتال» است. شما باید با ساختاردهی صحیح داده ها (Schema)، ثبات در هویت برند و تولید محتوای تخصصی که اعتماد موتورهای جستجو را جلب می کند، جایگاه خود را به عنوان «منبع مرجع» تثبیت کنید. در «دانش وب»، ما با تکیه بر همین رویکردِ داده محور و استراتژی های نوین سئو، به کسب وکارها کمک می کنیم تا نه تنها در نتایج سنتی، بلکه به عنوان «انتخاب اول» در پاسخ های هوش مصنوعی ظاهر شوند.