

اثر انگشتی که فعالیت های سئوی شما از خود به جا گذاشته، با ظهور «موتورهای پاسخگو» (Answer Engines) ناپدید نشده است؛ اما اینکه این اثر تا چه حد عمیق در سیستم ها ذخیره می شود یا اصلاً ذخیره می شود یا خیر، همچنان در هاله ای از ابهام قرار دارد.
هر وب سایتی که تا به حال برای آن «بهینه سازی» (SEO) انجام داده اید، ردپایی از آن فعالیت ها را با خود حمل می کند؛ ردپایی که بسیار دقیق تر و مفصل تر از آن چیزی است که پلتفرم ها معمولاً به آن اعتراف می کنند.
موتورهای جستجو سال هاست که یک «پروفایل دامنه ای» (Per-domain Profile) برای هر سایت نگه می دارند. این پروفایل از سیگنال هایی ساخته شده که شما به خوبی با آن ها آشنا هستید، چرا که تمام دوران حرفه ای خود را صرف شکل دهی به آن ها کرده اید. این پروفایل کاملاً واقعی و جزئی نگر است و نیازی به نام گذاری نداشته، چرا که تماماً در دلِ موتور جستجو زندگی می کرده است؛ جایی که می توانستید تأثیرات آن را در رتبه بندی ها ببینید و مستقیماً روی آن ها کار کنید.
اما پرسشی که نمی توانم پاسخ قطعی برای آن بدهم (و هیچ کس دیگری که ادعای دانستن آن را دارد هم نمی تواند)، این است: وقتی جستجو دیگر «مقصد» نیست و تبدیل به «زیرلایه» برای یک موتور پاسخگو می شود، آیا آن سوابق نیز همراه با آن منتقل می شوند؟ آیا اثر انگشتی که در طول سال ها بر سیستم های گوگل حک کرده اید، توسط سیستم هایی که اکنون بر پایه همان ها پاسخ تولید می کنند، به ارث می رسد؟ و اگر چنین است، آیا اصلاً راهی برای ویرایش یا تغییر آن وجود دارد؟
این تمامِ ماجراست. این یک چک لیست ساده نیست، بلکه یک «پرسش سیستمی» بسیار جدی است؛ زیرا پاسخ صادقانه به آن بسته به اینکه درباره کدام سیستم صحبت می کنید تغییر می کند و در یک مورد خاص، هیچ کس خارج از آزمایشگاه های توسعه دهنده، واقعاً پاسخ را نمی داند.
سوابق انتزاعی نیستند
اگر ابهام را کنار بزنیم، اثر انگشت سئو مجموعه ای از موارد قابل شمارش است:
- در بخش لینک ها: حجم لینک های ورودی، سرعت دریافت آن ها (Velocity)، تنوع دامنه های ارجاع دهنده و توزیع «انکر تکست ها».
- در بخش داخلی: عمق کلیک (Click Depth)، ساختار خوشه ای (Hub-and-Spoke) توزیع اعتبار و صفحات یتیمی (Orphan Pages) که هرگز پاکسازی نکرده اید.
- در بخش فنی: تصویر لحظه ای از Core Web Vitals (شامل LCP، INP و CLS) که بر پایه رندرینگ موبایل و HTTPS قرار دارد.
- در بخش محتوا و اعتماد: سیگنال های E-E-A-T (تجربه، تخصص، اعتبار و اعتماد) که در دستورالعمل های ارزیابان کیفیت گوگل تعریف شده است. این یعنی نویسندگی مشخص، مدارک معتبر، رفتار ارجاع دهی و شفافیت صفحات «درباره ما» و «تماس با ما».
- در بخش ساختار: قدمت دامنه، تازگی محتوا، فواصل به روزرسانی و اینکه خزنده (Crawler) چقدر برای سر زدن به شما مشتاق است. همچنین ساختار سایت، پوشش اسکیما (Schema) و انضباط در تگ های کاننیکال.
این ها مکانیسم های جدیدی نیستند؛ این ها همان پروفایل ثبت شده ای هستند که صنعت سئو بیش از ۱۵ سال است بر اساس آن بهینه سازی انجام می دهد.
در بیشتر تاریخِ این حرفه، بحثِ «پایداری» (Persistence) موضوعی پیش پاافتاده بود، چون سوابق در یک مکان ذخیره می شد و تنها در یک خروجی (لیست رتبه بندی) خود را نشان می داد. شما بهینه سازی می کردید، سیستم ها ثبت می کردند، رتبه ها جابه جا می شد و اگر مسیر را تغییر می دادید، سوابق آپدیت می شدند. حلقه بازخورد مشخص بود. چیزی که این شفافیت را از بین می برد، ظهور «لایه خروجی دوم» یعنی پاسخ های تولیدشده (AI Overviews) است که روی همان پروفایل قدیمی نشسته و به روش هایی که شما نمی توانید نظارت کنید، از آن برداشت می کند.
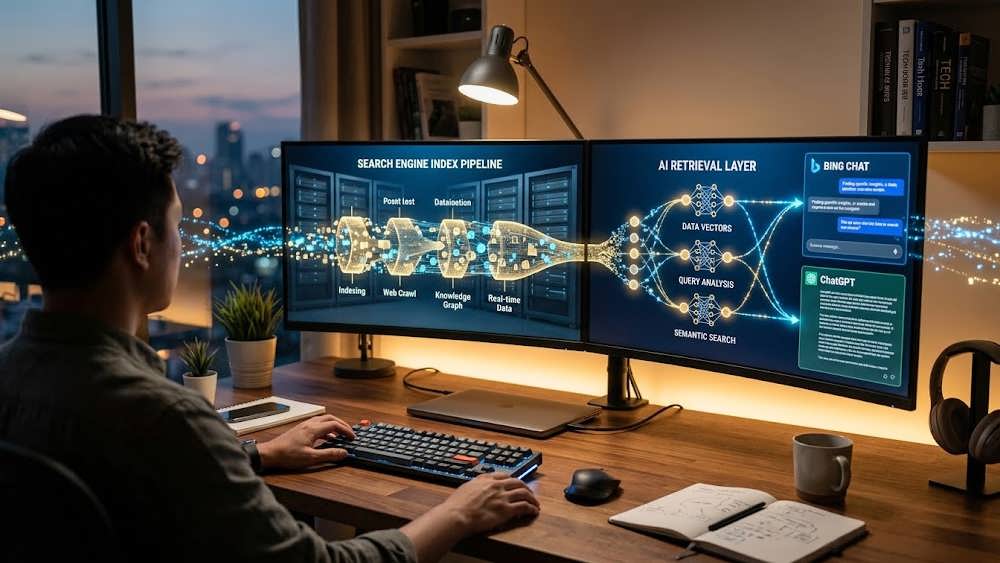
تصویری مبتنی بر جریان داده که نحوه متصل شدن خطوط لوله ایندکس موتورهای جستجو (مانند گوگل و بینگ) به مدل های زبانی هوش مصنوعی (مانند ChatGPT) را به صورت شفاف و چشم نواز نشان می دهد.
گوگل، میراث دارِ خودش است
بیایید با سیستمی شروع کنیم که پاسخ در آن شفاف تر است: گوگل. ویژگی های هوش مصنوعی گوگل یک موتور جداگانه نیستند که به بدنه جستجو پیچ شده باشند. «حالت هوش مصنوعی» (AI Mode) ریشه در سیستم های اصلی کیفیت و رتبه بندی گوگل دارد. پاسخ های هوش مصنوعی (AI Overviews) از همان سیستم های اصلی که لینک های آبی را تولید می کردند تغذیه می شوند و فقط توسط مدل Gemini پردازش می شوند. بنابراین، پروفایلِ ثبت شده ی دامنه شما هر ارزشی در رتبه بندی داشته باشد، همان پروفایل است که به پاسخ های تولیدشده هوش مصنوعی نیز سوخت رسانی می کند.
در بحث پایداریِ این اثر انگشت، گوگل صراحتاً صحبت می کند. در شفاف سازیِ «سیاست سوءاستفاده از شهرت سایت» (Site Reputation Abuse)، گوگل توضیح داد که سیستم هایی دارد که ارزیابی می کنند آیا یک بخش از سایت مستقل است یا با محتوای اصلی تفاوت فاحش دارد. این یعنی اعتبار سایت به صورت یک عدد کلی برای کل دامنه نگه داشته نمی شود، بلکه در سطوح جزئی تری (بخش بندی شده) ارزیابی می شود. این همان تعریف پایداری است که توسط خودِ گوگل ارائه شده است.
اینجا جایی است که بدبینی ها شروع می شود
واکنش منطقی به این موضوع این است که گوگل دائماً به ما می گوید «سئوی خوب، تنها چیزی است که برای سئوی مبتنی بر هوش مصنوعی نیاز دارید»، چون این ادعا به نفع خودِ گوگل است. و این حقیقت دارد؛ این توصیه برای استکِ (Stack) تکنولوژی خاصِ گوگل صادق است، اما لزوماً در پلتفرم های دیگر صدق نمی کند. گوگل به این دلیل می تواند ادعا کند که کارهای سئوی شما در سطوح هوش مصنوعی اش منعکس می شود، چون آن ها یکپارچگی عمودی (Vertical Integration) کاملی دارند: ایندکس، سیستم های رتبه بندی، مدل هوش مصنوعی و رابط کاربری، همگی متعلق به یک خانواده و دارای لوله کشی یکسان هستند.
مایکروسافت و بیانِ واقعیت
مایکروسافت در این داستان موقعیت عجیبی دارد؛ هم به شدت یکپارچه است و هم در مورد ساختار فنی اش به شکل غیرمعمولی شفاف. ایندکسِ مایکروسافت زیربنای موتور جستجوی Bing است. برخلاف دیگران، مایکروسافت در دو سال اخیر مستندات زیادی درباره چگونگی حرکت ماشین آلاتش منتشر کرده است. نمونه بارز آن پروتکل IndexNow است که به سایت ها اجازه می دهد سیگنال های تازه و کشف شدنی را مستقیماً به ایندکس بفرستند.
موضوع مهم در اینجا «Web IQ» است؛ سیگنالی که مایکروسافت در کنفرانس Build معرفی کرد و توضیح می دهد که چگونه وب را در زیرلایه تجربیاتِ پاسخگو درک و امتیازدهی می کند. نکته اینجاست: مانند گوگل، مایکروسافت هم دارای یکپارچگی لازم است تا سوابق دامنه شما به هوش مصنوعی اش منتقل شود و برخلاف بسیاری دیگر، تا حد زیادی به شما می گوید که این اتفاق می افتد.
طراحی جذاب و مدرن که هوش مصنوعی، مغز دیجیتال، رتبه بندی های سئو و مفهوم «اثر انگشت پایدار» دامنه را در یک قالب یکپارچه و هوشمند به نمایش می گذارد.
ChatGPT؛ جایی که چراغ ها خاموش است
رفتار جستجوی ChatGPT عمدتاً بر پایه ایندکسِ Bing است. بنابراین، «وبِ ثبت شده» توسط مایکروسافت، بخشی از چیزی است که به پاسخ های OpenAI می رسد. اما چیزی که اثبات نشده (و هیچ کس نمی تواند با اطمینان بگوید) این است که آیا یک اثر انگشت پایدار برای هر دامنه در سمت OpenAI نیز ذخیره و انباشته می شود، یا هر پاسخ به صورت «تازه» (Fresh) از طریق بازیابی اطلاعات (Retrieval) ساخته می شود و هیچ سابقه پایداری از دامنه شما در سیستم باقی نمی ماند؟
اینجا با یک فضای کاملاً مبهم روبرو هستیم. برخلاف گوگل، OpenAI مستنداتی درباره لایه «اعتبار دامنه ای» ارائه نمی دهد. بنابراین، مسیر دومِ یکپارچه (Bing به ChatGPT) به ما می گوید که سوابق شما وارد خط لوله می شود، اما پس از آن از دید خارج می شود.
آیا مدل ها «حافظه» دارند؟
فراتر از ایندکسِ جستجو، یک احتمال با پیامدهای بزرگ تر وجود دارد: اینکه خودِ مدل های زبانی (بدون وابستگی به ایندکس جستجو)، اثر انگشت دامنه ای خاص خود را جمع آوری کنند؛ یعنی یک «درکِ یادگرفته شده» از اینکه دامنه شما چیست و چقدر قابل اعتماد است. این حافظه در «وزن های» (Weights) مدل حمل می شود، نه در لایه بازیابی.
باید شفاف بگویم: هیچ شواهد عمومی و تمیزی وجود ندارد که ثابت کند یک اثر انگشتِ بومی در سطح دامنه، درون مدل ها (مانند سیستم های رتبه بندی) جمع آوری می شود. این موضوع بر اساس اصول اولیه «پذیرفتنی» است (چون آشنایی با موجودیت ها باید جایی ذخیره شود)، اما «پذیرفتنی بودن» به معنای «اثبات شده بودن» نیست.
نتیجه گیری
در اینجا به یک جمع بندی کاربردی می رسیم. سوابق شما در استکِ گوگل و بینگ، به صورت اثبات پذیر و خوانا «پایدار» می ماند. در مسیر Bing-to-ChatGPT، این سوابق وارد شده و سپس در تاریکی فرو می روند.
توصیه عملیاتی: به جای تعقیبِ یک «اثر انگشت» نامرئی، روی کارهایی تمرکز کنید که در تمام سطوح ارزش ایجاد می کنند. اگر شما روی اصول زیربنایی سئو (مانند آنچه متخصصان دانش وب در پروژه های بهینه سازی پیاده سازی می کنند) تمرکز کنید، اثر آن در تمام سطوح (چه موتور جستجوی سنتی و چه موتور پاسخگو) منعکس خواهد شد.
هرچه سوابق شما عمیق تر و ساختاری تر باشد، تغییرات سطحی کمتر روی آن اثر می گذارد. به همین دلیل است که امروزه مدیریت سئو دیگر صرفاً با «نگاه کردن به رتبه ها» ممکن نیست. شما باید ببینید که دامنه شما در طول زمان، چگونه در این سطوح مختلفِ هوش مصنوعی بازنمایی و استناد می شود.