

در چند سال گذشته، موضوع «رویت پذیری در هوش مصنوعی» (AI Visibility) بر بحث های سئو سایه افکنده است. تیم های سئو کدهای سایت را پاکسازی کرده و محتوا را به بخش های کوچکتر (Chunking) تقسیم کرده اند تا ربات های هوش مصنوعی بتوانند راحت تر به آن ها دسترسی پیدا کرده و آن ها را هضم کنند. اگر برند شما اخیراً توانسته در پاسخ های تولید شده توسط هوش مصنوعی (مثل AI Overviews گوگل) به طور منظم به عنوان منبع ذکر شود، حق دارید فکر کنید که نبرد برای دیده شدن در هوش مصنوعی را تقریباً برده اید.
هیچ کدام از این کارها اشتباه نیست و هیچ تلاشی به هدر نرفته است؛ اما این تمام ماجرا نیست!
بررسی های جامع ما روی ۵۰ وب سایت مطرح نشان داد در حالی که اکثر آن ها کار را برای پیدا شدن توسط هوش مصنوعی آسان کرده اند، اما تقریباً هیچ کدام شرایطی را فراهم نکرده اند که هوش مصنوعی بتواند آن ها را عمیقاً درک کند. بدتر از آن، نزدیک به دو سوم این سایت ها، موضوعِ حیاتیِ «دسترسی ربات های مختلف هوش مصنوعی به محتوا» را کاملاً به شانس واگذار کرده اند.
۳ لایه رویت پذیری در هوش مصنوعی (AI Visibility)
اگر از یک تیم مارکتینگ بخواهید «دیده شدن در هوش مصنوعی» را تعریف کند، احتمالاً پاسخ آن ها روی منشن ها (اشاره به نام برند) و سایتِیشن ها (ارجاع دادن به لینک سایت) متمرکز خواهد بود. یعنی اگر شخصی از پلتفرم های پیشرو هوش مصنوعی سوالی مرتبط با حوزه کاری شما بپرسد، انتظار دارید شانس حضور برند یا محصولتان در پاسخِ ارائه شده بالاتر از حد میانگین باشد.
تعریف رویت پذیری هوش مصنوعی صرفاً بر اساس منشن و لینک دهی، در واقع همان تفکر قدیمی سئو (رتبه بگیر، پیدا شو، کلیک بگیر) است که حالا به شکل جدید و بسیار متفاوتی از جستجو منتقل شده است. اما دیده شدن در هوش مصنوعی فقط این نیست که برند، محصول و لینک های شما در مقابل چشمان مخاطب هدف قرار بگیرد؛ بلکه موضوع اصلی این است که هوش مصنوعی چگونه اطلاعات شما را می فهمد و با وب سایتتان تعامل می کند.
برای درک بهتر، فرایند یادگیری یک کودک در دوران ابتدایی را در نظر بگیرید. آموزش خواندن به کودک با آموزش درک مطلب به او یکسان نیست. یک کودک شش ساله که در حال یادگیری حروف الفباست، ممکن است کلمات کتاب داستانش را نسبتاً روان بخواند (آفرین، او مستحق یک تکه بیسکویت است!). اما اگر از او بپرسید دقیقاً چه چیزی خوانده است، متوجه می شوید که درک او از مفهوم متن بسیار کمتر از آن چیزی است که فکر می کردید.
زمانی که کودک هم در «خواندن» و هم در «درک مطلب» مهارت پیدا کرد، می تواند آنچه یاد گرفته را عملی کند؛ مثلاً از روی یک دستور پخت غذا درست کند، داستان یا انشای خودش را بنویسد، یا برای یافتن پاسخ سوالاتی که از متن اولیه در ذهنش ایجاد شده، تحقیقات بیشتری انجام دهد.
بنابراین، «خواندن» تنها یک قدم به سوی «درک کردن» است. و «درک کردن» نیز تنها یک قدم به سوی «عاملیت و اقدام» (Agency) است؛ یعنی وقتی اطلاعات را به دست آوردید، تصمیم بگیرید با آن چه کار کنید.
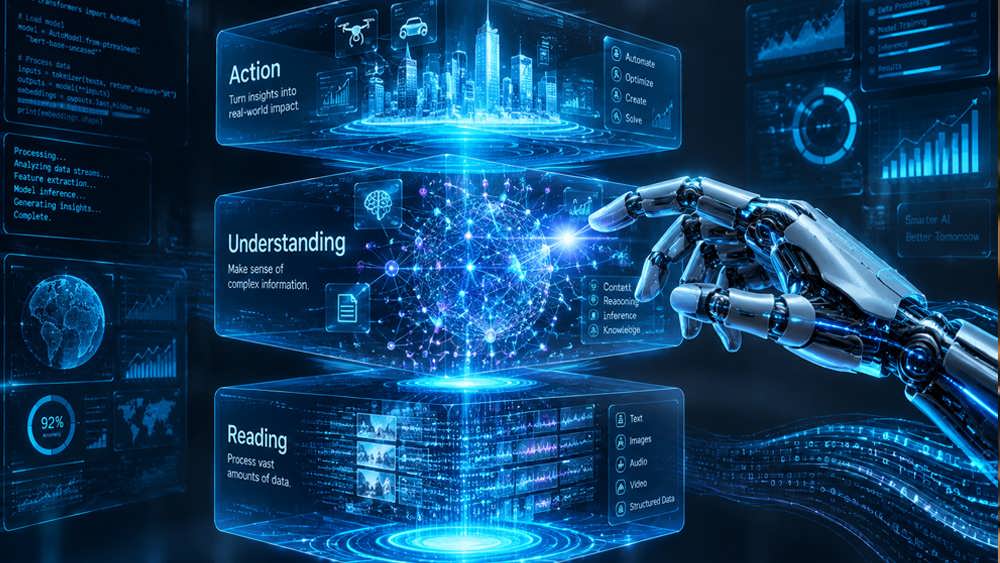
ربات های هوش مصنوعی برای تعامل با سایت شما باید از سه مرحله «خواندن»، «درک کردن» و در نهایت «اقدام و عاملیت» عبور کنند.
به همین دلیل است که ما یک چارچوب ممیزی (Audit Framework) برای بررسی میزان آمادگی سایت ها در برابر هوش مصنوعی طراحی کرده ایم که شامل سه لایه مجزا است:
۱. قابلیت بازیابی (Retrievability)
آیا هوش مصنوعی می تواند بدون مشکل، محتوای شما را واکشی و تجزیه (Parse) کند؟
این همان بخشِ «خواندن» است؛ لایه پایه ای که اکثر تیم های سئو از قبل برای آن بهینه سازی می کنند و مستقیماً با دیده شدن در هوش مصنوعی (به معنای ارجاعات و ذکر نام برند) ارتباط دارد.
ما در تیم تخصصی دانش وب همواره تاکید می کنیم که پیش از هرگونه اقدام روی محتوا یا استراتژی های پیشرفته، باید زیرساخت های تکنیکال سایت (مانند کدهای تمیز و ساختاریافته) را به عنوان اولین قدم سئو پیاده سازی کرد تا ربات ها در مرحله بازیابی اطلاعات دچار لغزش نشوند. اما اگر برای لایه دوم بهینه سازی نکنید، اساساً فقط باید انگشتانتان را به هم گره بزنید و دعا کنید که هوش مصنوعی محتوای شما را درست تفسیر کند!
۲. تخصیص و درک معنا (Attribution And Meaning)
آیا هوش مصنوعی می تواند تشخیص دهد صفحات شما درباره چه چیزی هستند و به چه کسی تعلق دارند؟
این لایه نشان می دهد که هوش مصنوعی چگونه بدون حدس زدن متوجه می شود کدام عدد در صفحه شما قیمت اصلی محصول است و کدام عدد تخفیف ویژه ای است که فقط برای مشتریان وفادار در نظر گرفته شده است. این لایه به هوش مصنوعی می فهماند که صاحب برند یا نویسنده واقعی چه کسی است و آیا باید او را به عنوان یک مرجع معتبر در آن موضوع در نظر بگیرد یا خیر. همچنین به هوش مصنوعی کمک می کند تفاوت بین مقاله ای درباره «خودروی جگوار» و مقاله ای درباره باشگاه های فوتبال با نام «جگوار» را درک کند.
اینکه به هوش مصنوعی اطمینان بیشتری بدهید که محتوایتان را درست تفسیر کرده است، دو فایده دارد: اولاً احتمال ارجاع به محتوای شما در پاسخ های مرتبط هوش مصنوعی را افزایش می دهد و ثانیاً خطرِ ارائه اطلاعات غلط (Hallucination یا توهم هوش مصنوعی) درباره برند، محصولات یا ادعاهای شما را به شدت کاهش می دهد.
۳. تراکنش و کشف توسط عوامل هوشمند (Agent Transaction And Discovery)
آیا عوامل هوش مصنوعی (AI Agents) می توانند برای انجام وظایفی مانند تکمیل فرایند خرید، به قابلیت های وب سایت شما دسترسی داشته باشند؟
این لایه نهایی مربوط به «عاملیت» است و تفاوت بین زمانی که هوش مصنوعی صرفاً اطلاعات شما را مانند طوطی برای کاربر تکرار می کند، با زمانی که می تواند از طرف کاربر مستقیماً با کسب وکار شما تعامل کرده و تراکنشی را ثبت کند، مشخص می سازد.
ما در هر یک از این لایه ها، پروتکل های احتمالی که تیم های سئو ممکن است برای رسیدن به این نتایج اجرا کنند را دسته بندی کردیم. به عنوان مثال، استفاده از برچسب های ARIA یا گنجاندن دستورات مربوط به ربات های هوش مصنوعی (AI user-agent) در فایل robots.txt عمدتاً به «لایه اول: قابلیت بازیابی» مربوط می شود، در حالی که وجود نقشه موجودیت ها (Entity Map) یا اسکیما مارک آپ (JSON-LD) به «لایه دوم: تخصیص و درک معنا» ارتباط دارد.
در مجموع، چارچوب ما شامل ۲۷ عنصر ممیزی است (۱۱ مورد در لایه اول، ۳ مورد در لایه دوم و ۱۳ مورد در لایه سوم) که بر اساس میزان بلوغ آن ها به عنوان استانداردهای فعلی صنعت، امتیازدهی شده اند:
- تثبیت شده (Established): استانداردهای آماده و کاربردی که امروزه به طور فعال استفاده می شوند.
- نوظهور (Emerging): پروتکل های واقعی که توسط پیشگامان در حال استفاده است و به سرعت در حال رشد هستند.
- پیشرو/مرز دانش (Frontier): استانداردهایی که هنوز در حال بحث هستند و تا این لحظه پیاده سازی قطعی و نهایی برای آن ها وجود ندارد.
با در دست داشتن این چارچوب، ما ۵۰ وب سایت بزرگ در حوزه های خرده فروشی، نرم افزار به عنوان سرویس (SaaS)، سفر و گردشگری، نشر و امور مالی را بررسی کردیم تا ببینیم رایج ترین شکاف ها در آمادگی برای هوش مصنوعی در کجا قرار دارند.
اعتراف می کنم که اعمال یک چارچوب و سیستم امتیازدهی یکسان برای کل این سایت ها، صرف نظر از نوع صنعت و مدل کسب وکارشان، کمی بی انصافی است. زمانی که ما از این چارچوب برای سنجش آمادگی سایتِ مشتریان خود استفاده می کنیم، امتیازات را بر اساس صنعتِ خاصِ آن ها وزن دهی می کنیم. اما در اینجا، هدف برجسته کردن بزرگترین شکاف های کلی در سطح وب بود، نه حدس زدن ظرافت های تصمیمات تجاری هر سایت. گرفتن امتیاز پایین در این بررسی، لزوماً به این معنا نیست که یک سایت برای هوش مصنوعی آماده نیست؛ شاید آن ها آگاهانه و با استراتژی قبلی دسترسی ها را محدود کرده باشند.
بررسی ۵۰ وب سایت برتر نشان می دهد که اکثر سایت ها در لایه تکنیکال موفق بوده اند، اما در زمینه درک معنایی شکاف های جدی دارند.
داده ها چه چیزی را نشان می دهند؟
با استفاده از یک مرورگرِ ابزارگذاری شده (Instrumented Browser)، ما توانستیم پاسخ های زنده HTTP، ساختار رندر شده DOM، کدهای خام HTML سرور و نقاط پایانی (Endpoints) کشف ماشینی را ثبت کنیم. تمامی این داده ها در یک روز (۱۲ ژوئن ۲۰۲۶) جمع آوری شدند.
سپس ۱۲ سیگنال «تثبیت شده» را بر اساس چارچوب آمادگی سایت با امتیازهای (۰/۱/۲) بررسی کردیم و امتیاز نهایی به صورت درصدی از حداکثر امتیاز ممکن محاسبه شد. (پروتکل های نوظهور و پیشرو در این امتیازدهی لحاظ نشدند).
- بالاترین امتیاز: سایت Airbnb.com با ۷۹.۲٪
- میانگین: سایت ها به طور متوسط کمی بیشتر از نیمی از پروتکل های تثبیت شده را اجرا کرده بودند (میانگین ۵۶.۶٪، میانه ۵۸.۳٪).
- پایین ترین ها: تنها ۱۰ سایت امتیازی زیر ۵۰٪ کسب کردند.
شاید این آمار در نگاه اول شبیه به نمره قبولی باشد، اما اینطور نیست! وقتی این سه لایه را از هم جدا می کنید، کاملاً مشخص می شود که هنوز چقدر کار روی زمین مانده است.
۱. لایه قابلیت بازیابی (میانگین ۷۴.۴٪)
۸ عنصر از ۱۱ عنصر بررسی شده در این لایه، تثبیت شده بودند:
- دستورات فایل robots.txt برای ربات های AI
- یکپارچگی درخت دسترسی پذیری (Accessibility Tree)
- برچسب گذاری ARIA (کمک به درک بهتر عناصر سایت توسط ماشین) و نام گذاری های توصیفی
- استفاده از HTML معنایی (Semantic HTML) و سلسله مراتب اسناد
- تراکم DOM با بهره وری بالای توکن (Token-Efficient)
- ارائه HTML تمیز / رندر سمت سرور (Server-Rendered)
- قابلیت استفاده ماشین از فرم ها و فیلدهای ورودی
- تعریف سایت مپ (Sitemap)
این لایه بیشترین همپوشانی را با «سئوی تکنیکال سنتی» دارد؛ بنابراین بسیاری از این عناصر احتمالاً از قبل روی سایت ها پیاده سازی شده اند و بهینه سازی آن ها برای ربات های AI کار نسبتاً ساده ای است. جای تعجب نیست که اکثر سایت ها در این بخش عملکرد خوبی داشتند و تنها سه سایت امتیازی زیر ۵۰٪ گرفتند (که برای آن ها هم دلایل منطقی وجود داشت).
۲. لایه تخصیص و درک معنا (میانگین ۳۸.۵٪)
۲ عنصر از ۳ عنصر بررسی شده در این لایه، تثبیت شده بودند:
- اسکیما مارک آپ (JSON-LD) و غنای معنایی
- سیاست سیگنال های محتوایی (Content Signals Policy)
امتیازات در فاصله بین لایه اول تا لایه دوم به شدت اُفت می کنند.
خبر خوب این است که ما ساختار داده JSON-LD را در صفحه اصلی ۳۵ سایت از ۵۰ وب سایت (۷۰٪) تشخیص دادیم و به جز سه مورد، بقیه حداکثر امتیاز (۲ امتیاز) را گرفتند. اما خبر بد این است که نزدیک به یک سوم سایت ها از هیچ اسکیمایی استفاده نکرده بودند!
اسکیما بخشِ حیاتی در فرایندی است که به هوش مصنوعی می فهماند محتوای شما واقعاً به چه معناست (مثلاً: این یک محصول است، این قیمت آن است و این برندی است که آن را می فروشد). عدم وجود اسکیما یا اجرای ضعیف آن، شاید مانعِ «پیدا شدن» سایت شما نشود و مدل های زبانی (LLM) باز هم بهترین حدس خود را درباره محتوای شما بزنند؛ اما مشکل اینجاست که این «بهترین حدس» گاهی کاملاً اشتباه است و منجر به پاسخ های نادرست یا «توهمات هوش مصنوعی» (Hallucination) می شود.
نکته قابل تامل تر این است که تنها ۵ سایت از ۵۰ سایت بررسی شده، از سیاست سیگنال های محتوایی Cloudflare استفاده کرده اند. این سیاست، مجموعه ای از دستورالعمل ها در فایل robots.txt است که دقیقاً به خزنده ها می گوید مجازند با محتوای شما در رابطه با ایندکس جستجو، پاسخگویی زنده به سوالات کاربران در AI و همچنین «آموزش مدل های هوش مصنوعی» چه کنند. استفاده از این ویژگی به شما اجازه می دهد از رویکردِ صفر و صدیِ «مسدود کردن کل هوش مصنوعی» یا «اجازه دادن به کل هوش مصنوعی» فاصله بگیرید و استراتژی هوشمندانه تری اتخاذ کنید.
مسدود کردن یا باز گذاشتن دسترسی ربات های هوش مصنوعی در فایل robots.txt باید یک تصمیم کاملاً استراتژیک و مهندسی شده باشد، نه تصادفی.
۳. لایه تراکنش و کشف توسط عوامل هوشمند (میانگین ۲.۱٪)
۲ عنصر از ۱۳ عنصر بررسی شده در این لایه، تثبیت شده بودند:
- کشف OAuth (سرور احراز هویت)
- متادیتا منابع محافظت شده OAuth
مرورگرهای مبتنی بر عامل هوشمند (Agentic browsers) و تجارت مبتنی بر این عوامل (Agentic commerce) تازه از اواخر سال ۲۰۲۵ وارد میدان شده اند. در نتیجه، از بین ۱۳ پروتکلی که در این لایه شناسایی کردیم، تنها ۲ مورد در دسته استانداردهای «تثبیت شده» قرار گرفتند.
سایت های eBay و ویکی پدیا واکشی مستقیم (same-origin fetch) را مسدود کرده اند. اما از بین ۴۸ سایتی که امکان تستِ نقطه پایانی (Endpoint) آن ها وجود داشت، ۴۶ سایت امتیاز «صفر» گرفتند! سایت های Airbnb و Vercel متادیتای سرور احراز هویت OAuth را پیاده سازی کرده بودند، اما هیچکدام متادیتای منابع محافظت شده را نداشتند؛ به همین دلیل در لایه سوم فقط ۵۰٪ امتیاز گرفتند.
فناوری های کشف OAuth به هوش مصنوعی اجازه می دهند به طور ایمن با سایت شما تعامل کند. برای مثال، به اپلیکیشن هوش مصنوعی می گویند که دقیقاً اجازه دسترسی به چه چیزهایی را دارد، چگونه باید خود را احراز هویت کند و اطلاعات لازم برای ورود به APIهای محافظت شده را از کجا بیاورد.
با این حال، تیم ما به شدت در حال رصد ۹ عنصرِ «نوظهور» دیگر در لایه سوم است که می تواند این فضا را به سرعت متحول کند. برخی از آن ها به پروتکل بستر مدل (MCP) مربوط می شوند که به هوش مصنوعی اجازه می دهد مستقیماً از سرورهای شما کوئری (پرس وجو) بگیرد. مثلاً به جای اینکه AI اطلاعات را با سختی از صفحات محصول شما استخراج کند، مستقیماً به دیتابیس لحظه ایِ محصولات شما متصل می شود که این کار سرعت پردازش را بالا برده و خطای هوش مصنوعی را به صفر می رساند.
علاوه بر این، پروتکل های تجارت الکترونیک جدیدی مانند UCP گوگل و ACP شرکت OpenAI در راهند که به هوش مصنوعی اجازه می دهند تراکنش خرید را مستقیماً داخلِ صفحه چتِ هوش مصنوعی به پایان برسانند. این لایه دقیقاً همان جایی است که باید چشم از آن بر ندارید؛ برندهایی که زودتر در این زمینه آزمایش و ریسک کنند، دست برنده را خواهند داشت.
امتیاز پایین همیشه به معنای بد بودن نیست
من اصلاً پیشنهاد نمی کنم که هر کسب وکاری باید با چشمان بسته، مانند یک چک لیست تمام پروتکل های این چارچوب را برای هوش مصنوعی تیک بزند. اگرچه از نظر فنی ممکن است سایتی امتیاز ۱۰۰٪ بگیرد، اما این بدان معنا نیست که باید این کار را بکند.
برخی از سایت های خبری و نشریات در این بررسی (مثل BBC، CNN و The Guardian) عمداً اکثر (یا تمام) ربات های هوش مصنوعی را مسدود کرده اند. این کاملاً منطقی است؛ مدل کسب وکار آن ها به این وابسته است که افراد مستقیماً وارد سایتشان شوند تا اخبار را بخوانند.
در مقابل، صنایعی مثل خرده فروشی، SaaS، گردشگری و خدمات مالی به شدت به دسترسی به مشتریان و تاثیرگذاری بر تصمیمات آن ها در فضای هوش مصنوعی وابسته اند. هرچه مشتریان بیشتر به جای وب سایت ها، از طریق Agent های هوش مصنوعی با این کسب وکارها درگیر شوند، اهمیت هر سه لایه ذکر شده بیشتر می شود.
از طرفی، یکی از پایین ترین امتیازات کل این بررسی (۲۹.۲٪) متعلق به سایت آمازون (amazon.com) بود. اما من حتی یک لحظه هم فکر نمی کنم که آمازون از جستجوی هوش مصنوعی غافل شده باشد! آمازون هم مانند BBC دستورات دقیقی در سایت خود قرار داده تا جلوی دسترسی تقریباً تمام ربات های هوش مصنوعی را بگیرد. این یک انتخابِ کاملاً استراتژیک و مهندسی شده است.
در مقابل، سایت هایی مثل airbnb و cloudflare هیچ محدودیت کلی ای ندارند، اما قوانینِ دسترسیِ بسیار مشخصی برای تک تکِ ربات های معروفِ هوش مصنوعی وضع کرده اند. سایت هایی مثل eBay و Tripadvisor از این هم گزینشی تر عمل کرده اند؛ آن ها دقیقاً ربات هایی که می خواهند را باز گذاشته و مابقی را مسدود کرده اند. متخصصان ما در دانش وب همواره در استراتژی های سئو به مشتریان پیشنهاد می کنند که به جای مسدودسازی یا باز گذاشتنِ کورکورانه، یک فایل robots.txt هدفمند بر اساس نیاز کسب وکارشان طراحی کنند.
با این وجود، واقعیت تلخ این است که نزدیک به دو سوم سایت های بررسی شده (۲۹ از ۵۰)، به نظر می رسد هیچ تصمیم آگاهانه ای در مورد دسترسی ربات های هوش مصنوعی نگرفته اند. هیچ چیز مسدود نیست، هیچ چیز به طور صریح مجاز نیست و هیچ قانونی برای خزنده ها وجود ندارد. اینکه ربات های AI به چه چیزی دسترسی پیدا کنند، چگونه آن را بفهمند و در پاسخ هایشان چطور از آن استفاده کنند، کاملاً به شانس واگذار شده است!
نقش لایه احراز هویت و پروتکل های نوین (مانند MCP و OAuth) در مدیریت دسترسی هدفمند و تراکنش های مستقیم ربات ها و Agentهای هوش مصنوعی با دیتابیس وب سایت ها.
سیگنال ها تضمین کننده نیستند
در اینجا باید به فایل llms.txt نیز اشاره کنیم که فراتر از دستورات مسدودسازی در robots.txt عمل می کند و در واقع یک راهنمایِ خوانا و مرتب از محتوا و ساختار سایت را به سیستم های هوش مصنوعی ارائه می دهد.
چارچوب ما، فایل llms.txt را به عنوان یک عنصرِ «پیشرو در مرز دانش» دسته بندی کرده و در امتیازدهی لحاظ نکرده است؛ زیرا این فایل هنوز یک استانداردِ تاییدشده با یک نهاد نظارتی مشخص نیست. با این حال، ۱۱ سایت از ۵۰ سایت، این فایل را در سایت خود منتشر کرده بودند. این نشان می دهد که برندها مشتاقند تا یک «خلاصه راهگشا» از هویت و محتوای خود به هوش مصنوعی ارائه دهند.
اما پیش از آنکه به تیم خود دستور دهید فایل robots.txt را آپدیت کنند یا یک فایل llms.txt بسازند، باید بدانید این فایل ها چه کاری می توانند بکنند و چه کاری نمی توانند!
دستورات مربوط به هوش مصنوعی در robots.txt، بیشتر شبیه به «بیان ترجیحات» شما هستند تا قوانین سفت و سخت. رعایت آن ها توسط ربات ها کاملاً داوطلبانه است. ربات های بزرگ مثل GPTBot، ClaudeBot، Google-Extended و Applebot-Extended عموماً به این قوانین احترام می گذارند، اما ربات های ناشناخته تر ممکن است به راحتی قوانین شما را نادیده گرفته و سایت را بخزند. سیگنال های محتوایی از این هم ضمانت اجرایی کمتری دارند.
به عنوان مثال، سایت Expedia یک فایل llms.txt فوق العاده نوشته که شبیه به یک نامه عاشقانه به هوش مصنوعی است! آن ها هویت برند خود را به زیبایی شرح داده اند و قابلیت های سایتشان را به بخش های خوانا و منظم تقسیم کرده اند. اما وقتی نوبت به بررسی معماریِ فنیِ سایتِ Expedia رسید، آن ها تنها ۳۳.۳٪ امتیاز گرفتند (یکی از ضعیف ترین ها در بین ۵۰ سایت). سایت آن ها نه ساختار داده JSON-LD داشت، نه نقشه سایت معرفی کرده بود و تنها یک چهارم محتوایشان سمت سرور (Server-side) رندر می شد.
نوشتنِ یک فایل llms.txt زیبا در حالی که بقیه مشکلات فنی به حال خود رها شده اند، دقیقاً شبیه این است که تابلوی «باز است» را پشت شیشه مغازه بچسبانید، اما یادتان برود قفل درِ ورودی را باز کنید!
این به معنای بی فایده بودن این سیگنال ها نیست؛ بلکه در سئو (مخصوصاً در عصر هوش مصنوعی) موفقیت در گروِ تقویتِ تعدادِ هرچه بیشتری از این سیگنال ها در کنار یکدیگر است. بروزرسانی robots.txt یا ساخت llms.txt جایگزینِ کارهای بنیادی و فنی برای بهبود معماری سایت شما نمی شوند.
نتیجه گیری
منشن شدن و لینک گرفتن، پایان راه نیست؛ این ها تنها لایه اولِ دیده شدن در هوش مصنوعی هستند. ممکن است برند شما بارها توسط هوش مصنوعی معرفی شود، اما به دلیل ارائه اطلاعات غلط (توهم هوش مصنوعی) مشتریانتان را از دست بدهید، یا به این دلیل که هوش مصنوعی اطمینان کافی به داده های شما ندارد، از معرفی محصولاتتان در مهم ترین مکالماتِ کاربران صرف نظر کند.
برندهایی مثل Airbnb، eBay و Amazon به دنبال گرفتنِ منشنِ صرف نیستند. هر کدام از آن ها انتخاب های آگاهانه و مهندسی شده ای داشته اند تا تعیین کنند کدام سیستم های AI حق دارند از محتوای آن ها برای آموزشِ مدل های خود استفاده کنند و کدام سیستم ها اجازه دارند از طرف مشتری در لحظه تراکنش انجام دهند.
تصمیماتی که حضور برند شما را در عصر هوش مصنوعی شکل می دهند، فقط بر عهده تیم مارکتینگ نیست. بسیاری از این تصمیمات در حال حاضر در تنظیمات پیش فرض سرور، فایل های قدیمی robots.txt و سیاست های امنیتی که برای دهه های گذشته نوشته شده اند، پنهان شده اند.
چه برای آن برنامه ریزی و بهینه سازی کرده باشید و چه نه، هوش مصنوعی در همین لحظه در حال خواندن محتوای شماست. اما فراموش نکنید که این محتوای شماست! شما هنوز هم می توانید کنترل کنید که هوش مصنوعی چگونه به برند شما دسترسی پیدا کند، چگونه آن را تفسیر کند و چگونه با آن تعامل داشته باشد.
همه این ها مشکلاتی قابل حل هستند؛ اما فقط در صورتی که تصمیم بگیرید آن ها را حل کنید.