

هر ممیزی یا بررسی هوش مصنوعی (AI Audit)، فقط یک اصطلاح اختصاری جدید به نقشه راه شما اضافه می کند. در واقع، این «معماری دانش» (Knowledge Architecture) است که تعیین می کند آیا ترند بعدی ارزش تبدیل شدن به یک تصمیم برای انتشار محتوا را دارد یا خیر.
پروتکل بعدی هوش مصنوعی استراتژی
اخیراً خودم را در میان مکالمه ای یافتم که این روزها به شدت آشنا و تکراری شده است. یک مدیر ارشد اجرایی هشداری از سوی یک شرکت ارائه دهنده خدمات «سنجش رویت پذیری در هوش مصنوعی» دریافت کرده بود مبنی بر اینکه شرکت او برای «جستجوی مبتنی بر هوش مصنوعی» (AI Search) آمادگی کافی ندارد. در میان توصیه های آن ها، موردی به چشم می خورد که این روزها بیش از پیش می بینم: «شرکت شما به یک فایل llms.txt نیاز دارد!» (فایل llms.txt یک استاندارد جدید است که به مدل های زبانی بزرگ یا LLMها کمک می کند تا اطلاعات سایت را راحت تر بخوانند).
ناگهان، یک فرمت انتشار نوظهور که هنوز بر سر کارایی آن بحث است، به یک دغدغه مدیریتی تبدیل شده بود. حالا یک نفر باید بررسی می کرد که آیا این توصیه اصلاً معتبر است؟ تاثیر احتمالی آن چقدر است؟ توضیح دهد که چرا شرکت تا الان آن را پیاده سازی نکرده است؟ و در نهایت تصمیم بگیرد که آیا منابع تیم مارکتینگ و برنامه نویسی باید برای رفع این مشکل تغییر مسیر دهند یا خیر.
من اخیراً درباره این پدیده مقاله ای نوشتم و نام آن را «مالیات ایجاد ترس و تردید در هوش مصنوعی» یا AI FUD Tax گذاشتم. (FUD مخفف ترس، عدم قطعیت و شک است). هزینه پیاده سازی یک توصیه فردی ممکن است نسبتاً کم باشد، اما هزینه سازمانیِ پاسخگویی مداوم به جدیدترین گزارش های ممیزی هوش مصنوعی می تواند به شدت سنگین تمام شود. هر ممیزی جدید، هر پیشنهاد فروش از سوی شرکت ها، هر پروتکل، کلمه اختصاری یا ادعای رقبا، موج جدیدی از سوالات را در سازمان ایجاد می کند که: «نکند ما داریم از رقبا عقب می افتیم؟»
توهمِ پروتکل: چرا فرمت ها جایگزینِ دانش نمی شوند؟
مشکل اصلی فایل llms.txt، پروتکل MCP، مارک داون (markdown) یا هر تکنولوژی خاص دیگری نیست. در واقع، هر کدام از این ها کار متفاوتی انجام می دهند. برخی به ماشین ها کمک می کنند تا اطلاعات را کشف کنند، برخی راه های جایگزینی برای نمایش اطلاعات ارائه می دهند و برخی دیگر نحوه تبادل یا دسترسی سیستم ها به داده ها را تعریف می کنند. از نظر فنی، دسته بندی همه آن ها در یک گروه اشتباه است، اما از نظر استراتژیک، همه آن ها یک وسوسه سازمانی مشابه ایجاد می کنند: رفتار با جدیدترین مکانیزم تحویل محتوا به عنوان «یک راه حل قطعی»، به جای بررسی و اصلاح دانش زیربنایی سایت. اشتباه این است که با هر کدام از این فرمت ها طوری رفتار کنیم که گویی یک استراتژی کاملاً جدید هستند.
بعد از دهه ها مشاهده نسخه های مختلفی از این چرخه باطل، معتقدم ما دوباره داریم بیش از حد روی «فرمت ها» تمرکز می کنیم و توجه کافی به «اطلاعاتی» که این فرمت ها قرار است منتقل کنند، نداریم. ما در دانش وب همیشه به کارفرمایان خود گوشزد می کنیم که پیش از پرسیدن این سوال که «آیا باید این تکنولوژی جدید را در سایت پیاده سازی کنیم؟»، سازمان ها باید ابتدا یک سوال بنیادی تر از خود بپرسند:
آیا ما اصلاً دانش و دیتای لازم برای پشتیبانی از این تکنولوژی را داریم؟
این تمایز، هرچه هوش مصنوعی راه های بیشتری برای مصرف اطلاعات سازمانی توسط ماشین ها خلق می کند، اهمیت بیشتری می یابد. اگر دانش زیربنایی سایت شما ناقص، پراکنده، متناقض یا در سیستم های جداگانه حبس شده باشد، اضافه کردن یک فرمت ماشین خوان (Machine-readable) دیگر مشکل را حل نمی کند. این کار فقط بستر جدیدی ایجاد می کند تا همان نواقص و محدودیت های قبلی خود را در آنجا هم منتشر کنید!
سازمان هایی که در بهترین موقعیت برای انطباق با این تغییرات قرار دارند، لزوماً آن هایی نیستند که هر پروتکل جدید را زودتر از بقیه پیاده سازی می کنند. بلکه سازمان هایی هستند که دانش خود را آن قدر خوب سازماندهی و مدیریت می کنند که پشتیبانی از فرمت کاربردیِ بعدی، برایشان صرفاً به یک «تصمیم گیری برای انتشار» تبدیل می شود، نه یک پروژه سنگین برای بازسازی زیرساخت.
درک فرآیند تصمیم گیری مشتری، کلید اصلی تبدیل داده های خام به شواهد قابل اعتماد برای هوش مصنوعی است.
پوشش تصمیم گیری (Decision Coverage)؛ خالق سوالات بعدی
در مقاله قبلی این مجموعه، من مفهوم «پوشش تصمیم گیری» را به عنوان راهی برای اندازه گیری این موضوع معرفی کردم که یک سازمان تا چه حد توانسته شواهد و مدارک مورد نیاز هوش مصنوعی را برای ارزیابی، مقایسه، تایید و پیشنهادِ محصولات یا خدماتش در اختیار آن قرار دهد.
این ایده از مشکلی نشأت گرفت که معتقدم بسیاری از کسب وکارها در حال مواجهه با آن هستند. آن ها ممکن است حجم عظیمی از اطلاعات محصول داشته باشند، اما فاقد آن دسته از شواهدی هستند که هوش مصنوعی برای پشتیبانی از یک «تصمیم خرید واقعی توسط مشتری» به آن ها نیاز دارد. مشخصات فنی فقط می گویند محصول «چیست»، اما لزوماً توضیح نمی دهند که این محصول برای «چه کسی» مناسب است، «چه زمانی» باید پیشنهاد شود، در مقایسه با رقبا چه جایگاهی دارد، یا چه نقاط ضعف و قوتی برای مشتریان مختلف دارد.
این موضوع زمانی به وضوح روشن می شود که ما پرامپت ها (دستورات) پیچیده را کالبدشکافی کنیم. درخواست کاربر برای پیدا کردن «بهترین» محصول، به ندرت یک سوال واحد است. این درخواست معمولاً ترکیبی از نیازمندی های بیان شده، ترجیحات استنباط شده، محدودیت ها، مقایسه ها و معیارهای واجد شرایط بودن است که در کنار هم تعیین می کنند کدام گزینه ها از فیلتر عبور کنند.
مشتری را در نظر بگیرید که به دنبال «بهترین ریزورت ساحلی و مناسب برای خانواده در کانکون (یا مثلاً جزیره کیش خودمان)» می گردد. کلمه «بهترین»، صفتی نیست که یک هتل بتواند به سادگی به صفحه سایتش اضافه کند و تمام! این پیشنهاد هوش مصنوعی به دسترسی ساحلی، مناسب بودن برای خانواده، پیکربندی اتاق ها، امکانات رفاهی، قیمت، در دسترس بودن، نظرات کاربران و سایر معیارهای استنباط شده از درخواست کاربر بستگی دارد. هوش مصنوعی باید تمام این شرایط را به صورت دسته جمعی ارزیابی کند تا تصمیم بگیرد کدام هتل ها شایستگی بررسی شدن را دارند.
پارادوکسِ توزیع: وقتی وسواسِ فرمت، حقیقتِ محتوا را دفن می کند
مفهوم «پوشش تصمیم گیری» دقیقاً از زاویه دید سازمان به همین مشکل می پردازد. زمانی که ما متغیرهای تاثیرگذار بر تصمیم مشتری را درک کنیم، می توانیم بررسی کنیم که آیا سازمان شواهد معتبری برای اثبات آن ها دارد یا خیر. اگر یک معیار حیاتی نتواند اثبات شود، مشکل این نیست که برند شما رتبه پایینی گرفته است؛ مشکل این است که شما هرگز شواهد کافی برای عبور از فیلتر هوش مصنوعی ارائه نکرده اید!
این رویکرد، راهی منطقی تر برای تشخیص دلیلِ عدم رویت پذیری در هوش مصنوعی به ما می دهد. به جای اینکه ببینیم یک رقیب توسط هوش مصنوعی پیشنهاد شده و فوراً با رویکرد «من هم همینطور» شروع به تولید محتوای کپی و بی ارزش کنیم، یا لینک سازی انبوه انجام دهیم، یا به سراغ یک پیاده سازی پیچیده فنی برویم، باید فرآیند تصمیم گیری را کالبدشکافی کنیم، معیارهای تاثیرگذار را بشناسیم و ببینیم شواهد اثبات کننده ما در کجا ناقص است. (این دقیقاً همان استراتژی است که ما در بخش تولید محتوا و سئوی دانش وب برای پروژه ها تدوین می کنیم؛ یافتن شکاف های دانشی به جای کپی کاری).
به عبارت دیگر، می توانیم از حالت «صرفاً مشاهده اتفاقات» خارج شده و به سمت «ایجاد شواهدی برای چرایی اتفاقات» حرکت کنیم. با این حال، زمانی که فهمیدیم چه شواهدی باید وجود داشته باشد، «پوشش تصمیم گیری» سوال دیگری را مطرح می کند: این دانش باید در کجا قرار بگیرد و چگونه مطمئن شویم که هر سیستم (موتور جستجو یا AI) دقیقاً همان پاسخ کامل و یکسان را دریافت می کند؟
اینجاست که وسواسِ بیش از حد به این فرمت های جدید، شروع به ایجاد دردسر می کند.
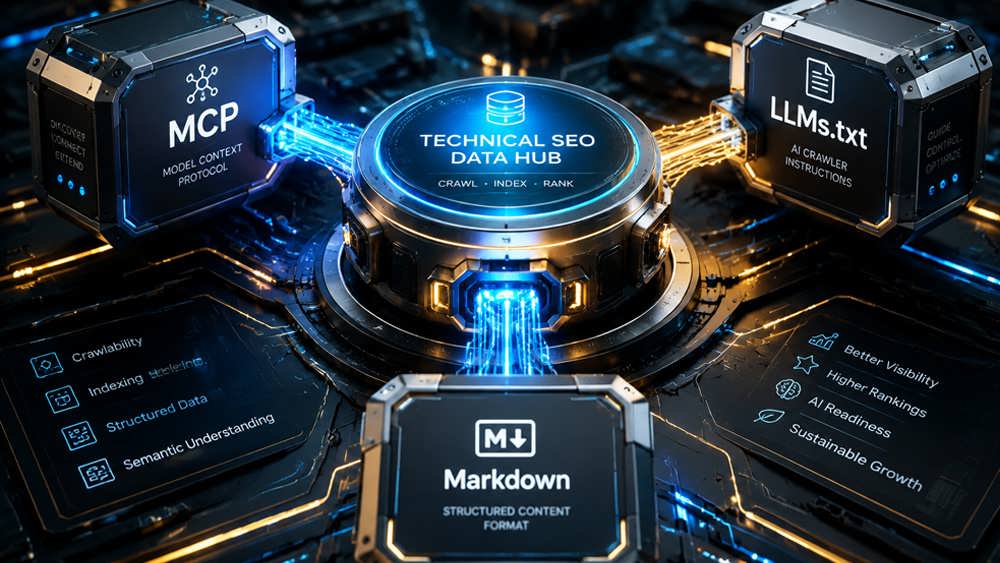
پروتکل های مختلف تنها مکانیزم های تحویل هستند؛ آنچه اهمیت دارد، یکپارچگی داده های اصلی در منبع مرجع است.
یک فرمت جدید، نمی تواند نقص دانش را جبران کند!
آسان ترین واکنش به وجود شکاف در «پوشش تصمیم گیری»، این است که اطلاعات از دست رفته را در هر فرمتی که در آن لحظه ترند شده است قرار دهیم. این روزها لینکدین پر از توصیه هایی است که می گویند اسکیما (Schema) سایتتان را گسترش دهید، نسخه مارک داون بسازید، یک اندپوینت MCP ایجاد کنید، و بله، حتماً فایل llms.txt را مستقر کنید!
شاید این کار یک مشکل انتشار فوری را حل کند، اما لزوماً مشکل اساسی در معماری دانش را برطرف نمی کند. اگر تصمیم گیری مشتری به ۵ معیار معنی دار بستگی دارد و سازمان شما فقط می تواند ۴ مورد از آن ها را اثبات کند، منتشر کردن همان ۴ مدرک از طریق یک پروتکل جدید، ناگهان مدرک پنجم را خلق نمی کند! ما فقط همان نقص اطلاعاتی را در یک فرمت دیگر در دسترس قرار داده ایم.
این تفاوت بسیار بدیهی به نظر می رسد، با این حال بخش زیادی از بحث های امروز پیرامون پیاده سازی هوش مصنوعی، این ترتیب را برعکس کرده اند و به جای تمرکز بر منابع اصلی یا متدهای یکپارچه سازی، روی استنادات متمرکز شده اند. یک اسکیمای گسترده می تواند روابط بین موجودیت ها (Entities) را توصیف کند، اما نمی تواند تعیین کند که این روابط اصلاً چه باید باشند. پروتکل MCP می تواند چندین منبع سازمانی را برای سیستم های هوش مصنوعی قابل دسترس کند، اما نمی تواند تعیین کند که آیا این منابع اصلاً حاوی دانش مورد نیاز برای پاسخگویی به مشتری هستند یا خیر. یک فایل llms.txt می تواند ماشین ها را به سمت اطلاعات هدایت کند، اما نمی تواند جای خالی اطلاعاتی را که سازمان هرگز تولید نکرده، پر کند.
معماری دانش؛ زیربنای ناپیدای سلامت داده
همه این فرمت ها، مکانیزم هایی برای ارتباط و انتقال دانش هستند. ارزش آن ها در نهایت به کامل بودن و کیفیتِ دیتایی بستگی دارد که سازمان ها درون آن ها قرار می دهند. من بیش از ۱۰۰ ممیزی آمادگی هوش مصنوعی را دیده ام که همگی به داشتن فایل llms.txt اشاره کرده اند، اما هیچ کدام عمق یا کیفیت محتوای این فایل ها را در سایت هایی که آن را داشتند، نقد و بررسی نکرده اند!
به همین دلیل است که بحث فعلی پیرامون «یکپارچگی و سلامت داده ها» (Data Integrity) تا این حد مهم است. سئوی تکنیکال باید روزبه روز بیشتر روی به حداکثر رساندن سلامت داده ها تمرکز کند، زیرا سیستم های هوش مصنوعی به شدت به موجودیت های دقیق، روابط صریح، فرمت های ماشین خوان، اکشن ها و سیگنال های ادراکی قابل اعتماد وابسته اند. او نکته مهمی را بیان کرد که کاملاً با استدلال من در اینجا هم راستاست: به جای تلاش برای پیش بینی اینکه کدام پروتکل نوظهور در نهایت برنده بازی خواهد شد، سازمان ها باید لایه های زیربنایی که این پروتکل ها به آن ها وابسته اند را تقویت کنند.
با این حال، یکپارچگی داده ها یک سوال سازمانی پیش نیاز را نیز به وجود می آورد: قبل از اینکه بتوانیم اطمینان حاصل کنیم که اطلاعات دقیق، همگام سازی شده و قابل اعتماد باقی می مانند، باید تعیین کنیم که اصلاً «چه دانشی» باید وجود داشته باشد، این قطعات چگونه به یکدیگر مرتبط می شوند، مالک آن ها کیست و کدام منبع باید به عنوان منبع موثق (Authoritative) در نظر گرفته شود.
یکپارچگی داده ها کمک می کند تا اطلاعات پس از ایجاد شدن، قابل اعتماد باقی بمانند. اما معماری دانش کمک می کند تا مطمئن شویم دانشِ درست اصلاً به وجود آمده، به درستی متصل شده و می تواند به عنوان یک دارایی سازمانی مدیریت شود. با تغییر رویکرد سیستم های هوش مصنوعی از «ارائه صرفِ اسناد» به «استفاده از اطلاعات ما برای تصمیم گیری»، هر دوی این موارد اهمیت فزاینده ای پیدا می کنند.
سازمان ها زمانی برای هوش مصنوعی آماده می شوند که دانش خود را به عنوان یک دارایی استراتژیک مدیریت کنند.
پایگاه مرجع را یک بار بسازید، همه جا منتشر کنید
در یک وبینار اخیر، سعی کردم این چشم اندازِ به شدت پیچیده هوش مصنوعی را در یک اصل واحد ساده کنم: پایگاه مرجعِ اصلی (Canonical Base) را یک بار بسازید. آن را همه جا منتشر کنید.
این ایده عمداً ساده طراحی شده است، زیرا سازمان ها به اختصارات یا پروتکل های جدید برای مدیریت نیاز ندارند. آن ها باید دست از بازسازیِ مجددِ یک دانش تکراری برای هر پلتفرم جدید بردارند.
در لایه زیربنایی، ما واقعیت ها، روابط، سیاست ها، تخصص ها، معیارهای تصمیم گیری مشتری و شواهد پشتیبانی کننده ای را داریم که سازمان می تواند با اعتبار کامل ارائه دهد. این عناصر باید در یک منبع دانش مرجع و واحد (Canonical) ثبت شوند؛ جایی که بتوان آن ها را به یکدیگر متصل کرد، تحت نظارت درآورد، به روزرسانی کرد و مستقل از هر فرمت انتشار خاصی، مجدداً مورد استفاده قرار داد. سازمان های متمرکز بر هوش مصنوعی مانند Milestone، این معماری را به صورت بومی درون سیستم مدیریت محتوای (CMS) خود به عنوان «منبع واحد حقیقت» ساخته اند که قادر است خروجی خود را به هر فرمت نشانه گذاری (Markup) فعلی یا آینده تبدیل کند. (در دانش وب نیز ما در طراحی سایت های اختصاصی بر پایه چنین معماری متمرکزی تاکید داریم تا توسعه در آینده نیازمند کدنویسی های مجدد نباشد).
«پوشش تصمیم گیری» به ما کمک می کند تعیین کنیم آیا این دانش برای پشتیبانی از تصمیمات مهم مشتری به اندازه کافی کامل هست یا خیر. «معماری دانش» راهی برای سازماندهی و نگهداری این دانش فراهم می کند. سپس فرمت های مختلف تبدیل به مکانیزم های تحویلی می شوند که بخش های مناسب این دانش را برای سیستم هایی که به آن ها نیاز دارند، در دسترس قرار می دهند.
امروزه، این مکانیزم های تحویل ممکن است شامل محتوای وب سایت، اسکیما مارک آپ (Schema Markup)، فیدهای مرچنت سنتر (Merchant Center)، APIها، مارک داون، MCP ،llms.txt و سایر فرمت های نوظهور باشند. فردا، این لیست قطعاً چیز دیگری خواهد بود.
اما این تغییرات نباید نیازمند بازسازی دانش زیربنایی شما باشند!
اگر هر فرمتِ انتشار بخواهد نسخه خودش را از حقایق و شواهد تصمیم گیری سازمان ذخیره کند، هر به روزرسانی کوچک باعث مشکلات هماهنگ سازی (Synchronization) می شود و هر پروتکل جدید، یک پروژه سنگینِ پیاده سازی روی دست شما می گذارد. اما اگر همه این فرمت ها از یک منبع دانشِ مشترک و مدیریت شده تغذیه کنند، معماری کاملاً تغییر می کند. کار سخت و طاقت فرسا فقط یک بار در لایه «دانش» انجام می شود، در حالی که لایه «انتشار» به راحتی خود را با تغییر تکنولوژی ها و نیازمندی ها وفق می دهد.
این همان چیزی است که من به آن «معماری دانش» می گویم. این یک قابلیت سازمانی است که اجازه می دهد دانش قابل اعتماد به صورت یکپارچه مونتاژ شده، مدیریت شود و در هر جایی که ارزش آفرینی می کند، تحویل داده شود.
امکان انتشار محتوا، به معنای توانمندی سازمانی نیست!
این تمایز همچنین دلیل برخی از ناامیدی های من از استفاده روزافزون و بی دقت از اصطلاحاتی مانند «آماده برای هوش مصنوعی» (AI ready) را توضیح می دهد.
پشتیبانی از یک پروتکل مبتنی بر ایجنت ها (Agent-oriented)، قطعاً تعامل یک ایجنت هوشمند را با سیستم های سازمان شما آسان تر می کند. این یک زیرساخت مفید است، اما به طور خودکار به این معنا نیست که سازمان شما دانشی را در اختیار دارد که ایجنت برای گرفتن یک تصمیم مفید و کاربردی به آن نیاز دارد.
در اینجا واقعاً دو مشکل متفاوت در حال ترکیب شدن و خلط مبحث هستند. اولی توانمندی سازمانی است: آیا شرکت می تواند دانشی را که مشتریان و ماشین ها به آن نیاز دارند ثبت، متصل، مدیریت، نگهداری و بازیابی کند؟ دومی بحث انتشار است: آیا می توان این دانش را از طریق فرمت مورد نیاز یک موتور جستجو، پلتفرم هوش مصنوعی، ایجنت یا پروتکل خاص بیان کرد؟
یکی از انتقادات من به این فرمت های نشانه گذاری جدید این است که آن ها معمولاً از سمت شرکتی می آیند که به دنبال فروش ابزار خود است و یک خروجی کاملاً مشخص را وعده می دهد. آن ها یک مشکل واقعی برای سیستم های هوش مصنوعی (یعنی هرج ومرج موجود در وب سایت های بازاریابی مدرن) را حل می کنند و همین موضوع باعث می شود به راحتی به فروش بروند. برخی از این ابزارها مدام تبلیغ می کنند که چقدر سریع و آسان می توانند آن فرمت را روی سایت شما تولید کنند، اما هیچ اشاره ای نمی کنند که چگونه می توانند دانش سازمانی شما را سروسامان دهند؛ چرا؟ چون هیچ پروتکلی نمی تواند به جای ما تولید دانش کند!
یک پروتکل نمی تواند اطلاعات متناقض محصول که بین دپارتمان های مختلف پخش شده را یکپارچه کند. نمی تواند تخصص و تجربه ای که درون ذهن یک فروشنده حرفه ای نهفته است را استخراج کند، نمی تواند تعیین کند کدام دغدغه ها و اعتراضات مشتری مهم است، نمی تواند مشخص کند که یک سیاست خاص چگونه بر یک محصول اثر می گذارد، یا نمی تواند شواهدِ ناقصی که از طریق «پوشش تصمیم گیری» شناسایی شده اند را خلق کند. این ها مشکلاتِ دانشِ سازمانی هستند که پیش از آنکه تکنولوژی بخواهد پاسخ ها را توزیع کند، باید حل شوند.
تکنولوژی می تواند توانمندی های سازمانی را در معرض دید قرار دهد، اما نمی تواند جایگزین آن شود.
به همین دلیل است که سازمان ها صرفاً با پیاده سازی پروتکل های بیشتر، «آماده برای هوش مصنوعی» نمی شوند. آن ها زمانی آماده می شوند که دانش خود را آن قدر خوب سازماندهی کنند که هر پروتکل کاربردی و جدید، به جای اینکه یک تلاش مجدد برای بازسازی اطلاعات سازمان باشد، صرفاً به یک مقصد جدید برای انتشار تبدیل شود.
پایگاه مرجع را یک بار بسازید و همه جا منتشر کنید؛ کلید پایداری در دنیای پرتغییرِ هوش مصنوعی.
سازماندهی دانش بر محور تصمیم گیری ها
در بیشتر تاریخچه وب، تمرکز همواره بر ایجاد و مدیریت مجموعه ای از صفحات بود؛ پلتفرم های CMS این ساختار را تقویت کردند و علم سئو نیز به طور طبیعی روی بهینه سازی صفحات محصول، صفحات دسته بندی، مقالات، سوالات متداول (FAQ) و لندینگ پیج ها متمرکز شد. چرا؟ چون صفحات، واحدهای اولیه ای بودند که موتورهای جستجو اطلاعات را از آن ها استخراج می کردند و مشتریان نیز آن ها را مصرف می کردند.
اما هوش مصنوعی در حال تضعیف این رابطه است.
اکنون، یک سوال واحد از سوی کاربر ممکن است باعث شود سیستم هوش مصنوعی اطلاعات را از چندین صفحه، فید محصولات، داده های ساختاریافته (Structured Data)، نظرات، منابع خارجی، دیتابیس ها و سایر مخازن دانش استخراج کرده و سپس یک پاسخ ترکیبی و سنتزشده به کاربر ارائه دهد. صفحه وبِ هدفمند هنوز هم مهم است، اما دیگر لزوماً آن واحدِ محوری نیست که تصمیم گیری پیرامون آن شکل بگیرد.
اصل سازماندهی بادوام تر، تمرکز بر «تصمیم مشتری» است.
مشتری به دانستن چه چیزی نیاز دارد؟ چه معیارهایی تعیین می کنند که آیا یک محصول واجد شرایط است؟ چه شواهدی از این معیارها پشتیبانی می کنند؟ کدام جایگزین ها باید با هم مقایسه شوند؟ چه نقاط ضعف و قوتی باید درک شوند؟ کدام سیاست ها، موقعیت های مکانی، محدودیت های موجودی یا سایر روابط بر نتیجه نهایی تاثیر می گذارند؟
این سوالات مستقیماً به چارچوب «پوشش تصمیم گیری» برمی گردند. اگر ما شرایطی را که به طور جمعی تعیین می کنند آیا یک محصول، خدمات یا سازمان از فیلتر عبور می کند یا خیر درک کنیم، می توانیم شواهد مورد نیاز برای پشتیبانی از هر شرط را شناسایی کنیم. سپس، منبع دانش مرجع (Canonical base)، یک خانه امن و مدیریت شده برای این شواهد فراهم می کند، در حالی که فرمت های فردی مشخص می کنند این اطلاعات چگونه به دست ماشین ها برسد.
به همین دلیل است که دنبال کردن فرمت های خروجی، در واقع طی کردن مسیر به صورت برعکس است. ما نباید با یک پروتکل خالی شروع کنیم و بپرسیم «چه اطلاعاتی را می توانیم درون آن قرار دهیم؟» بلکه باید با تصمیمات مشتری که نیاز به پشتیبانی دارند شروع کنیم، مطمئن شویم که شواهد مورد نیاز برای این تصمیمات وجود دارند، و سپس تعیین کنیم کدام مکانیزم های تحویل می توانند این دانش را برای سیستم های تاثیرگذار بر نتیجه (مثل موتورهای جستجو و هوش مصنوعی) قابل دسترسی کنند.
این یک زیرساخت است، نه یک تاکتیک دیگر برای هوش مصنوعی!
این استدلال برای هر کسی که مقالات قبلی من در سرچ انجین ژورنال را دنبال کرده است باید آشنا به نظر برسد، زیرا این بسط همان موضعی است که مدتی است به آن پایبندم. در مقاله “سئو یک تاکتیک نیست، بلکه زیرساختی برای رشد است”، استدلال کردم که عملکرد پایدار در جستجو، به جای پروژه های بهینه سازیِ ایزوله، به قابلیت هایی بستگی دارد که در سراسر سازمان نهادینه شده اند. جستجو زمانی بهترین نتیجه را می دهد که محصول، محتوا، تکنولوژی و استراتژی کسب وکار همگی بر محورِ این موضوع که «مشتریان در واقعیت چگونه راه حل ها را کشف، ارزیابی و انتخاب می کنند» متصل شوند.
من بعداً مفهوم «شکاف ارزش ویژه جستجو» (Search Equity Gap) را معرفی کردم تا ارزش تجاریِ از دست رفته ای را کمی سازی کنم که سازمان ها به دلیل عدم موفقیت در کسب رویت پذیری واجد شرایط (که منطقاً باید به دست می آوردند)، متحمل می شوند. آن مقاله همچنین بر تاثیر فزاینده تجربیات جستجوی بدون کلیک (Zero-click) و جستجوی با واسطه هوش مصنوعی تاکید کرد؛ جایی که رویت پذیری می تواند پابرجا بماند حتی زمانی که اقتصاد و مدل درآمدیِ تعامل با مشتری تغییر می کند.
با تکامل هوش مصنوعی، این ایده ها به شکل فزاینده ای به هم مرتبط شده اند. مفهوم «حاکمیت برند» (Brand Sovereignty) این نیاز را تثبیت می کند که سازمان ها باید به منبع موثق و معتبرِ حقایق و تخصص خودشان تبدیل شوند. مفهوم «ارزش کلیک» (Click Worthiness) کمک می کند تا تعیین کنیم در چه جاهایی تعامل مستمر باعث ایجاد ارزش افزوده کافی برای مشتری و کسب وکار می شود تا سرمایه گذاری را توجیه کند. «پوشش تصمیم گیری» هم می پرسد آیا ما شواهد مورد نیاز هوش مصنوعی برای ارزیابی، مقایسه، تایید و پیشنهادِ خودمان را با اطمینان کامل در معرض دید قرار داده ایم یا خیر.
معماری دانش، فونداسیون مستحکمی را در زیر تمام این قابلیت ها فراهم می کند.
بدون داشتن اطلاعات سازمانی قابل اعتماد، ایجاد حاکمیت برند دشوار می شود. بدون درک تصمیمات مشتری، اولویت بندیِ ارزش کلیک سخت می شود. بدون داشتن شواهد کاملِ تصمیم گیری، «پوشش تصمیم گیری» ناقص می ماند. و بدون یک معماری که قادر به مدیریت و استفاده مجدد از این دانش باشد، هر فرمت جدیدِ هوش مصنوعی، سازمان را دوباره به یک چرخه بی پایانِ پیاده سازی و کدنویسی پرتاب می کند.
به همین دلیل است که پروتکل بعدی هوش مصنوعی، قرار نیست یک استراتژی سئو را که فاقد قابلیتِ دانشِ زیربنایی است، نجات دهد. پروتکل، معلولی در پایین دستِ این مشکل است، نه علت و راه حل آن.
معماری دانش یعنی عبور از چرخه بی پایانِ فرمت ها و تمرکز بر ایجاد یک پایگاه مرجع واحد که به هر سوالِ تصمیم سازِ مشتری، پاسخ می دهد.
نتیجه گیری
من نمی دانم آیا MCP، llms.txt، Agents.md، UCP یا هر یک از رویکردهای نوظهور امروزی در نهایت به استانداردهای بنیادی تبدیل خواهند شد یا خیر. برخی بدون شک مهم تر خواهند شد. برخی دیگر تکامل می یابند، با چیز دیگری ادغام می شوند یا به همان سرعتی که تکنولوژی های حیاتیِ گذشته ناپدید شدند، محو می شوند. این عدم قطعیت، دقیقاً همان دلیلی است که سازمان ها باید در برابر ساختن استراتژی هوش مصنوعی خود بر اساس فرمت های فردی مقاومت کنند. پروتکل بعدی، قطعا آخرین پروتکل نخواهد بود.
سازمان هایی که استراتژی خود را حول فرمت های پرهیاهوی امروزی می سازند، در نهایت مجبورند فردا دوباره همه چیز را از نو بسازند. در مقابل، سازمان هایی که یک منبع دانشِ مدیریت شده پیرامون تخصص تجاری و تصمیمات مشتری خود می سازند، در موقعیت بسیار متفاوتی قرار خواهند گرفت. وقتی فرمت کاربردیِ بعدی ظاهر شود، آن ها نیازی به کشف مجدد، خلق دوباره و تطبیقِ دانشی که آن فرمت نیاز دارد نخواهند داشت. آن ها فقط باید تصمیم بگیرند که آیا این فرمت جدید، راه ارزشمندی برای انتشارِ «آنچه از قبل می دانند» ارائه می دهد یا خیر.
این مدلی بسیار مقاوم تر برای آمادگی در برابر هوش مصنوعی است و مهم تر از آن، استفاده بسیار بهینه تری از منابع سازمان (تیم مارکتینگ و برنامه نویسی) محسوب می شود.
هدف این نیست که از هر فرمت ممکنی پشتیبانی کنیم. هدف این است که اطمینان حاصل کنیم دانشی که برای گرفتن تصمیمات مهم توسط مشتری نیاز است، جامع، معتبر، مدیریت شده و آماده برای تحویل از طریق فرمت های مهم است. پروتکل ها همچنان تغییر خواهند کرد. مکانیزم های تحویل به تکثیر شدن ادامه می دهند و مشاوران سئو و هوش مصنوعی بدون شک موارد جدیدی برای اضافه کردن به لیست ممیزی های سایت شما پیدا خواهند کرد. اما واکنش استراتژیک شما باید به شکل قابل توجهی پایدار باقی بماند:
پایگاه داده را یک بار بسازید. آن را همه جا منتشر کنید.