

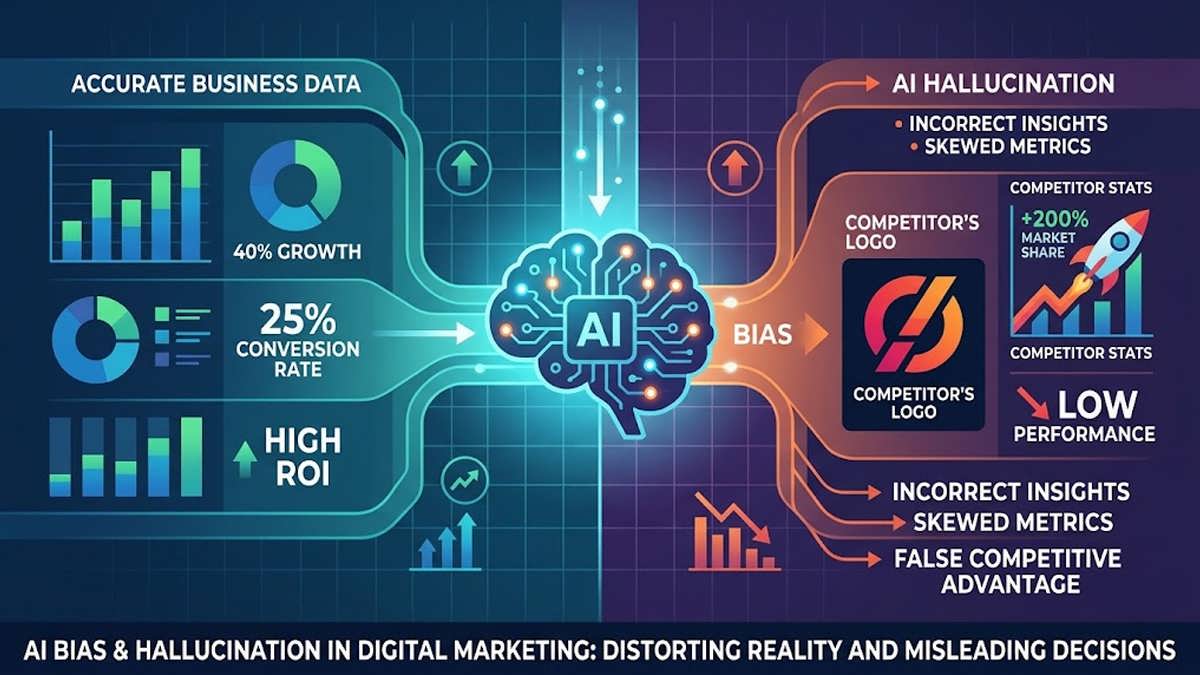
وقتی یک مدل هوش مصنوعی (AI) اطلاعاتی درباره کسب وکار شما در چنته نداشته باشد، این موضوع را به کسی نمی گوید. نه دست رد به سینه کاربر می زند، نه طفره می رود و نه به نقطه ای که اطلاعاتش در آنجا به پایان رسیده اشاره می کند. در عوض، به سراغ نزدیک ترین سوژه ای می رود که اطلاعات خوبی درباره اش در وب ثبت شده است؛ که معمولاً این سوژه رقیب شما، میانگین آمار صنف کاری تان، یا نسخه ای از شرکت شما در سه سال پیش است. سپس، این اطلاعات جایگزین را با همان لحن قاطع و مطمئنی به کاربر ارائه می دهد که انگار واقعاً پاسخ درست را می داند.
تا به حال درباره این موضوع زیاد بحث شده است؛ اما چیزی که کمتر به آن پرداخته اند و باید باعث نگرانی هر متخصص دیجیتال مارکتینگی شود این است: شما نمی توانید این مشکل را با ممیزی (Audit) محتوای سایت خودتان پیدا کنید.
تمام ابزارها و روش های ممیزی محتوا روی چیزهایی تمرکز دارند که وجود خارجی دارند: صفحات سایت، ساختار، پوشش موضوعی، دقت و به روز بودن محتوا. اما این خطای هوش مصنوعی در جایی اتفاق می افتد که وجود خارجی ندارد؛ در فضایی که متعلق به شما نیست، و دقیقاً در همان لحظه ای نمایان می شود که شخصی سوالی می پرسد که شما هرگز آن را نخواهید دید.
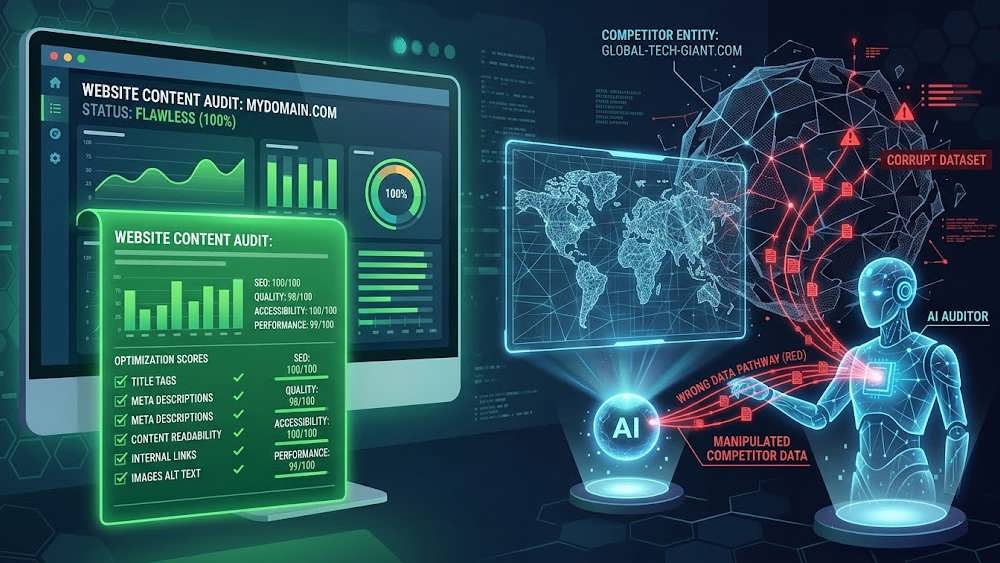
به همین دلیل، گزارش ممیزی سایت شما کاملاً بی نقص به نظر می رسد. صفحات سالم هستند، کدهای اسکیما (Schema) معتبرند و پوشش محتوایی سایت شما در مقایسه با رقبا کاملاً منطقی است. اما مدل هوش مصنوعی همچنان در حال گفتن چیزهایی درباره شرکت شما به کاربران است که هیچ کدام از صفحات سایتتان آن را تأیید نمی کنند و هیچ یک از صفحات شما هم نمی توانستند جلوی این اتفاق را بگیرند.
چرا هوش مصنوعی به جای خالی گذاشتن اطلاعات، جای آن را پر می کند؟
سازوکار این اتفاق به خوبی مستند شده است. مدل های هوش مصنوعی به طور خاص در درک و بازگویی حقایق کمتر شناخته شده مشکل دارند. بزرگ تر شدن دیتابیس این مدل ها عمدتاً به یادآوری حقایق مشهور کمک می کند و تأثیر چندانی روی اطلاعات خاص و محدود (اصطلاحاً Long-tail) ندارد. به زبان ساده، مقیاس پذیری هوش مصنوعی قرار نیست به داد یک تولیدکننده متوسط یا یک شرکت خدماتی محلی برسد. بخش نازک نمودار توزیع اطلاعات، همچنان نازک باقی می ماند. (مثلاً اگر شما یک کسب وکار نوپا هستید، هوش مصنوعی تمایل دارد ویژگی های غول های صنعت را به شما تعمیم دهد).
سوال جالب این است که در این بخشِ کم اطلاعات چه اتفاقی می افتد؟ پژوهشگرانی مانند «لانگ پری» و همکارانش در تحقیقات سال ۲۰۲۱ خود، بررسی کردند که مدل ها چقدر به جای خواندن اطلاعات پیشِ رو، به اطلاعات حفظ شده ی خود تکیه می کنند. رفتار آن ها «امتناع از پاسخگویی» نیست، بلکه «تولید بااعتمادبه نفسِ» اطلاعات، از لابه لای داده هایی است که در حافظه (وزن های شبکه عصبی) خود دارند.
باید این موضوع را از مفهوم رایج «توهم هوش مصنوعی» (Hallucination) جدا کنید؛ زیرا صنعت ما این دو را با هم یکی کرده و این یکسان سازی باعث تشخیص اشتباه می شود. توهمِ معمولی، کاملاً تصادفی است؛ مثلاً یک نقل قول جعلی، یک آمار ساختگی یا مقاله ای که وجود خارجی ندارد را می سازد و مدل های جدیدتر توانسته اند این نوع توهم را کاهش دهند.
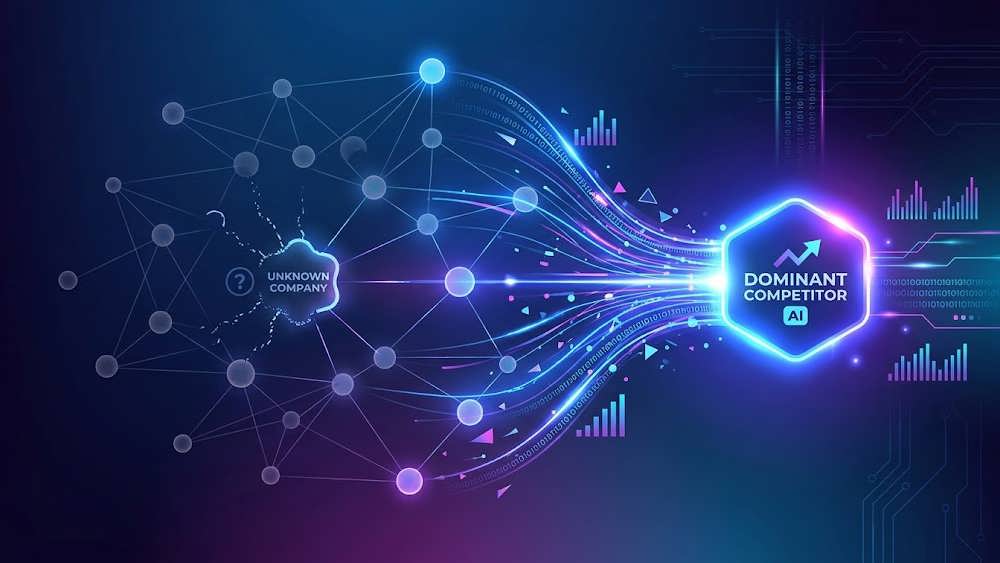
اما چیزی که من توصیف می کنم تصادفی نیست؛ بلکه کاملاً سیستماتیک، جهت دار و قابل پیش بینی است. وقتی هوش مصنوعی یک موجودیتِ کم اطلاعات (مثل برند شما) را در کنار یک همسایه ی پُر اطلاعات (رقیب بزرگتان) می بیند، ناخودآگاه به سمت رقیب کشیده می شود. در تیم سئو دانش وب، ما همیشه در جلسات مشاوره به کسب وکارها یادآوری می کنیم که دلیل اصلی این اتفاق، توزیع داده ها در زمان آموزش هوش مصنوعی است، نه یک باگ نرم افزاری ساده. به همین دلیل است که وعده های همیشگی درباره کاهش توهمِ مدل های جدید در اینجا صدق نمی کند. آن ها در «اختراع نکردن اطلاعات» بهتر شده اند، اما در شناختن شرکت هایی که کسی در سطح وب درباره شان چیزی ننوشته، پیشرفتی نکرده اند.
نمایشی از شبکه داده ای هوش مصنوعی که در آن اطلاعات شرکت های نوپا و کم اطلاعات (Long-Tail) تحت تأثیر گره های داده ای بزرگتر (رقبا و کلیات صنعت) قرار می گیرد.
یک نمونه عملی از دروغ پردازی هوش مصنوعی
اخیراً مقاله ای در حوزه B2B دست به دست می شود که به تیم های برندینگ هشدار می دهد هوش مصنوعی درباره محصولات آن ها ادعاهای دروغین می سازد. این مقاله به خوبی نوشته شده و به یک مشکل واقعی می پردازد.
مقاله با یک نقل قول مستقیم از «پرسی لیانگ»، مدیر مرکز تحقیقات روی مدل های پایه در استنفورد شروع می شود. اما من نتوانستم این نقل قول را هیچ جای دیگری در وب پیدا کنم! نه در یک مقاله پژوهشی، نه در یک سخنرانی و نه در هیچ مصاحبه ای. در همین مقاله، به گزارش هایی از موسسات معتبری مانند گارتنر (Gartner) و MIT لینک داده شده، اما همه لینک ها به جای اشاره به سند اصلی، به صفحه اصلی این سایت ها ختم می شوند.
به این موضوع دقت کنید: مقاله ای که می خواهد درباره دروغ پردازی هوش مصنوعی هشدار دهد، خودش در حال جعل کردن اطلاعات و نقل قول ها از محققان و موسسات است! این سازوکار معیوب در ماشین باقی نمانده؛ بلکه بیرون آمده، به شکل مقاله منتشر شده، در گوگل ایندکس شده و حالا در پایگاه داده ای قرار دارد که نسل بعدی هوش مصنوعی قرار است از آن یاد بگیرد.
شاید اعتراض کنید که بسیاری از این تحقیقات پولی هستند و نویسنده نتوانسته لینک مستقیم بدهد. اما این توجیه برای گزارش استنفورد که کاملاً رایگان است، صدق نمی کند. حتی اگر مقاله ای پولی باشد، اصول رفرنس دهی ایجاب می کند که نام نویسنده و تاریخ دقیق ذکر شود. چیزی که ما با آن روبه رو هستیم، عنوانی است که کاملاً با ادعای نویسنده همخوانی دارد، اما هیچ پشتوانه ای پشت آن نیست.
من قصد تخریب شرکتی که این مقاله را نوشته ندارم. چیزی که مهم است، خودِ این «رفتار» است. کسی که این محتوا را تولید کرده، برای ادعاهایش نیاز به منابع معتبر داشته و چون چنین منابعی به اندازه کافی وجود نداشته، جای خالی را با چیزهایی «شبیه به واقعیت» پر کرده است: نام موسسات واقعی، عناوین منطقی برای گزارش ها و لینک های سالم به صفحه اصلی سازمان ها. یعنی تمام سیگنال های ظاهری یک کار دقیق وجود دارد، اما از محتوای واقعی خبری نیست.
حالا مدیر مارکتینگی را تصور کنید که این آمار را می خواند، باور می کند و در جلسه هیئت مدیره ارائه می دهد. این اطلاعاتِ جایگزین، از یک مدل هوش مصنوعی به یک مقاله، سپس به یک انسان و در نهایت به یک تصمیم گیری منتقل شده است، بدون اینکه هیچ کس در این زنجیره عمداً کار اشتباهی انجام داده باشد.
۴ شکل مختلف، اما یک رفتار واحد
جایگزینی اطلاعات هرگز به یک شکل ثابت خود را نشان نمی دهد و به همین دلیل مخفی می ماند. این اتفاق به ۴ شکل قابل تشخیص رخ می دهد که معمولاً اشتباه آنالیز می شوند:
۱. قیاس خاموش (Silent Analogy): مدل هوش مصنوعی به سراغ نزدیک ترین رقیب شناخته شده ی شما می رود و ویژگی های او را به شما نسبت می دهد. مثلاً مدل قیمت گذاری شما با بزرگ ترین رقیبتان یکی در نظر گرفته می شود. از دیدگاه هوش مصنوعی هیچ جابجایی رخ نداده، بلکه فقط محتمل ترین توصیف برای شرکتی شبیه به شما ارائه شده است.
۲. اطلاعات تاریخ گذشته به عنوان اطلاعات روز: مدل، نسخه ای قدیمی از شرکت شما را به خاطر می آورد و آن را در زمان حال بیان می کند؛ مثلاً محصولاتی که دیگر تولید نمی کنید یا مدیری که سال هاست از شرکت رفته است. هیچ تاریخ انقضایی برای حافظه هوش مصنوعی وجود ندارد.
۳. ارائه شواهد ضعیف با اعتمادبه نفسِ بالا: هوش مصنوعی مشخص نمی کند که پاسخ خود را بر اساس چه حجم از اطلاعاتی ساخته است. بنابراین، ادعایی که تنها بر اساس یک پست وبلاگ شکل گرفته، طوری بیان می شود که انگار کل اینترنت روی آن توافق دارند!
۴. تعمیم دانش یک صنف به یک شرکت خاص: مدل، اطلاعات زیادی درباره صنعت شما دارد اما درباره شخصِ شما چیزی نمی داند؛ پس پاسخ مربوط به کل صنعت را با نام شما ترکیب می کند. این مورد سخت ترین حالت برای تشخیص است، چون جواب از نظر فنی درست به نظر می رسد و از تست های دقتِ سطحی عبور می کند.
چرا ممیزی محتوا (Content Audit) این خطاها را پیدا نمی کند؟
بخش مهم و عملیاتی ماجرا اینجاست: ممیزی محتوا، صفحات سایت شما را با یک استاندارد می سنجد. اما هیچ کدام از این ۴ خطای هوش مصنوعی ربطی به صفحات شما ندارند. اطلاعاتی که می توانست جلوی این خطاها را بگیرد، اصولاً در طول سال ها توسط افراد دیگر در جاهای دیگر نوشته شده است، نه توسط شما.
واکنش طبیعی کسب وکارها این است که محتوای بیشتری در سایتشان منتشر کنند تا جای خالی پر شود و موتورهای جستجو بهتر آن ها را درک کنند. این غریزه قابل درک است، اما راهکار ضعیفی است. تحقیقات نشان می دهد که سیستم های بازیابی اطلاعات، تمایل دارند به سمت موجودیت های معروف تر سوگیری کنند. یعنی تولید محتوای صِرف در سایت خودتان کافی نیست.
در دانش وب، تجربه به ما ثابت کرده است که داشتن یک سایت استاندارد تنها نیمی از راه است؛ برای غلبه بر این سوگیری، به یک استراتژی سئوی همه جانبه (شامل دیجیتال مارکتینگ، رپورتاژ آگهی مستمر در رسانه های معتبر و برندمنشن) نیاز دارید تا هوش مصنوعی شما را به عنوان یک هویت مستقل بشناسد. در غیر این صورت، گزارش ممیزی شما سبز و بی نقص است، اما خطا همچنان در خفا و در پاسخ به کوئری های کاربران رخ می دهد.
داوطلب و گزارش ممیزی محتوای سایت کاملاً سبز و بی نقص به نظر می رسد، اما هوش مصنوعی در محیطی خارج از سایت در حال ارائه اطلاعات نادرست به کاربران است.
تنها جایی که این مشکل نمایان می شود
شما این جایگزینیِ اطلاعات را با بررسی خروجی های هوش مصنوعی (پاسخ هایی که به کاربران می دهد) پیدا می کنید، نه ورودی های سایت خودتان.
شما باید به دنبال ادعاهایی باشید که هوش مصنوعی درباره شرکت شما می کند اما هیچ ردی در منابع و سایت شما ندارند. توانمندی خاصی که ندارید اما هوش مصنوعی با جزئیات آن را به شما نسبت داده، برنامه زمانی که هرگز اعلام نکرده اید، یا مقایسه ای با رقبا که با شرایط واقعی شما همخوانی ندارد.
نحوه تست کردن شما مهم تر از تعداد تست هاست. اگر نام شرکت خود را مستقیماً در پرامپت (Prompt) بنویسید، کمترین اطلاعات را به دست می آورید؛ زیرا نام شما به عنوان یک کلمه کلیدی، تمام دیتای مربوط به شما را فراخوانی می کند. جایگزینی ها زمانی خود را نشان می دهند که نام شما در سوال غایب باشد و هوش مصنوعی مجبور باشد خودش شما را پیشنهاد دهد! مثلاً پرسش هایی درباره یک ویژگی خاص در صنعت شما یا مقایسه غیرمستقیم. در اینجاست که هوش مصنوعی تصمیم می گیرد اطلاعات همسایگان شما را قرض بگیرد.
این آزمایش را روی سوالات واقعی مشتریانتان به صورت مداوم تکرار کنید. من به عنوان کسی که در بخش ارزیابی این سیستم ها فعالیت می کنم صراحتاً می گویم: دنیایی که فقط بر اساس ممیزی دارایی های داخلی (سایت خودمان) بنا شده باشد، نسبت به خطاهایی که خارج از این دارایی ها رخ می دهند کاملاً نابیناست.
واقعیت تلخ این است: بی نقص ترین ممیزی محتوایی که تا به حال روی سایتتان انجام داده اید، هیچ چیز درباره نحوه نمایش برند شما در ذهن هوش مصنوعی به شما نمی گوید.
اگر شما هم متوجه شده اید که مدل های هوش مصنوعی چیزی درباره شرکتتان گفته اند که ردی از آن در وب نیافته اید، خوشحال می شوم آن را بشنوم. برایم کامنت بگذارید یا مستقیماً در ارتباط باشید. من در مقالات بعدی خود بیشتر به نحوه درک سیستم های ماشینی از تصویر شرکت ها خواهم پرداخت.
نتیجه گیری
گسترش استفاده از مدل های زبانی بزرگ (LLMs) و هوش مصنوعی در موتورهای جستجو، قوانین بازی را در دنیای سئو و دیجیتال مارکتینگ تغییر داده است. همان طور که در این مقاله بررسی کردیم، هوش مصنوعی تمایل دارد جای خالی اطلاعات برندهای کمتر شناخته شده را با داده های رقبا یا اطلاعات کلیشه ای پر کند. برای در امان ماندن از این «توهمات سیستماتیک»، اتکا به سئوی داخلی سایت (On-Page SEO) و ممیزی های سنتی به هیچ وجه کافی نیست. برندها باید استراتژی دیجیتال خود را فراتر از دامنه سایتشان گسترش دهند. فعالیت مستمر در شبکه های اجتماعی، انتشار رپورتاژ آگهی هدفمند، ایجاد منشن های بدون لینک (Unlinked Mentions) و مدیریت فعالانه شهرت آنلاین (ORM)، به هوش مصنوعی سیگنال های قدرتمندی می دهد تا تصویر دقیق تری از کسب وکار شما بسازد. همگام شدن با سئوی مبتنی بر هوش مصنوعی (AEO)، نیازمند تخصص، تحلیل داده و همراهی یک تیم حرفه ای است تا نام برند شما، قربانی سوگیری های الگوریتمی نشود.