

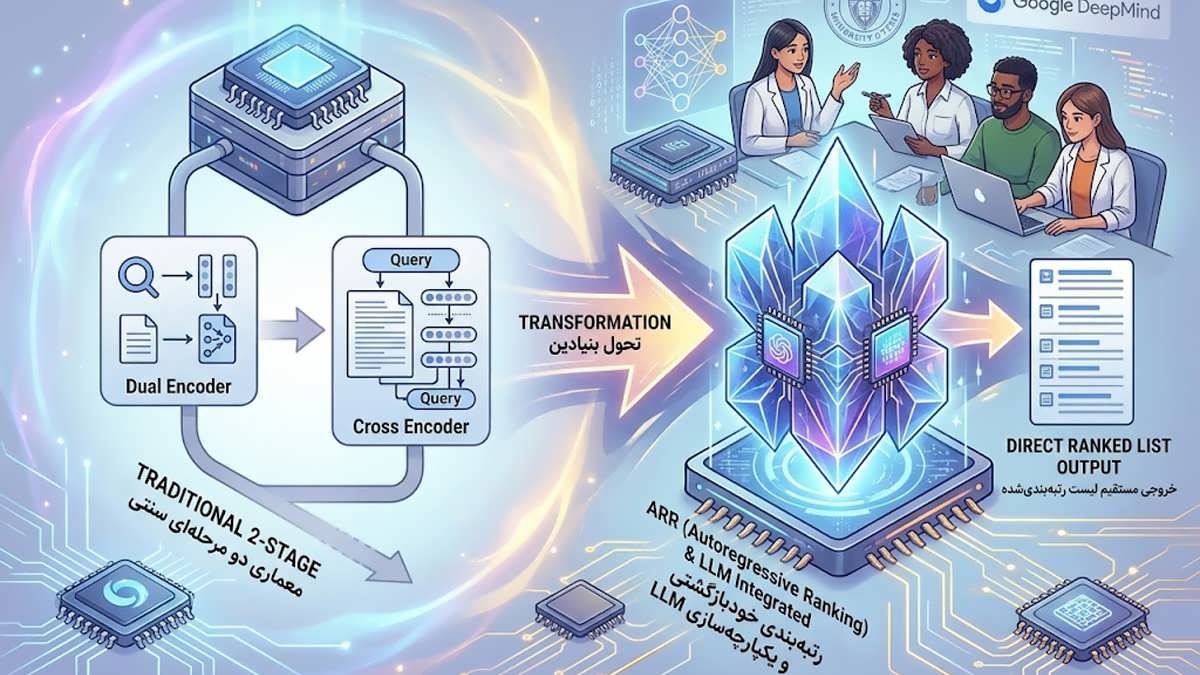
گوگل اخیراً مقاله ای پژوهشی منتشر کرده که نشان می دهد در حال آموزش یک مدل زبانی بزرگ (LLM) برای جایگزینی معماری های فعلی رتبه بندی در هسته اصلی جستجو است. محققان در این تحقیق، استفاده از رتبه بندی خودبازگشتی (Autoregressive Ranking) را به عنوان جایگزینی برای سیستم های رتبه بندی دو مرحله ای فعلی پیشنهاد داده اند.
معماری سنتی: رمزگذار دوگانه و رمزگذار متقاطع
برای درک اهمیت این تحول، ابتدا باید سیستم های فعلی را بشناسیم. در حال حاضر، سیستم های رتبه بندی جستجو معمولاً دارای یک معماری دو مرحله ای هستند:
۱. رمزگذار دوگانه (Dual Encoder – DE): این بخش، پرس وجوی کاربر و اسناد موجود در وب را به «بردار» (Vector) تبدیل می کند تا به سرعت اسناد مرتبط را بازیابی کند. این مرحله بسیار سریع و مقرون به صرفه است.
۲. رمزگذار متقاطع (Cross Encoder – CE): پس از انتخاب اسناد کاندید توسط DE، این مرحله وارد عمل شده و آن ها را با دقت بالا بازبینی و رتبه بندی می کند.
اگرچه این سیستم دو مرحله ای کارآمد است، اما محدودیت هایی دارد؛ چرا که رمزگذارهای متقاطع به دلیل پردازش سنگین، نمی توانند برای مقیاس کل وب استفاده شوند. در مقابل، رمزگذارهای دوگانه نیز از نظر دقت در رتبه بندی نهایی دچار محدودیت هستند.
تولد ARR: عبور از محدودیت های گذشته
محققان گوگل دیپ مایند، دانشگاه ماساچوست و دانشگاه تگزاس، روش جدیدی به نام رتبه بندی خودبازگشتی (ARR) را در مقاله خود با عنوان «رتبه بندی خودبازگشتی: پر کردن شکاف میان رمزگذارهای دوگانه و متقاطع» معرفی کرده اند.
این یک تغییر بنیادین است؛ چرا که به جای تکیه بر معماری دو مرحله ای، از یک مدل زبانی بزرگ (LLM) استفاده می شود که مستقیماً لیست اسناد رتبه بندی شده را تولید می کند. اگر چنین سیستمی عملیاتی شود، تاثیرات آن بر دنیای SEO و AEO (بهینه سازی برای موتورهای پاسخگو) بسیار عمیق خواهد بود. ما در دانش وب همواره با رصد این تغییرات بنیادین، استراتژی های سئوی مشتریان خود را به روز نگه می داریم تا همگام با تغییرات الگوریتم های گوگل، سایت ها جایگاه خود را حفظ کنند.
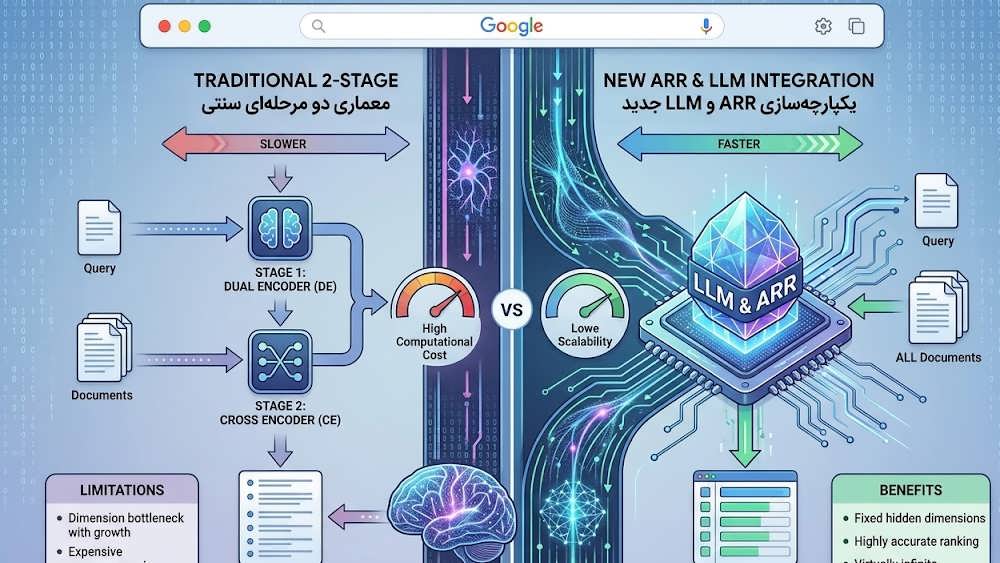
این دیاگرام بصری جریان پردازش پرس وجو را بین رمزگذارهای دوگانه سنتی، رمزگذارهای متقاطع و روش جدید ARR مبتنی بر LLM مقایسه می کند و تفاوت دقت و پیچیدگی محاسباتی را نشان می دهد.
متدولوژی آموزش مدل: SToICaL
برای آموزش این مدل، محققان روشی به نام SToICaL (مخفف «تابع زیانِ کالیبره شده برای توکن-آیتم ساده») را ابداع کرده اند. این روش به مدل می آموزد که چگونه اسناد را بهتر رتبه بندی کند:
- به اسناد مرتبط تر وزن بیشتری داده می شود.
- احتمال انتخاب توکن هایی که به اسناد با رتبه بالاتر منجر می شوند، افزایش می یابد.
نتیجه این آموزش، مدلی است که نه تنها اسناد مرتبط را می شناسد، بلکه به خوبی اسناد نامرتبط را از لیست حذف می کند.
نتایج آزمون ها چه می گویند؟
در آزمایش های انجام شده روی مجموعه داده های مختلف (مانند WordNet)، نتایج نشان داد:
- دقت بالا: مدل ARR از نظر کیفیت رتبه بندی، عملکردی مشابه «رمزگذارهای متقاطع» (که بسیار سنگین هستند) دارد و بسیار بهتر از «رمزگذارهای دوگانه» عمل می کند.
- کاهش خطا: این روش به طرز چشمگیری باعث کاهش خطای رتبه بندی (قرار گرفتن اسناد نامرتبط در رتبه های بالا) می شود.
با این حال، محققان اشاره می کنند که هنوز جای کار دارد، زیرا در برخی تست های خاص (مانند جستجوی خرید)، دقتِ آوردنِ اولین نتیجه مرتبط کمی متغیر بود که نیاز به تحقیقات بیشتری دارد.
نتیجه گیری
محدودیت اصلی سیستم های فعلی (DE) این است که با رشد تعداد اسناد برای رتبه بندی، ابعاد بردار باید رشد کند که از نظر محاسباتی دشوار است. اما مدل ARR دارای «ابعاد پنهان ثابت» است و به لحاظ تئوری می تواند تعداد نامحدودی از اسناد را بدون افزایش فشارهای محاسباتی سنگین، رتبه بندی کند.