

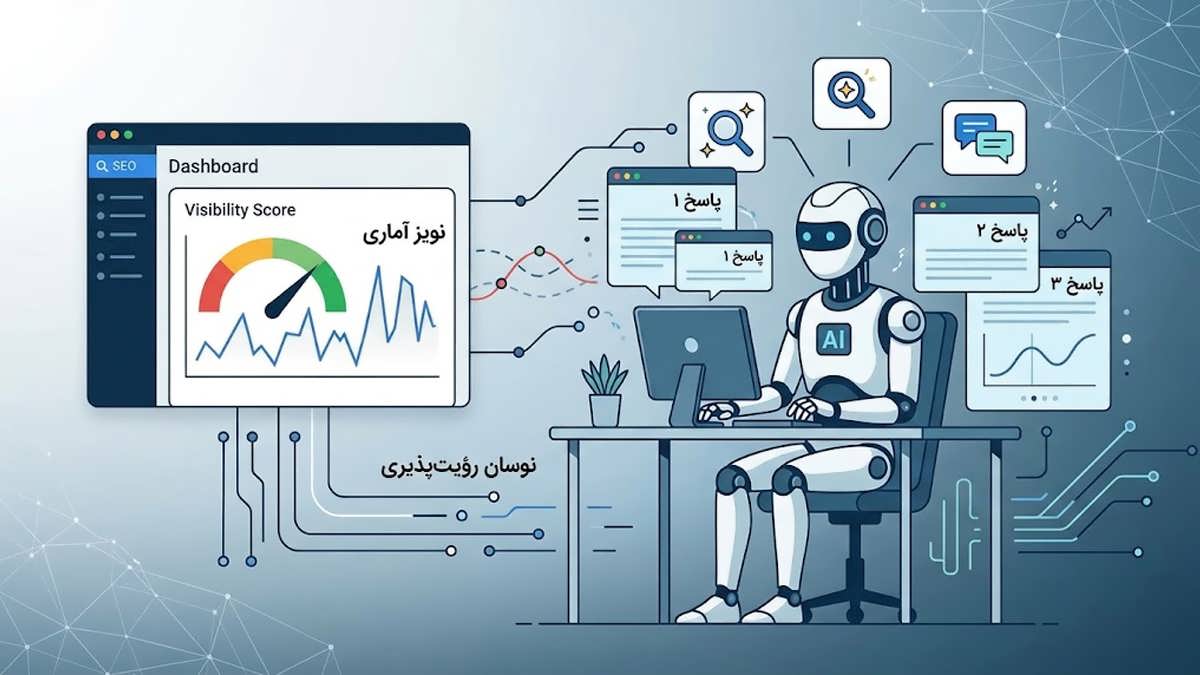
تحقیقات جدید نشان می دهد که رتبه بندیِ میزان دیده شدن (Visibility) در هوش مصنوعی، بین هر بار اجرای تست تغییر می کند. در این مقاله می آموزیم که چرا یک بررسیِ تک مرحله ای بیشتر به یک «نویز آماری» شبیه است و واقعاً به چه تعداد نمونه گیری نیاز دارید.
داده های مربوط به رهگیری رؤیت پذیری در هوش مصنوعی (AI Visibility) کاملاً قابل اتکا نیستند. از آنجا که مدل های زایشی (Generative Models) غالباً پاسخ های متفاوتی برای یک پرسش واحد تولید می کنند، سهم استنادها (Citation Shares) و رتبه بندی هایی که روی داشبوردِ ابزارهای سئو می بینید، صرفاً تصاویری لحظه ای از یک هدفِ دائماً در حال تغییر هستند، نه حقایق ثابت و قطعی.
تفاوت رتبه شما و رقیبتان در این ابزارها ممکن است یک برتری واقعی باشد، یا صرفاً یک نوسان طبیعی بین اندازه گیری های مختلف. یک مقاله جدید از IQRush که در ۱۱ آوریل منتشر شده، روشی را برای تمایز قائل شدن بین این دو حالت ارائه می دهد و ثابت می کند که هیچ مقدار ثابتی از داده ها نمی تواند به طور قطعی این مسئله را حل کند.
این مقاله توسط ران سیلینسکی (Ron Sielinski)، هم بنیان گذار IQRush نوشته شده است. شرکت آن ها نرم افزاری را می فروشد که رؤیت پذیری در هوش مصنوعی را دقیقاً به همان روشی که مقاله استدلال می کند، اندازه گیری می نماید. دلیل اینکه باید به این مقاله توجه کنید این است که یک تیم تحقیقاتی مستقل دیگر نیز در ماه آوریل یافته های مشابهی درباره اندازه گیری های مکرر منتشر کرده است؛ بنابراین IQRush تنها شرکتی نیست که این ادعا را مطرح می کند.
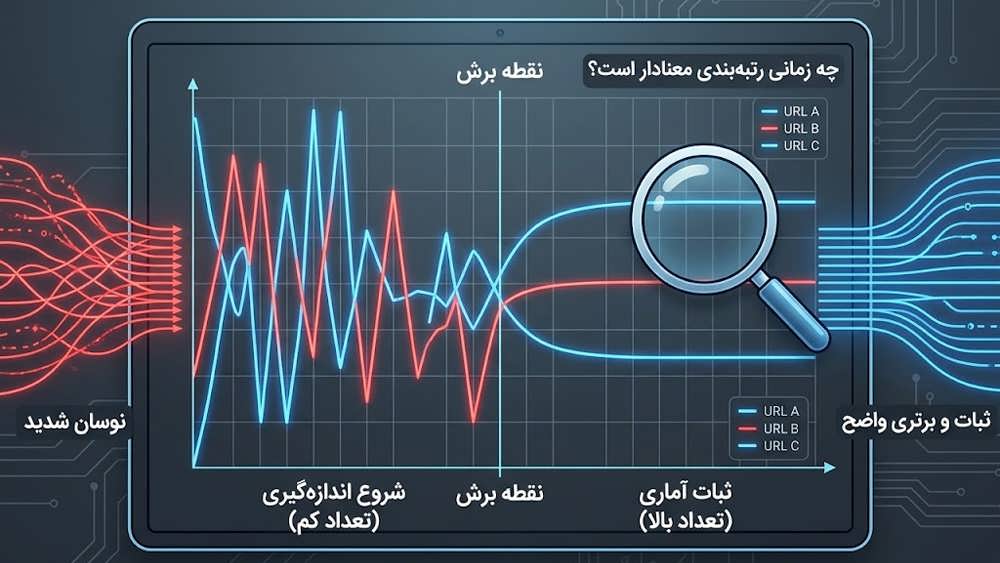
این نمودار техни نشان می دهد که چگونه افزایش تعداد نمونه گیری ها (از چپ به راست) باعث کاهش نوسانات شدید و رسیدن به یک رتبه بندی پایدار و قابل اعتماد می شود.
این اعداد چقدر تغییر می کنند؟
پرسش مکررِ یک سوال یکسان از موتورهایی مانند SearchGPT ،Gemini یا Perplexity می تواند هر بار منابع مختلفی را به عنوان خروجی ارائه دهد. این ابزارها طوری ساخته شده اند که مقداری تصادفی بودن (Randomness) را به هر پاسخ اضافه کنند؛ بنابراین هر استنادِ (Citation) ثبت شده، صرفاً یکی از ده ها URL ممکنی است که هوش مصنوعی می توانست استخراج کند.
مقاله قبلیِ همین نویسنده، این تغییرپذیری را با دقت بررسی کرده بود. به عنوان مثال، هنگام آزمایش SearchGPT در مورد «تجهیزات دویدن»، سایت Tom’s Guide حدود ۹.۵ درصد از استنادها را به خود اختصاص داد، در حالی که سهم سایت Runner’s World تقریباً ۶.۰ درصد بود. روی داشبوردِ ابزارها، Tom’s Guide بیشتر ظاهر می شد، اما حاشیه خطایِ (Margin of Error) بزرگ به این معنی بود که این ارقام با هم هم پوشانی دارند. با داشتن تنها یک نمونه (Sample)، نمی شد با قطعیت گفت که عملکرد Tom’s Guide بهتر از Runner’s World بوده است، زیرا تفاوت ۳.۵ امتیازی دقیقاً در محدوده حاشیه خطا قرار داشت.
مقاله جدید قصد دارد با پرداختن به یک سوال ساده اما غالباً نادیده گرفته شده، از این اشتباه جلوگیری کند: پیش از اینکه رتبه بندی ها واقعاً معنادار شوند، به چه مقدار داده نیاز داریم؟
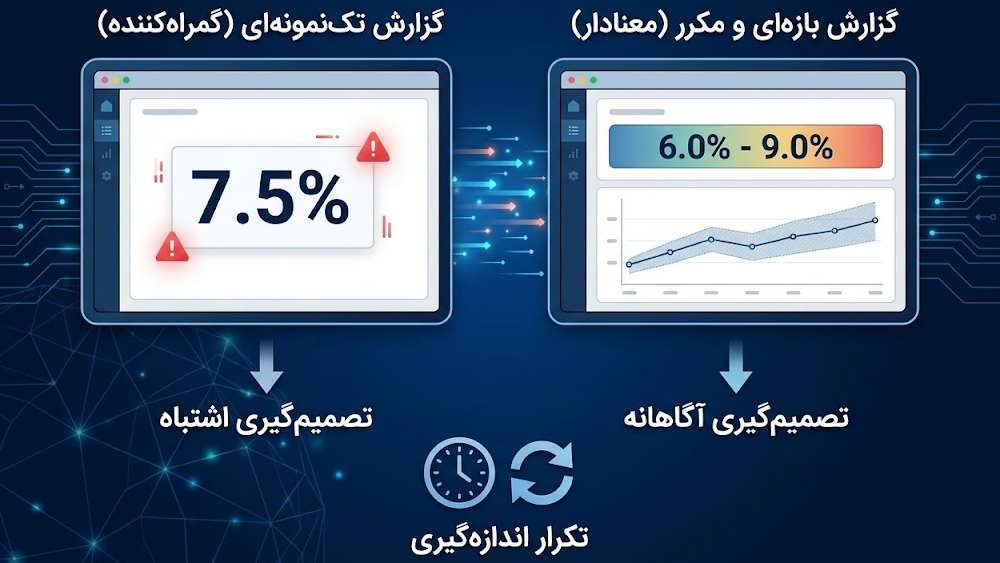
مقایسه دو نوع گزارش: سمت چپ گزارش تک نمونه ای و گمراه کننده، و سمت راست گزارش با اندازه گیری مکرر که یک بازه را به عنوان روند نشان می دهد و برای تصمیم گیری آگاهانه مناسب است.
چه زمانی می توان به یک رتبه بندی اعتماد کرد؟
پاسخ این سوال دو بخش دارد و برای قابل اتکا بودنِ یک رتبه بندی، باید هر دو شرط صدق کنند:
اول اینکه، تغییر کردنِ ترتیب رتبه ها باید متوقف شود و به ثبات برسد. در ابتدا، از آنجا که هنوز هیچ سایتی برتری واضحی ندارد، ممکن است رتبه بندی ها با اضافه شدن پاسخ های جدید به طور مکرر تغییر کنند. تنها پس از جمع آوری پاسخ های کافی است که سایت های برتر به وضوح خود را نشان می دهند و اجازه می دهند ترتیب رتبه ها تثبیت شود.
دوم اینکه بسیار مهم است سایت های برتر فاصله و اختلاف معناداری از هم داشته باشند؛ اگر رقابت خیلی نزدیک باشد، ممکن است رتبه بندی فاقد ارزش عملی باشد، زیرا یک رقابت تنگاتنگ نشان نمی دهد چه کسی واقعاً جلوتر است.
این مقاله بررسی می کند که آیا تفاوت بین سایت های برتر، بزرگ تر از حاشیه خطای هر یک از آن هاست یا خیر. وقتی این طور باشد، رتبه بندی نشان دهنده یک تفاوت واقعی است. اما زمانی که این گونه نباشد، احتمالاً فقط یک «نویز آماری» است. هر دو شرط باید به طور همزمان برقرار باشند؛ هیچ کدام به تنهایی کافی نیست.
در ۳۰ تست انجام شده روی پلتفرم ها و موضوعات مختلف، تعداد پاسخ های مورد نیاز برای تحقق هر دو شرط بین ۳۳ تا ۹۴ مورد متغیر بود (در این آمار فقط پاسخ های دارای منبع/استناد شمرده شدند). سه مورد از این ۳۰ تست، حتی پس از ۱۲۵ پرسش نیز به این نقطه ثبات نرسیدند؛ تمامی این سه مورد مربوط به SearchGPT بودند، جایی که سایت های برتر آن قدر شبیه به هم بودند که نمی شد آن ها را از یکدیگر متمایز کرد. به زبان ساده، هیچ نقطه برش (Cutoff) واحدی وجود ندارد که همه جا کاربرد داشته باشد؛ آنچه برای یک پلتفرم و یک موضوع جواب می دهد، ممکن است برای پلتفرمی دیگر اصلاً مناسب نباشد.
ما پیش از این نیز به این موضوع پرداخته بودیم
در ماه ژانویه، درباره کشف ابزار SparkToro بحث کردم؛ آن ها متوجه شدند که ابزارهای هوش مصنوعی در بیش از ۹۹ درصد مواقعی که یک سوال مشابه را می پرسید، لیست متفاوتی از برندهای پیشنهادی را ارائه می دهند. آن مقاله یک سوال بی پاسخ بر جای گذاشت: چند بار باید بپرسید تا نتایج به ثبات برسند؟ مقاله ای که امروز بررسی می کنیم، روشن ترین پاسخی است که تاکنون با آن مواجه شده ام.
رند فیشکین (Rand Fishkin) که هدایت آن مطالعه را بر عهده داشت، توصیه مفیدی را به اشتراک می گذارد. او پیشنهاد می کند پیش از صرف هرگونه هزینه برای رهگیری رؤیت پذیری در هوش مصنوعی، مطمئن شوید که ابزار ارائه دهنده «محاسبات ریاضیِ پشتِ پرده خود را به شما نشان می دهد». مقاله IQRush روشی عالی برای این کار است، زیرا یک «قانون توقف» (Stopping Rule) ساده ارائه می دهد تا مجبور نباشید برای تشخیص تعداد دفعاتِ کافی، صرفاً به شهود و حدسیات تکیه کنید.
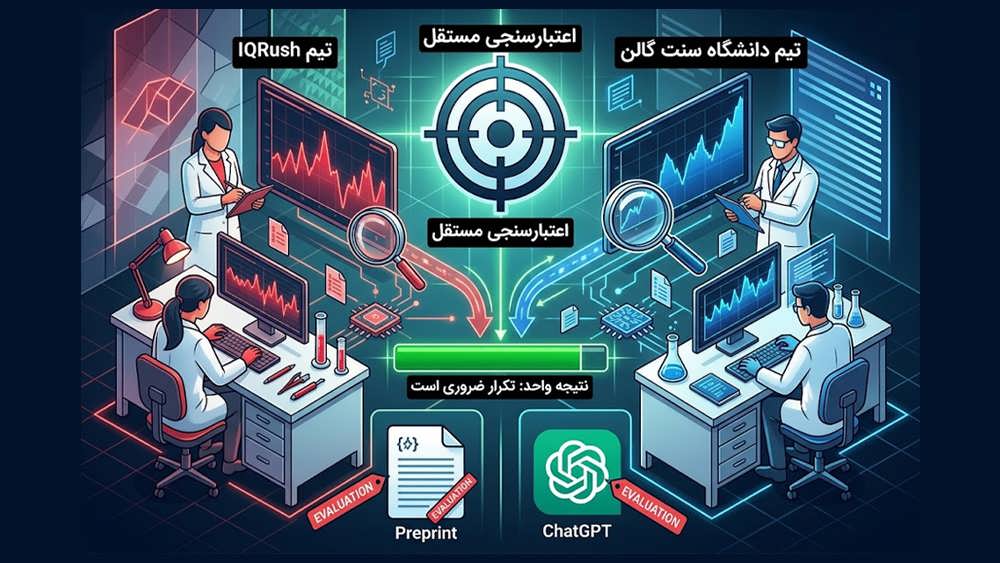
این تصویر مفهومی نشان می دهد که چگونه دو تیم تحقیقاتی مستقل (یکی از IQRush و دیگری از دانشگاه سنت گالن) با بررسی داده های جداگانه به نتیجه واحدی رسیده اند: یک بررسی واحد کافی نیست و تکرار تست برای اعتماد به خروجی ضروری است.
این موضوع چه تغییری در گزارش دهی شما ایجاد می کند؟
عددی که روی داشبورد سئوی شما نمایش داده می شود، فقط یک تک نمونه است. قبل از اینکه به آن اعتماد کنید، بررسی کنید که آیا ابزار رهگیری شما همان بررسی را به صورت مکرر انجام می دهد و یک بازه (Range) را گزارش می کند، یا فقط یک بار داده ها را استخراج کرده و یک عددِ تر و تمیز به شما نشان می دهد. این عددِ به ظاهر دقیق، در واقع می تواند یک علامت هشدار باشد، نه مایه اطمینان!
رشد کردنِ آمار پس از اعمال یک تغییر محتوایی، به راحتی می تواند به اشتباه تفسیر شود. به عنوان مثال، افزایش سه امتیازیِ سهم استناد شما در SearchGPT ممکن است دلیلی بر این به نظر برسد که تلاش های شما به ثمر نشسته است؛ اما بر اساس داده های مقاله، چنین تغییری می تواند کاملاً در محدوده نوسانات طبیعی در اجراهای متوالی قرار داشته باشد.
برای ادعای موفقیت، باید وضعیت را قبل و بعد از تغییرات، «بیش از یک بار» اندازه گیری کنید. یک خوانشِ ساده از وضعیتِ قبل و بعد، نمی تواند تأثیر تغییرات شما را از نویزهای معمولی تفکیک کند.
پلتفرمی که برای اندازه گیری استفاده می کنید نیز روی مقدار داده های مورد نیاز شما تأثیر می گذارد، و البته نه به آن شکلی که حدس می زنید. مسئله این است که هر پاسخ چقدر «اطلاعات مستقل» با خود به همراه دارد، نه اینکه چند استناد به شما می دهد. به عنوان مثال، جمینای (Gemini) حجم زیادی از استنادها را در یک پاسخِ واحد روی همان چند سایتِ محدود تلنبار می کند، بنابراین بسیاری از این استنادها در واقع یک حرف تکراری را می زنند.
در مقابل، SearchGPT استنادهای کمتری در هر پاسخ ارائه می دهد، اما آن ها را در منابع مختلف پخش می کند؛ بنابراین هر پاسخِ آن، اطلاعات مستقل بیشتری نسبت به آمارِ خام به همراه دارد. به همین دلیل، دریافت تعداد برابری از پاسخ ها در این دو موتور، سطح اطمینان یکسانی به شما نمی دهد؛ و بودجه ای که برای رسیدن به نتیجه قطعی در جمینای کافی است، ممکن است در SearchGPT شما را در ابهام نگه دارد.
واقعیت پنهان در رتبهبندی ها
گاهی اوقات صادقانه ترین پاسخ این است که «هنوز نمی توان نظر قطعی داد». سه مورد از ۳۰ تستِ انجام شده هرگز نتوانستند سایت های برترِ خود را در قالب بودجه تخصیص یافته به طور واضح متمایز کنند. برای این موارد، تصمیم درست «دست نگه داشتن» است، نه انتشارِ یک رتبه بندی که داده ها نمی توانند از آن پشتیبانی کنند. ابزاری که بتواند به شما بگوید «داده ها برای قضاوت کافی نیست»، بسیار ارزشمندتر از ابزاری است که هر بار با اطمینان کامل، یک رتبه بندیِ بی اساس به شما می دهد.
صدر جدولِ رتبه بندی، تنها بخشی است که بیشترین دفاع را می توانید از آن بکنید. با دریافت پاسخ های کافی، سایت های پیشتاز از سایت های میانه و انتهای جدول فاصله می گیرند (اگرچه حتی جایگاه آن ها نیز دقیق و بی نقص نیست). حاشیه های خطا در رتبه های پایین تر از صدر جدول به سرعت گسترش می یابند، تا جایی که جایگاه های نزدیک به هم کاملاً تصادفی (مثل پرتاب سکه) می شوند. حتی لیست ۱۰ سایت برتر (Top 10) نیز بی نقص نبود؛ به طوری که حاشیه خطای معمول برای یک سایت در تاپ ۱۰، حدود ۵ جایگاه جابه جایی است و از هر پنج مورد، یک مورد حاشیه خطایی عریض تر از ۱۰ جایگاه داشت. به رهبران و سایت های پیشتاز اعتماد کنید، سایت های میانی و پایینی را به صورت تخمینی در نظر بگیرید و جایگاه های دقیق را برای سایت هایی که در صدر لیست نیستند، گزارش نکنید.
آنچه این مقاله ثابت نمی کند
هیچ کدام از این آمار از یک مطالعه نهایی و داوری همتا شده (Peer-Reviewed) به دست نیامده است. این مقاله یک پیش چاپ (Preprint) است که بر اساس ۳۰ تستِ پلتفرم-موضوع روی سه موتور مختلف هوش مصنوعی شکل گرفته و از سوالات تولید شده توسط ChatGPT (به جای جستجوهای واقعی کاربران) در یک دوره زمانی محدود برای جمع آوری داده ها استفاده کرده است. این اعدادِ دقیق به شکلی بی نقص قابل تعمیم به موضوعاتِ کسب وکار شما نخواهند بود؛ بنابراین به آن ها به چشمِ تصویری کلی از ماهیتِ یک مشکل نگاه کنید، نه یک جدول مرجعِ ریاضی.
این شمارش ها تنها شامل پاسخ هایی می شدند که دارای استناد (Citation) بودند. این موضوع به ویژه در مورد SearchGPT اهمیت دارد، زیرا بخشی از پرسش های آن اصولاً هیچ استنادی در بر ندارند. در یکی از موضوعات، ۱۲۵ پرسش تنها ۱۰۴ پاسخ قابل استفاده تولید کرد (یعنی یک خطای ۱۷ درصدی)؛ بنابراین در شرایط واقعی، باید سوالاتی بسیار بیشتر از ارقام گفته شده ثبت کنید.
علاوه بر این، روش اعتبارسنجیِ مقاله نیز کاملاً داخلی است. این مقاله، رتبه بندیِ به اصطلاح «اولیه» را با رتبه بندی «نهاییِ» همان مجموعه مقایسه می کند، نه با یک حقیقتِ پایه یا دیتای خارجی. این کار صرفاً ثابت می کند که «قانون توقف» با خودش سازگاری دارد. دقیقاً به همین دلیل است که رسیدن به نتیجه ای مشابه توسط یک تیم مستقل، اعتبار بالایی به این مطالعه می بخشد. نویسندگان مقاله آوریل – یعنی ژولیوس شولته، مالته بلیکر و فیلیپ کافمن – محققان دانشگاه سنت گالن هستند. آن ها با بررسی یک مجموعه داده کاملاً جداگانه به همان حکم رسیدند: اینکه «یک بررسیِ واحد به هیچ وجه قابل اتکا نیست و برای اعتماد به خروجی یک موتور جستجوی هوش مصنوعی، باید به صورت مکرر از آن نمونه گیری کنید».
تصویری امنیتی و техни از یک کنسول مدیریتی که فرآیند «مدل سازی تهدید» (Threat Modeling) را برای ایجنت های هوش مصنوعی، شامل تحلیل بردارهای حمله و تخصیص بودجه امنیتی، نشان می دهد.
این مسیر به کجا ختم می شود؟
این مقاله دقیقاً پیش از رسیدن به آن چیزی که اکثر افراد می خواهند متوقف می شود: یعنی یافتن راهی برای دانستنِ «بودجه اجرای تست» پیش از شروع فرآیند جمع آوری داده ها. سیلینسکی این کار را به تحقیقات بعدی موکول می کند و خاطرنشان می سازد که این عدد کاملاً به شکل و الگوی استناد در هر پلتفرم بستگی دارد؛ بنابراین احتمالاً یک بودجه و فرمولِ جهانی در کار نخواهد بود.
تغییر بزرگ تر این است که سیستم گزارش دهیِ رؤیت پذیری در هوش مصنوعی، در حال حرکت به همان سمتی است که پیش از این گزارش های تبلیغاتی و تحلیلی (Analytics) طی کرده اند؛ یعنی حرکت به سوی اعدادی که دارای یک «حاشیه خطا» هستند، نه اعدادی که اعشارهای کاذب و ظاهرِ ۱۰۰ درصد دقیقی دارند.
این اتفاق در حالی رخ می دهد که زیرساخت های اساسی هنوز وجود ندارند، زیرا سرچ کنسول گوگل (Search Console) هنوز به شما نشان نمی دهد که دقیقاً کدام کلیک ها از طریق پاسخ های هوش مصنوعی ایجاد شده اند.
تا زمانی که گوگل قابلیت رهگیری AI Overviews را به صورت رسمی به سرچ کنسول اضافه نکند، سئوکاران باید از پارامترهای جایگزین استفاده کنند). تا آن زمان، این وظیفه بر عهده شخصِ شماست که بررسی ها را بیش از یک بار انجام دهید و بازه و حاشیه خطا را به درستی گزارش کنید، نه آن تک عددی که داشبورد به شما تحویل می دهد.
نتیجه گیری
در دنیای پرشتاب امروز، موفقیت در سئو و دیجیتال مارکتینگ تنها با تکیه بر ابزارهای خودکار و پذیرش چشم بسته اعدادِ روی داشبوردها به دست نمی آید. همان طور که این تحقیق نشان داد، تثبیت حضور برند شما در نتایج هوش مصنوعی (AI Visibility) نیازمند تحلیل عمیق، درک حاشیه خطا و پرهیز از تصمیم گیری های شتاب زده بر اساس داده های تک نمونه ای است. برای دستیابی به رشدی پایدار و واقعی، به استراتژی های داده محور و نظارت مستمر نیاز دارید. تیم متخصصین دانش وب با سال ها تجربه و ارائه خدمات حرفه ای در زمینه طراحی سایت، سئو و دیجیتال مارکتینگ، در کنار شماست تا با تحلیل های دقیق، علمی و پیوسته، جایگاه واقعی برند شما را در موتورهای جستجو ارتقا داده و کسب وکارتان را از تصمیمات مبتنی بر نویزهای گمراه کننده آماری در امان نگه دارد.