

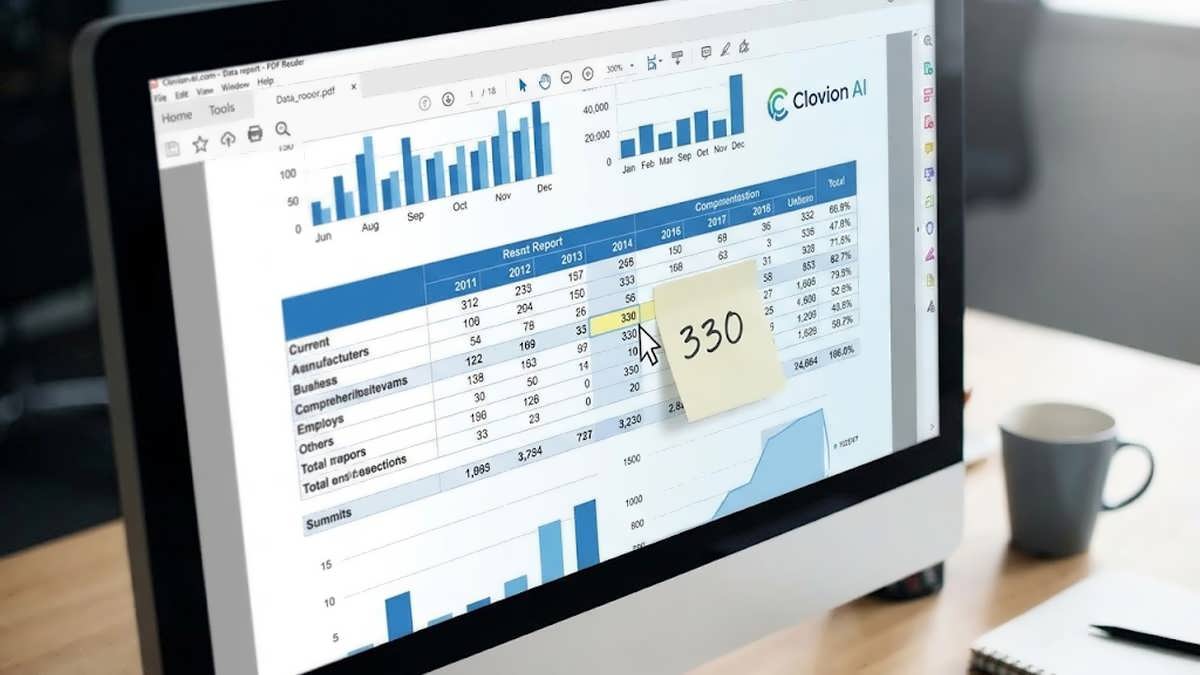
من برای حسن، مدیر عملیات (COO) شرکت تحقیقاتی «کلوویون ای آی» (Clovion AI) که در اسلو نروژ مستقر است، لیستی از سوالات تخصصی درباره متدولوژی تحقیق جدیدشان با نام «بقا در قیف هوش مصنوعی» ارسال کرده بودم. این مطالعه بررسی می کرد که چگونه دستیارهای هوش مصنوعی مانند Claude، ChatGPT و Gemini، برندهای مختلف را در طول یک مکالمه با کاربر پیشنهاد می دهند.
سوال دهم من یک سوال کاملاً روتین بود؛ از همان دست سوالاتی که از هر تیم تحقیقاتی می پرسید. در این گزارش آمده بود که این سه دستیار هوش مصنوعی در ۱۵٪ مواقع بر سر حقایق مربوط به یک برند با یکدیگر تناقضِ آشکار دارند و این نتیجه گیری بر اساس «۳۳ تناقض تایید شده» به دست آمده بود. سوال من این بود: آیا نمونه آماریِ ۳۳ تایی واقعاً برای اثبات این ادعا کافی است که نشان دهیم کدام مدل زبانی ویژگی های یک برند را کمتر از حد واقعی جلوه می دهد (Undersell) و کدام یک درباره آن مبالغه می کند (Oversell)؟
پاسخ حسن دفاع از آن عدد نبود، بلکه یک اصلاحیه بود. او در پاسخ نوشت: «عدد واقعی ۳۳۰ است؛ طراح گرافیک ما هنگام صفحه آرایی گزارش، یک صفر را جا انداخته است!» به گفته او، همین اشتباهِ به ظاهر کوچک اعشاری در صفحه هفتم فایل PDF (که پیش از انتشار عمومی برای من ارسال شده بود)، باعث شده بود تا عدد ۲,۰۴۰ برند نیز به اشتباه «۲۰۴» درج شود. نسخه اصلاح شده این گزارش در همین هفته منتشر خواهد شد؛ بنابراین من توانستم پیش از همه به اعداد و ارقام صحیح دسترسی پیدا کنم.
شاید اعتراف به وجود یک خطای تایپی در پیش نویس یک گزارش تحقیقاتی، روش عجیبی برای شروع مقاله ای درباره هوش مصنوعی باشد؛ اما این صادقانه ترین نقطه ورود به بحث است. این اصلاحیه چیزی را به ما می گوید که آمارهای پر زرق وبرق تیترها هرگز نمی توانند بگویند: درک درست از پاسخ های هوش مصنوعی (چه بازاریابی باشید که می خواهد بداند آیا ChatGPT محصولش را پیشنهاد می دهد یا نه، و چه پژوهشگری که در حال تدوین یک مطالعه است) در گرو دقت به همین جزئیات و صفرهای جا افتاده است، پیش از آنکه استراتژی کسب وکارتان را روی آن ها بنا کنید.
قیف هوش مصنوعی؛ یک مرور کلی
اگر فعلاً خطای تایپی را کنار بگذاریم، ساختار تحقیقاتی این مطالعه کاملاً مستحکم و قابل اتکاست. شرکت Clovion در این تحقیق، ۶۹,۱۲۰ مکالمه چندمرحله ای (Multi-turn conversations) را در ۳۶ دسته بندی نرم افزارهای B2B و فناوری مالی (فین تک) با این سه دستیار هوش مصنوعی انجام داد. (منظور از مکالمه چند مرحله ای، پرسش و پاسخ های متوالی است که در آن کاربر پس از دریافت پاسخ اول، سوالات جزئی تری می پرسد).
آن ها ابتدا یک سوال باز مثل «بهترین ابزارهای CRM (مدیریت ارتباط با مشتری) کدامند؟» می پرسیدند و سپس یک سوال تکمیلیِ واقع بینانه مطرح می کردند. اگر آن ها دقیقاً همان سوال اول را دوباره تکرار می کردند، ۹۰٪ از لیست برندهای پیشنهادی دست نخورده باقی می ماند. اما اضافه کردن تنها یک جزئیات ساده از سوی خریدار—مثلاً اضافه کردن عبارت «برای یک تیم کوچک»—باعث می شد تنها ۲۸٪ از برندها در لیست باقی بمانند! به زبان ساده: ۶۲ درصد از برندهایی که در پاسخ اولِ هوش مصنوعی جای داشتند، با طرح دومین سوال از بین رفتند.
من از حسن پرسیدم که آیا عبارت «برای یک تیم کوچک» را صرفاً برای ایجاد این ریزش شدید انتخاب کرده بودند؟ پاسخ منفی بود. تیم او عبارت «برای یک سازمان بزرگ» را نیز تست کرد و به نرخ ریزش تقریباً مشابهی (حدود ۷۲٪) رسید. در واقع، لیست پیشنهادات هوش مصنوعی ناپایدار نیست؛ بلکه به شدت واکنش گراست و مستقیماً به این موضوع بستگی دارد که هوش مصنوعی تصمیم می گیرد یک برند «دقیقاً برای چه کسانی» مناسب است.
اگر شغل شما سئو یا استراتژی برند است، این همان نقطه ای است که باید روی آن تامل کنید. به همین دلیل است که ما در دپارتمان دیجیتال مارکتینگ دانش وب همیشه به مشتریان خود تاکید می کنیم: نام برده شدن در پاسخ اولیه هوش مصنوعی، به معنای جلب اعتماد کامل آن نیست. مدلی که برند شما را در اولین لیست پیشنهادی CRM خود قرار می دهد، می تواند به محض تخصصی تر شدن نیاز کاربر، شما را از لیست حذف کند؛ و داده های Clovion نشان می دهد که این اتفاق نه در برخی مواقع، بلکه در بیشتر مواقع رخ می دهد.
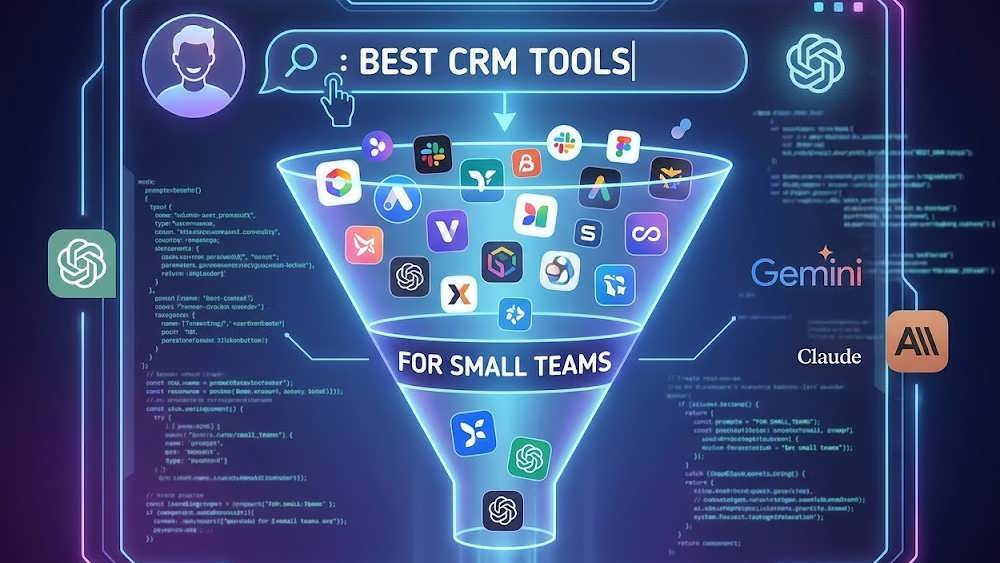
این تصویر مفهومی نشان می دهد چگونه یک سوال باز اول (مانند “بهترین ابزارهای CRM”) لیستی پر از برندها ایجاد می کند، اما به محض اضافه شدن یک جزئیات تخصصی (مانند “برای تیم های کوچک”) در سوال دوم، هوش مصنوعی اکثر برندها را فیلتر کرده و تنها تعداد کمی را باقی می گذارد.
اصلاحیه آمارها، درک ما را از رفتار هوش مصنوعی تغییر می دهد
اینجاست که ارزش آن صفرِ جا افتاده مشخص می شود. رقم قبلی (۳۳ تناقض)، آنقدر کوچک بود که هرگونه ادعای رفتارشناسی درباره مدل های هوش مصنوعی را بی اساس می کرد. اما با اصلاح عدد به ۳۳۰، تفکیک رفتاری هر مدل (که حسن به اشتراک گذاشت) بسیار معنادارتر از آن رقم کلیِ ۱۵ درصدی در پیش نویس است:
- مدل Claude: در ۱۶۰ مورد ویژگی های یک برند را نادیده گرفته یا کمتر از حد واقعی بیان کرده است (Underclaim) و تنها ۱۰ بار درباره آن ها مبالغه کرده است (Overclaim).
- مدل ChatGPT: در ۷۰ مورد ویژگی ها را نادیده گرفته و هیچ گاه مبالغه نکرده است.
- مدل Gemini: کاملاً برعکس عمل می کند! ۸۰ بار در مورد ویژگی های محصولات مبالغه کرده و تنها ۳۰ بار آن ها را نادیده گرفته است.
تئوری فعلی حسن (که از یک مطالعه منتشرنشده دیگر در Clovion درباره منابع پاسخگویی مدل ها به دست آمده) این است که Gemini بیشتر به محتواهای بازاریابی، ویدیوها و تبلیغات متکی است، بنابراین تمایل دارد هر ادعای پر زرق وبرقی که برند مطرح کرده را به عنوان ویژگی محصول بپذیرد. در مقابل، Claude و ChatGPT بیشتر به صفحات محصول، مستندات سایت و فایل های راهنما (Documentation) تکیه می کنند؛ آن ها هسته اصلی محصول را با دقت توصیف می کنند و اگر ویژگیِ جدیدی به خوبی در سایت مستند نشده باشد، با احتیاط می گویند: «این محصول چنین قابلیتی ندارد».
اگر این تئوری قطعی شود، به این معناست که نوع خطای هوش مصنوعی درباره محصول شما، مستقیماً به این بستگی دارد که چه نوع محتوایی تولید کرده اید و این محتوا در کجای بستر وب قرار دارد.
بیش از ۲۰ سال است که به کسب وکارها می گویم «کسب رتبه خوب در گوگل» و «توصیف دقیق و درست برند» دو چالش کاملاً متفاوت هستند. اما این واضح ترین مدرکی است که نشان می دهد این دو اکنون به یک چالش واحد تبدیل شده اند که در دلِ یک چت ساده با هوش مصنوعی رخ می دهد. اینجاست که اهمیت طراحی سایت اصولی و سئوی تکنیکال – یعنی خدماتی که در دانش وب بهینه سازی دقیق آن ها را تضمین می کنیم – پررنگ تر می شود؛ زیرا اگر مستندات و ساختار صفحات سایت شما استاندارد نباشد، هوش مصنوعی برند شما را به اشتباه تفسیر و در نهایت از سبد پیشنهادات خود حذف می کند.
چرا هیچ کس متوجه صفرِ جا افتاده نمی شود؟
فردریک والایز (Frederick Vallaeys) در کتاب خود با عنوان «بازاریابِ تقویت شده با هوش مصنوعی» داستانی دارد که دقیقاً توضیح می دهد چرا یک خطای اعشاری تا مرحله انتشار جان سالم به در می برد. زمانی یک سیستم گزارش گیری خودکار، عملکرد یک کلمه کلیدی را «عالی» توصیف کرده بود، در حالی که هزینه جذب مشتری (CPA) آن بسیار بالاتر از هدف تعیین شده بود. در جایی از سیستم، کلمه «بالا» جایگزین کلمه «خوب» شده بود؛ در حالی که CPA بالا یک خبر بد است، نه خوب! با این حال هر کسی که خلاصه گزارش را روزنامه وار می خواند، سر تکان می داد و تایید می کرد، زیرا جمله از نظر روانیِ متن درست خوانده می شد، هرچند معنی آن کاملاً معکوس شده بود.
والایز این موضوع را به تحقیقات روانشناسی درباره پردازش پیش بینی کننده (Predictive Processing) مغز ربط می دهد؛ این ایده که خوانندگانِ مسلط، هر کلمه را به صورت مجزا رمزگشایی نمی کنند، بلکه بر اساس ساختار متن، کلمه بعدی را پیش بینی می کنند و از آن می گذرند. ذهن ما مفهوم کلیِ یک جمله را بر متنِ واقعی ارجحیت می دهد. یک فایل PDF با طراحی زیبا و فرمت بندی حرفه ای، راحت ترین بستر برای گول زدن مغز است و جا افتادن یک صفر در نرم افزار طراحی، نسخه بسیار قابل بخشش تری از همین خطاست.
به همین دلیل است که راهکار این مشکل، «بی اعتمادی به گزارشات» نیست؛ بلکه «حفظ یک ناظر انسانی در چرخه کار است که به جای تکیه بر حس و حال کلیِ پاراگراف، خودِ اعداد را بررسی کند». تفاوت ۳۳ تناقض با ۳۳۰ تناقض تنها یک ضریب ده نیست؛ این دو عدد سطوح کاملاً متفاوتی از اطمینان درباره واقعی بودنِ الگوی رفتاری یک هوش مصنوعی ایجاد می کنند. اگر تیم Clovion متوجه این موضوع نمی شد و اگر من پیگیری نمی کردم، آن اعدادِ لرزان و کوچک به عنوان حقایق علمی در مجلات تخصصی (که وظیفه شان کشف همین خطاهاست) دست به دست می شدند.
این تصویر بر اهمیت “ناظر انسانی در چرخه کار” تاکید دارد. یک تحلیلگر با دقت اعداد یک گزارش چاپی را با داده های روی صفحه نمایش مقایسه می کند تا از خطاهای احتمالی هوش مصنوعی یا اشتباهات طراحی گرافیکی جلوگیری کند.
Clovion چه چیزی را ادعا نمی کند و چرا این نشانه صداقت است؟
این گزارش با احتیاط بیان می کند که ارتباط بین درک هوش مصنوعی از کسب وکار شما و اینکه آیا شما را پیشنهاد می دهد یا خیر، «یک پیوند قوی و مداوم است، نه یک قانونِ علمیِ ثابت و علت ومعلولی».
من از حسن پرسیدم که یک تست واقعیِ علت ومعلولی چگونه خواهد بود؟ پاسخ او این بود: تغییرِ تنها یک متغیر (مثلاً محتوای جایگاه سازی عمومی یک برند) در حالی که بقیه موارد دست نخورده باقی بماند، و سپس بررسی اینکه آیا رفتار مدل های هوش مصنوعی نسبت به آن برند تغییر می کند یا خیر. شرکت Clovion هنوز این تست را انجام نداده است. او همچنین با صداقت به یک احتمالِ نه چندان خوشایند اعتراف کرد: احتمالاً جایگاه سازی واقعی یک برند در دنیای فیزیکی است که هم به توصیف هوش مصنوعی از آن شکل می دهد و هم شانس پیشنهاد شدنِ آن را تعیین می کند. در این صورت، جایگاه سازی (Positioning) اهرم اصلی است و «درکِ هوش مصنوعی» تنها یک معلول و نشانه است، نه علت.
این یک پاسخ فوق العاده صادقانه از شرکتی است که ابزارهای مانیتورینگ هوش مصنوعی می فروشد و دقیقاً به همین دلیل است که من به بقیه حرف های حسن اعتماد دارم. او هیچ داده ای درباره اینکه درک هوش مصنوعی از یک برند پس از تغییر محتوای سایتش با چه سرعتی عوض می شود، نداشت. او گفت: «ما تست قبل و بعد انجام ندادیم. این موضوع ارزش تست کردن دارد، اما نمی توان گفت در X هفته حتماً تضمین می شود.» طبق اعترافِ خودِ Clovion، هر کسی که به شما قولِ زمان بندیِ مشخصی برای تغییرِ نظر Claude یا Gemini درباره برندتان بدهد، صرفاً در حال حدس زدن است.
نتیجه گیری
بر اساس صحبت های من با حسن و آنچه داده های اصلاح شده نشان می دهند، سه اقدام اساسی وجود دارد که باید در دستور کار قرار دهید:
۱. کل مسیر مکالمه را ردیابی کنید، نه فقط پاسخ اول را: اگر وضعیت حضور برند خود در هوش مصنوعی را تنها با یک پرسشِ ساده (Prompt) بررسی می کنید، در حال ارزیابیِ بالایِ قیفی هستید که ۶۲٪ از محتویات خود را در همان جمله بعدی از دست می دهد! مانیتورینگ و سئوی خود را بر اساس سوالات تکمیلی که خریداران واقعی شما می پرسند بنا کنید.
۲. دستیارها را یکی یکی و به ترتیب اصلاح کنید: حسن صراحتاً گفت که یک تغییر کوچک در محتوای سایت، باعث تغییر رفتار هر سه مدل هوش مصنوعی به صورت همزمان نمی شود، زیرا آن ها از منابع متفاوتی تغذیه می کنند. ترتیب پیشنهادی او این است: ابتدا خطاهای فاحشِ اطلاعاتی (مثل عدم درج امکانات پایه در صفحات محصول) را اصلاح کنید، زیرا این کار بردهای سریعی برایتان به همراه دارد. سپس به سراغ کلیدواژه های مرتبط با بخش بندی مشتریان بروید و پاسخ های هر دستیار هوش مصنوعی را در چندین بار اجرای دستور بررسی کنید، نه اینکه تنها به یک پاسخ تکیه نمایید.
۳. به آمارهایی که منبع آن ها را ردیابی نکرده اید استناد نکنید: حتی گزارشِ خود شرکت Clovion نیز در فنی ترین و مهم ترین عدد خود به اصلاح نیاز داشت. قبل از اینکه یک مقاله بنویسید، برای مشتریان خود استراتژی تدوین کنید یا روی درصدهای مربوط به تحقیقات هوش مصنوعی حساب باز کنید، بپرسید این اعداد از کجا آمده اند و آیا کسی ریاضیاتِ آن را پس از خروج از نرم افزار گرافیکی بررسی کرده است یا خیر.
من در سئو شاهدِ گذر از دوران های حساسی بوده ام؛ از آپدیت های هسته مثل الگوریتم پاندا گرفته تا راه اندازی سیستم ایندکسِ مبتنی بر موبایل (Mobile-first indexing) و کاهشِ تدریجی جستجوهای بدون کلیک (Zero-click search). در تمام این تغییرات، برندگانی وجود داشتند که به جای تکرارِ تیترهای خبری، منابع اصلی را بررسی می کردند. وضعیت حضور کسب وکارها در هوش مصنوعی نیز دقیقاً همین مسیر را طی می کند.
برندهایی که از این غیب شدن های ۶۲ درصدیِ پیشنهادات هوش مصنوعی جان سالم به در می برند، آن هایی نیستند که صرفاً بیانیه های مطبوعاتیِ جذابی درباره استراتژی سئوی خود صادر می کنند. پیروزِ این میدان کسانی هستند که گزارش ها را آنقدر با دقت می خوانند که می پرسند عدد «۳۳» دقیقاً از کجا آمده است، و این پرسشگری را همواره حفظ می کنند.