

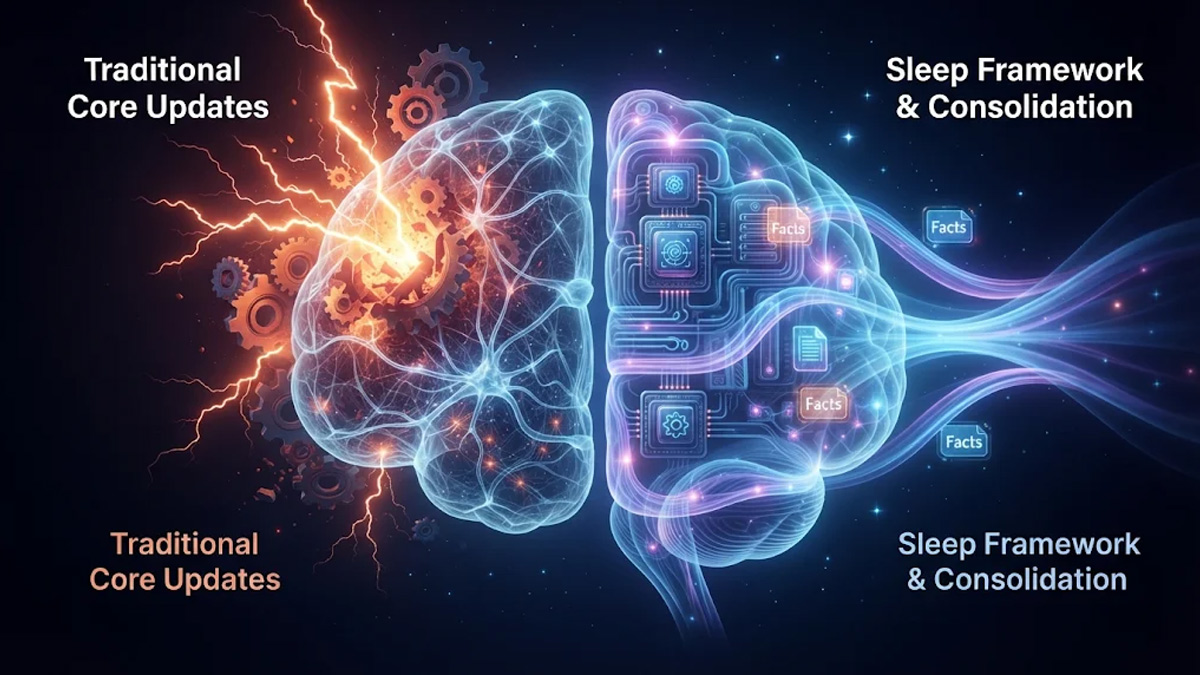
پژوهش جدید گوگل از مدلی رونمایی می کند که آموخته های خود را به صورت دوره ای در ساختار درونی اش تثبیت می کند. این یعنی «مرز دانش» گوگل دیگر یک تاریخ ثابت نیست، بلکه یک چرخه نامرئی و دائمی است.
همه ما به شنیدن اخبار آپدیت های بزرگ گوگل مثل «آپدیت هسته» (Core Update) عادت کرده ایم. اما مقاله ای که اخیراً توسط محققان گوگل منتشر شده، از آینده ای خبر می دهد که در آن مهم ترین تغییرات، بی صدا و بدون هیچ اعلانی اتفاق خواهند افتاد. به زبان ساده، مدل هوش مصنوعی گوگل قرار است خودش را هوشمندتر کند، و این موضوع برای هر کسب وکاری که بقایش به حضور در گوگل گره خورده، یک تحول بزرگ است.
در ۲۷ اکتبر، علی بهروز و وهاب میررکنی (دو محقق ایرانی گوگل) از چارچوبی به نام «چارچوب خواب» (sleep framework) رونمایی کردند. این متد به مدل های زبانی بزرگ (LLMs) اجازه می دهد تا در یک فاز آفلاین و برنامه ریزی شده، اطلاعات جدیدی را که در طول روز آموخته اند، به حافظه بلندمدت خود منتقل کنند. سپس با داده هایی که خودشان تولید می کنند، آموخته هایشان را تمرین و مرور می کنند.
برداشت سطحی و وایرال شده از این خبر این است که «هوش مصنوعی گوگل خود به خود و بدون نظارت در حال تغییر است!» که البته دقیق نیست. خود مقاله تأکید می کند که تمام این فرآیندها تحت یک معماری ثابت و با قوانین تعیین شده توسط انسان انجام می شود. اما نکته ای که در این تحلیل های سطحی از قلم می افتد و برای ما در دنیای سئو حیاتی است، این است: اگر این طراحی در مدل های اصلی گوگل پیاده سازی شود، «مرز دانش» (knowledge cutoff) مدل های گوگل دیگر یک تاریخ مشخص (مثلاً «دانش من تا سال ۲۰۲۳ است») نخواهد بود، بلکه به یک چرخه آپدیت دائمی و نامرئی تبدیل می شود که هیچ کس خارج از گوگل از آن خبردار نخواهد شد.
این یعنی خداحافظی با مفهوم آپدیت های بزرگ و قابل رصد. آپدیت جدید گوگل دیگر قرار نیست رتبه بندی «ایندکس ها» را تغییر دهد؛ بلکه قرار است «باورها و دانش» خود مدل هوش مصنوعی را دستخوش تغییر کند. و چون این یک رویداد لحظه ای نیست، هیچ اعلانی هم برای آن وجود نخواهد داشت.
گوگل دقیقاً چه چیزی را منتشر کرده است؟
مقاله، یک چرخه حیات دو مرحله ای را توصیف می کند:
۱. فاز بیداری (Wake Phase)
در این مرحله، مدل ورودی ها (اطلاعات جدید) را دریافت کرده و آن ها را در اجزای حافظه کوتاه مدت و سریع خود نگه می دارد. این فرآیند تقریباً مشابه کاری است که امروزه «پنجره زمینه» (Context Window) در چت بات ها انجام می دهد.
۲. فاز خواب (Sleep Phase)
در این مرحله، مدل دیگر ورودی جدیدی نمی پذیرد و دو فرآیند داخلی را آغاز می کند:
تثبیت (Consolidation): در این مرحله، مدل بخش های جدید و غیرفعالی از معماری درونی خود (که «ترکیبی از متخصصان» یا Mixture-of-Experts نام دارد) را فعال می کند. سپس اطلاعات کوتاه مدت را از طریق فرآیندی به نام «بذرگذاری دانش» (knowledge seeding) به این پارامترهای جدید و تازه منتقل می کند. به زبان ساده، به جای بازنویسی اطلاعات قدیمی، حقایق جدید در خانه های مخصوص به خودشان در مغز مدل جای می گیرند. پس از آن، پارامترهای موقت ریست می شوند تا فضا برای یادگیری های بعدی آزاد شود.
رویاپردازی (Dreaming): این بخش بسیار جالب است. مدل با ترکیب کردن متخصصان مختلف خود، داده های مصنوعی جدیدی تولید می کند. انگار که مدل با خودش در مورد موضوعات مختلف فکر می کند و ارتباطات جدیدی بین آن ها کشف می کند. سپس با استفاده از یک فیلتر هوشمند، بهترین و مفیدترین این داده های مصنوعی را انتخاب کرده و روی آن ها مجدداً آموزش می بیند تا دانش خود را عمیق تر کند.
نتایج گزارش شده از این تحقیق شگفت انگیز است: در ترجمه متوالی به زبان هایی که مدل قبلاً هرگز ندیده بود، چارچوب خواب تقریباً هیچ کدام از زبان های قبلی را فراموش نکرد. در حالی که مدل های استاندارد، زبان های قدیمی تر را به کل فراموش می کردند. این مدل همچنین در به خاطر سپردن اطلاعات از اسناد طولانی و استدلال ریاضی، عملکرد بهتری نسبت به روش های پیشین داشته است.
این ایده یک شبه به وجود نیامده است. این یک مسیر تحقیقاتی چندساله در گوگل است که نشان دهنده یک حرکت استراتژیک و هدفمند است. همانطور که گوگل طی یک مسیر ۵ ساله، نحوه رتبه بندی نتایج جستجو را متحول کرد، این مسیر ۲ ساله نیز در حال تغییر بنیادین «دانش» خود هوش مصنوعی است.
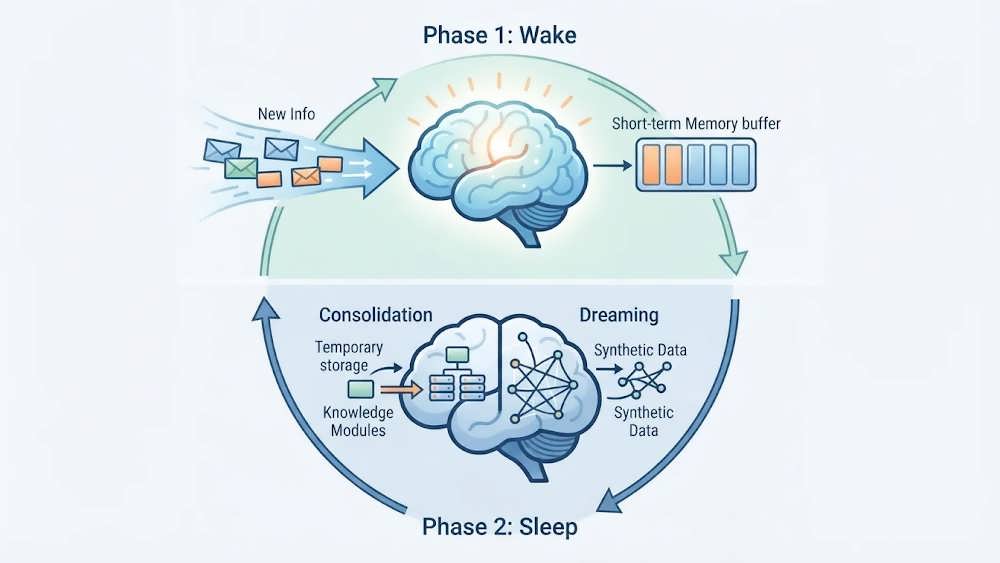
ذیل توضیحات مربوط به فازهای بیداری و خواب قرار می گیرد. این اینفوگرافیک چرخه حیات دو مرحله ای را به صورت بصری ساده سازی می کند.
این تحقیق چه چیزی «نیست» و چرا نباید آن را نادیده گرفت؟
باید واقع بین باشیم. این یک مقاله تحقیقاتی است، نه یک محصول نهایی. گوگل هیچ صحبتی از زمان بندی عرضه یا اینکه کدام مدل (مثلاً جمینی) از این قابلیت استفاده خواهد کرد، نکرده است. آزمایش ها روی مدل های منبع باز و کوچکتر انجام شده اند و هنوز هزینه محاسباتی یک «چرخه خواب» مشخص نیست.
اما این هشدارها نباید ما را گمراه کنند. الگوی همیشگی گوگل این بوده است که مسیرهای تحقیقاتی خود را منتشر کرده و سپس قطعاتی از آن ها را در محصولات نهایی خود پیاده سازی می کند. سوال اصلی برای یک متخصص سئو یا مدیر کسب وکار این نیست که «آیا دقیقاً همین متد عرضه می شود؟» بلکه این است که «این طراحی چه چیزی در مورد مسیر آینده گوگل به ما می گوید؟»
و پاسخ واضح است: آینده متعلق به مدلی است که حافظه بلندمدت آن به صورت دوره ای و نامرئی بازنویسی می شود.
دورانی که آپدیت ها برای اولین بار بی صدا شدند
هرکس که چند سالی در حوزه سئو فعالیت کرده باشد، این تغییر را قبلاً یک بار تجربه کرده است. گوگل می گوید سالانه هزاران بار الگوریتم جستجوی خود را آپدیت می کند اما فقط آن هایی را که «قابل توجه» می داند، اعلام می کند. آپدیت های هسته که ما می شناسیم، تنها تعداد انگشت شماری از این تغییرات هستند. بقیه به طور مداوم و بی صدا اتفاق می افتند.
چیزی که «چارچوب خواب» آن را تغییر می دهد، لایه ای است که این سکوت در آن اتفاق می افتد. تا به امروز، تغییرات بی صدا در لایه «بازیابی» (Retrieval) اطلاعات بود؛ یعنی گوگل تصمیم می گرفت کدام صفحات جدید را سریع تر بخواند و در پاسخ ها بیاورد. اما «تثبیت» (Consolidation)، «باورهای» درونی خود مدل را بدون نیاز به جستجوی مجدد تغییر می دهد.
این دو تفاوت بزرگی برای یک برند دارند. یک حقیقت «بازیابی شده» دارای منبع است، با احتیاط بیان می شود و در بازدید بعدی ربات از صفحه، قابل جایگزینی است. اما یک حقیقت «تثبیت شده»، با اطمینان چیزی که مدل «می داند» بیان می شود و این تفاوت در اطمینان، نحوه نمایش برند شما را در پاسخ های هوش مصنوعی شکل می دهد.
«آموخته شدن» همان «ایندکس شدن» جدید است
نکته کلیدی که در مقاله وجود دارد این است که فرآیند «تثبیت» گزینشی است. مدل قرار نیست تمام جزئیات حافظه کوتاه مدت خود را کپی کند. در مرحله «رویاپردازی» نیز نمونه های تولیدی خود را با یک فیلتر مبتنی بر گرادیان (gradient-based filter) ارزیابی می کند.
این فیلتر، در واقع یک تابع رتبه بندی (Ranking Function) جدید است.
این فیلتر تصمیم می گیرد کدام حقایق به عنوان دانش پایدار در حافظه بلندمدت مدل باقی بمانند و کدام ها فراموش شوند. دیده شدن توسط مدل در «فاز بیداری» به معنای آموخته شدن نیست. «آموخته شدن» همان معنایی را پیدا می کند که «ایندکس شدن» در گذشته داشت و تصمیم گیرنده آن، یک محاسبه پیچیده است که هیچ کس خارج از گوگل به آن دسترسی ندارد.
این موضوع سه پیامد مهم برای کسب وکارها دارد:
1- فیلتر به نفع حقایق سازگار عمل می کند
یک الگوریتم انتخاب مبتنی بر گرادیان، نمونه هایی را نگه می دارد که «خطا» را به طور کلی کاهش دهند. حقیقتی که با تمام اطلاعات دیگری که مدل قبلاً دیده (صفحه رقیب، یک دایرکتوری قدیمی، یا حتی محتوای قدیمی تر خود شما) سازگار باشد، شانس بیشتری برای تثبیت شدن دارد. این یعنی اطلاعات ضد و نقیض در مورد شرکت شما دیگر فقط یک ریسک در هنگام جستجو نیست، بلکه یک ریسک تثبیت است. نسخه ای از برند شما که در ذهن گوگل باقی می ماند، لزوماً نسخه ای که شما ترجیح می دهید نیست، بلکه سازگارترین نسخه است.
2- رویاپردازی یعنی مدل روی داده هایی که شما منتشر نکرده اید، تمرین می کند
نمونه های مصنوعی با ترکیب متخصصان از دامنه های مختلف ایجاد می شوند. این یعنی تصور مدل از شرکت شما می تواند بدون هیچ ورودی جدیدی از طرف شما یا هر کس دیگری تغییر کند. هیچ رقیبی حرکتی نکرده، هیچ صفحه ای تغییر نکرده، هیچ آپدیتی اجرا نشده، اما پاسخ هوش مصنوعی در مورد شما متفاوت است. این می تواند توضیحی برای سوالی باشد که بسیاری امسال پرسیده اند: «چرا پاسخ ها در مورد ما تغییر کرده در حالی که هیچ چیز قابل مشاهده ای تغییر نکرده است؟»
3- پنجره فرصت برای اصلاح (The Consolidation Window)
بین ورود یک حقیقت به حافظه سریع و تثبیت نهایی آن، یک «پنجره فرصت» وجود دارد. در این بازه، اصلاح یک اشتباه ارزان است، زیرا هنوز چیزی به صورت پایدار ثبت نشده است. اما پس از تثبیت، اصلاح یک حقیقت غلط دیگر فقط به آپدیت یک صفحه و انتظار برای خزش مجدد ربات خلاصه نمی شود. شما با فرآیند «از یاد بردن» (unlearning) در یک مدل هوش مصنوعی طرف هستید که خود یک مسئله تحقیقاتی پیچیده و حل نشده است. طول و زمان این پنجره فرصت برای شما نامشخص خواهد بود.
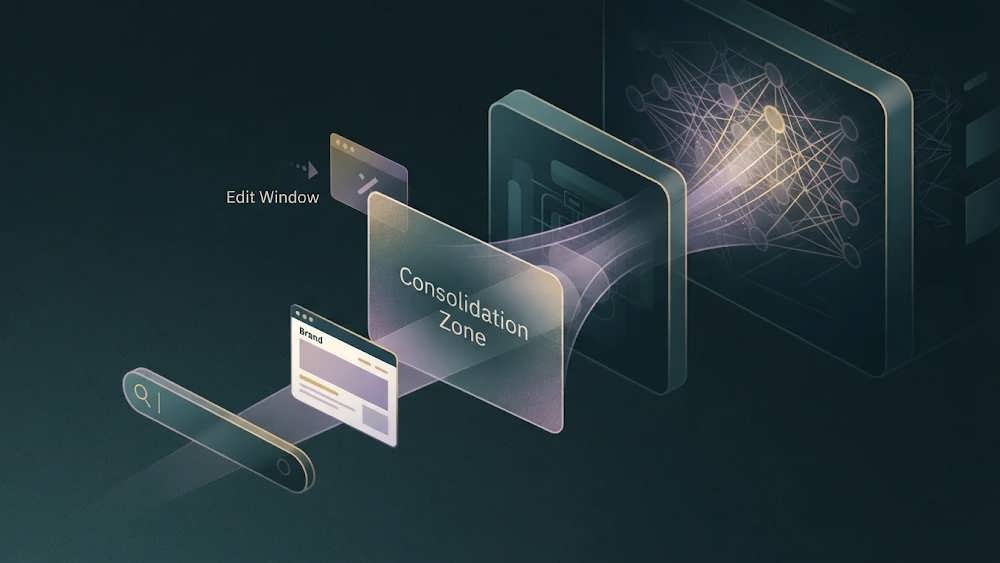
در انتهای توضیحات مربوط به «پنجره فرصت برای اصلاح» قرار می گیرد. این عکس به صورت بصری مفهوم نامرئی شدن فرآیند ایندکس شدن (که حالا «آموخته شدن» است) را نشان می دهد.
چه کاری باید از همین الان انجام دهیم؟
پاسخ هوشمندانه این است که فرآیندهای خود را دیگر بر اساس «رویدادهای» قابل پیش بینی (مثل آپدیت هسته) بنا نکنیم.
- ممیزی دانش پارامتریک (Audit what is already parametric): همین حالا از دستیارهای هوش مصنوعی مختلف (جمینی، ChatGPT و…) سوالاتی بپرسید که آن ها را مجبور به پاسخ از حافظه شان کند (نه با جستجوی زنده). موجودی اطلاعاتی که از برند شما در حافظه آن ها وجود دارد را ثبت کنید. حقایق غلط در این موجودی، همان هایی هستند که به احتمال زیاد در آینده تقویت خواهند شد.
- صفحات حقایق کانونی (Canonical Fact Pages) منتشر کنید: دانش جدید در مقاله گوگل به صورت «سند» به مدل داده می شد. یک صفحه مستقل، دارای تاریخ و کاملاً شفاف در مورد حقایق کلیدی نهاد (entity) شما (مثلاً تاریخ تأسیس، آدرس، مدیران، محصولات اصلی) ایجاد کنید. این صفحه باید عاری از زبان بازاریابی و کاملاً (declarative) باشد. این همان فرمتی است که فرآیند «بذرگذاری دانش» می تواند به راحتی از آن تغذیه کند. اینجاست که داشتن یک وب سایت با ساختار فنی صحیح و معنایی، که ما در دانش وب همواره بر آن تأکید می کنیم، نقشی حیاتی ایفا می کند.
- تناقضات را در تمام دارایی های دیجیتال خود برطرف کنید: اگر الگوریتم، نسخه سازگارتر را انتخاب می کند، وظیفه شما این است که نسخه «صحیح» را به نسخه «سازگار» تبدیل کنید. اطلاعات ضد و نقیض در سایت خودتان، صفحه اینستاگرام، پروفایل لینکدین و حتی دایرکتوری های آنلاینی که شما را لیست کرده اند را پیدا و یکسان سازی کنید. این بخشی از یک استراتژی جامع سئو و محتواست که در آژانس هایی مانند دانش وب به آن پرداخته می شود.
- همین حالا اشتباهات شناخته شده را از منبع اصلاح کنید: تا زمانی که این مکانیزم هنوز یک مقاله تحقیقاتی است، اشتباهات را در وب سایت خود اصلاح کنید. سپس مجدداً از هوش مصنوعی بپرسید تا تأیید کنید که پاسخ واقعاً تغییر کرده است، زیرا یک صفحه اصلاح شده و یک پاسخ اصلاح شده دو رویداد متفاوت هستند.
- به جای تحلیل رویدادها، به پایش روندها رو بیاورید: اگر آپدیت های دانش به صورت مداوم اتفاق می افتند، سوال دیگر این نیست که «کدام آپدیت باعث این تغییر شد؟». سوال این است که «این انحراف از چه زمانی شروع شد و کدام حقایق تغییر کردند؟». این کار نیازمند نمونه برداری منظم از پاسخ های هوش مصنوعی و مقایسه آن ها در طول زمان است.
- منتظر سیگنال باشید: هر زمان که در اطلاعیه های مدل های گوگل (Gemini) یا پلتفرم های ابری آن (Vertex AI) عباراتی مانند «یادگیری مداوم»، «آپدیت بین نسخه ها» یا «یادگیری از اسناد سازمانی شما» را شنیدید، بدانید که اولین قطعه از این طراحی به عنوان یک «ویژگی» (Feature) عرضه شده است، نه یک آپدیت.
نتیجه گیری
مقاله «چارچوب خواب» گوگل صرفاً یک پژوهش آکادمیک نیست؛ بلکه پیش نمایش آینده ای است که در آن سئو از مجموعه ای از تکنیک های واکنشی به یک فرآیند مدیریت برند و اطلاعات به صورت مداوم و پیشگیرانه تبدیل می شود. دورانی که می توانستیم منتظر آپدیت های بزرگ بمانیم و سپس به تحلیل و اصلاح بپردازیم، رو به پایان است. در دنیای جدید، «برند» شما چیزی است که هوش مصنوعی گوگل «باور» دارد، و این باور به صورت نامرئی و پیوسته شکل می گیرد.
در این چشم انداز جدید، دیگر داشتن یک سایت یا اجرای کمپین های پراکنده کافی نیست. موفقیت از آن کسب وکارهایی خواهد بود که یک اکوسیستم دیجیتال یکپارچه، سازگار و معتبر حول برند خود ایجاد می کنند و به صورت خستگی ناپذیر بر صحت اطلاعات خود در تمام پلتفرم ها نظارت دارند. در دانش وب، ما خود را برای این آینده آماده کرده ایم و به مشتریان خود کمک می کنیم تا با ساختن زیربنای دیجیتال مستحکم و استراتژی محتوای هدفمند، نه تنها از این امواج سهمگین جان سالم به در ببرند، بلکه بر آن سوار شوند و از رقبا پیشی بگیرند.