

فایل Robots.txt بر رعایت داوطلبانه قوانین توسط ربات ها تکیه دارد، در حالی که فایروال (WAF)، شبکه توزیع محتوا (CDN) و مسدودسازی در سطح سرور، این محدودیت ها را به اجبار اعمال می کنند. در این مقاله بررسی می کنیم که کدام لایه می تواند خزنده های هوش مصنوعی را برای همیشه متوقف کند.
تصمیم گیری در مورد مسدود کردن خزنده های هوش مصنوعی (AI Crawlers)، یک تصمیم تجاری و استراتژیک است که این روزها بسیاری از متخصصان سئو و وبمسترها درباره آن بحث و تبادل نظر می کنند. اما زمانی که تصمیم نهایی را برای محدود کردن این ربات ها گرفتید، بهترین راه برای مسدود کردن آن ها چیست؟
برای این کار، دو رویکرد اصلی وجود دارد که باید در نظر بگیرید: اعمال محدودیت از طریق فایل robots.txt و مسدودسازی در لایه زیرساخت و سرور.
بررسی دو رویکرد اصلی
هر دوی این رویکردها مزایا و معایب خاص خود را دارند. بیایید با بررسی نحوه عملکرد آن ها و تفاوت های بنیادین میان این دو روش شروع کنیم.
مسدودسازی از طریق فایل Robots.txt
مسدود کردن خزنده های هوش مصنوعی با استفاده از فایل robots.txt دقیقاً مشابه همان فرآیندی است که برای مسدود کردن هر نوع ربات دیگری (مثل ربات های گوگل یا بینگ) استفاده می کنید.
هر ربات هوش مصنوعی، نام شناسایی (User-agent) مختص به خود را دارد؛ به عنوان مثال، GPTBot و OAI-SearchBot متعلق به شرکت OpenAI (سازنده ChatGPT) هستند. برای مسدود کردن آن ها، به سادگی باید یک قانون Disallow به فایل خود اضافه کنید و نام خزنده را در آن مشخص نمایید. به عنوان مثال، برای جلوگیری از خزش GPTBot در تمامی بخش های وب سایتتان، قطعه کد زیر را اضافه می کنید:
User-agent: GPTBot
Disallow: /
اگر فقط بخش های خاصی از وب سایتتان وجود دارد که می خواهید جلوی ورود ربات های هوش مصنوعی را به آن ها بگیرید، می توانید دقیقاً به همان روش بالا مسیرها را مشخص کنید. مثلاً برای جلوگیری از بررسی صفحات محصولات سایت توسط GPTBot، باید پوشه ای که این صفحات در آن قرار دارند را در فایل قرار دهید:
User-agent: GPTBot
Disallow: /products/
مسدودسازی در سطح سرور
راه های مختلفی برای مسدود کردن ربات ها در سطح سرور وجود دارد: مسدودسازی از طریق خود وب سرور، از طریق شبکه توزیع محتوا (CDN) یا فایروال برنامه های کاربردی وب (WAF).
در این حالت، سرور درخواست ورودی (مانند IP ربات، اطلاعات هدر مرورگر و غیره) را می خواند و قوانین خاصی را که برای آن عامل (Agent) پیکربندی کرده اید (مانند مسدود کردن، اجازه دادن یا ریدایرکت)، اعمال می کند. به عنوان مثال، می توانید تنظیم کنید که GPTBot فرمان “Deny” (رد دسترسی) دریافت کند. این کار به طور قطعی مانع از دسترسی این ربات به محتوای سایت شما می شود.
در مورد شبکه توزیع محتوا (CDN)، مفهوم دقیقاً به همین شکل است، اما در مراحل اولیه ترِ ورودِ یک ربات به سایت اتفاق می افتد. CDN درخواستِ دریافتِ محتوا از سوی ربات را پیش از آنکه حتی به سرور اصلی شما برسد، رهگیری کرده و متوقف می کند. این کار اساساً باعث صرفه جویی در پهنای باند سرور می شود، زیرا ربات اصلاً با سرور شما تعاملی برقرار نمی کند. برخی از CDNها این فناوری را به صورت پیش فرض و بدون نیاز به پیکربندی پیچیده ای ارائه می دهند. به عنوان مثال، کلودفلر (Cloudflare) امکان مسدودسازی پیش فرض را بر اساس نوع ربات (خزنده جستجو، عامل هوش مصنوعی یا ربات آموزش مدل های زبانی) ارائه می دهد و همچنین به شما اجازه می دهد ربات ها را به صورت تک به تک و با دقت بالا مدیریت کنید.
در سطح فایروال برنامه های کاربردی وب (WAF)، ربات ها با دقت و سخت گیری بسیار بیشتری نسبت به CDN بررسی می شوند. WAF به عنوان یک لایه امنیتی قدرتمند عمل می کند که می تواند علاوه بر اطلاعات هدرِ ارسال شده، رفتار درخواست را نیز تحلیل کند. این یعنی WAF قادر است ربات های مخربی را که سعی می کنند هویت سایر User-agentها را جعل کنند (Spoofing)، شناسایی کند. البته باید در نظر داشت که پیکربندی دقیق WAF و سرور می تواند چالش برانگیز باشد و نیازمند تخصص بالایی است؛ به همین دلیل در مجموعه دانش وب، ما در کنار خدمات طراحی سایت و سئو، زیرساخت های امنیتی قدرتمندی را نیز برای مشتریانمان پیاده سازی می کنیم تا بدون دغدغه فنی، ترافیک ارزشمند سایت خود را مدیریت کنند. در اکثر زیرساخت های فناوری، WAF کارآمدترین روش برای شناسایی خزنده های پیشرفته تر هوش مصنوعی است که سعی می کنند از رادار سیستم های مسدودکننده فرار کنند. WAF مورد استفاده شرکت شما ممکن است بخشی از CDN شما باشد (مانند Cloudflare WAF) یا یک برنامه مستقل (مانند AWS WAF) باشد.
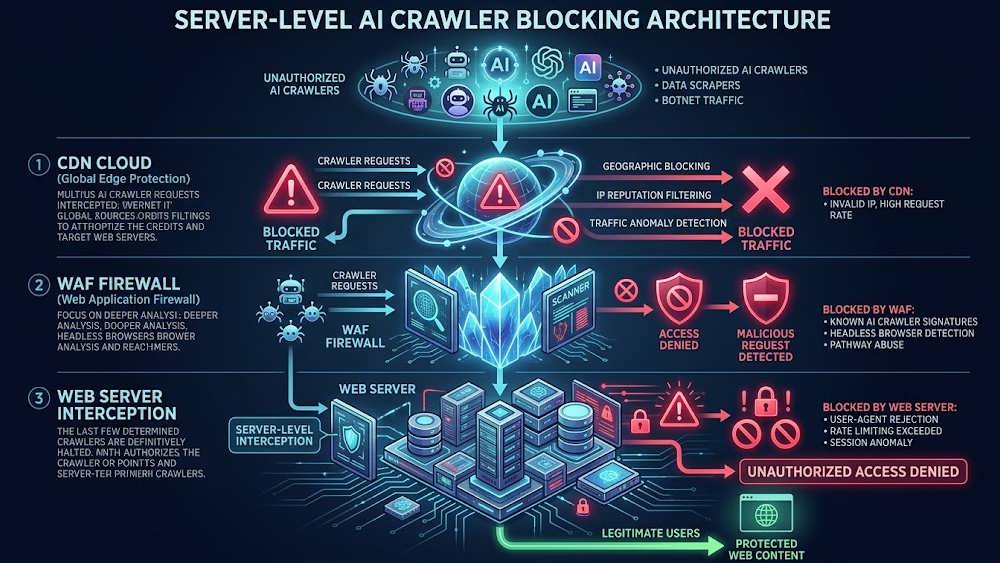
نمایش گرافیکی نحوه رهگیری و متوقف کردن درخواست های خزنده های هوش مصنوعی توسط فایروال (WAF) و CDN پیش از رسیدن به سرور اصلی.
فایل Robots.txt: مزایا و معایب
فایل robots.txt احتمالاً در دسترس ترین و ساده ترین راه برای متخصصان جستجو جهت کنترل ربات ها است. معمولاً سئوکاران به راحتی به این فایل در دامنه خود دسترسی دارند، یا می توانند با یک درخواست ساده از تیم برنامه نویسی بخواهند آن را به روزرسانی کنند. با این حال، استفاده از این روش مزایا و معایب دیگری نیز دارد:
مزایا
مکانیسم Disallow در robots.txt به طور رسمی توسط معتبرترین و بزرگترین شرکت های هوش مصنوعی پشتیبانی می شود. از جمله این ربات ها می توان به GPTBot و OAI-SearchBot از شرکت OpenAI، ربات های ClaudeBot، Claude-User و Claude-SearchBot از شرکت Anthropic، Google-Extended متعلق به گوگل و PerplexityBot از شرکت پرپلکسیتی اشاره کرد.
این روش به شما اجازه می دهد به صورت کاملاً انتخابی مشخص کنید ربات ها اجازه ورود به کدام صفحات را ندارند و همچنین قوانین مسدودسازی را برای هر خزنده به صورت جداگانه تنظیم کنید.
معایب
با این وجود، این روش دارای ریسک ها و معایبی است. بزرگترین خطر این است که رعایت قوانین robots.txt کاملاً داوطلبانه است و به صورت مرکزی نظارت نمی شود. به عبارت دیگر، اگرچه سازندگان ربات های هوش مصنوعی ممکن است ادعا کنند که ربات هایشان به قوانین robots.txt احترام می گذارند، اما این فایل صرفاً مجموعه ای از «درخواست ها» است، نه یک مانع فیزیکی یا مسدودکننده واقعی.
آن را مانند یک تابلوی «ورود ممنوع» در مقابل یک دروازه کاملاً باز تصور کنید. هیچ چیزی واقعاً جلوی ورود ربات ها را نمی گیرد، مگر اینکه خودشان طوری برنامه نویسی شده باشند که به قوانین این تابلو احترام بگذارند.
عیب دیگر این است که اگر سیستم مدیریت محتوای (CMS) سایت امکان دسترسی آسان به تنظیمات robots.txt را بدهد، افراد غیرفنی تیم ممکن است با یک اشتباه کوچک (مثل یک دستور Disallow اشتباه) بیش از حدِ انتظار، ربات ها را مسدود کنند. مثلاً اگر شخصی به اشتباه کد زیر را وارد کند، فاجعه به بار می آید و تمام خزنده ها (از جمله گوگل) از کل سایت مسدود می شوند:
User-agent: *
Disallow: /
علاوه بر این، فایل robots.txt با انتشار User-agent های جدید، به صورت خودکار به روزرسانی نمی شود. این یعنی هر زمان که بخواهید مانع دسترسی یک ربات هوش مصنوعی جدید به سایتتان شوید، یک نفر باید به صورت دستی قانون Disallow جدیدی را به فایل اضافه کند.
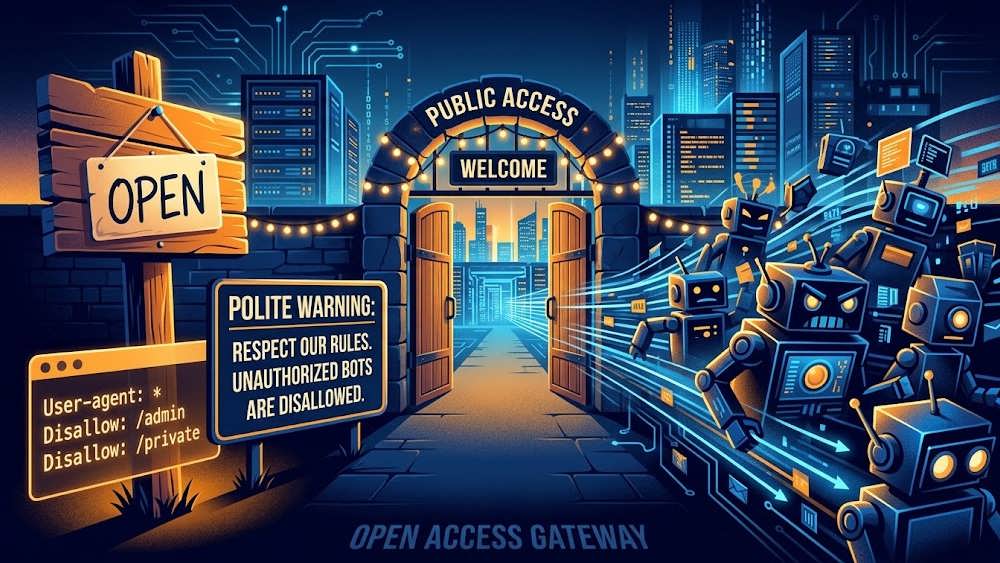
تصویر مفهومی از تابلوی دستور Disallow در فایل robots.txt که نفوذپذیری آن در برابر ربات های غیرمتعهد و عبور داوطلبانه آن ها را نشان می دهد.
لایه سرور: مزایا و معایب
مسدود کردن ربات ها در سطح سرور، CDN یا WAF بسته به نحوه پیاده سازی، مزایای متفاوتی دارد.
مزایا
پیاده سازی های CDN و WAF، درخواست های ربات ها را پیش از رسیدن به سرور متوقف می کنند. این کار باعث صرفه جویی در پهنای باند، کاهش فشار پردازشی روی سرور و در نهایت کاهش هزینه های مرتبط با هاست و سرور می شود.
بزرگترین مزیت مسدودسازی در سطح سرور (فارغ از اینکه کدام لایه را انتخاب کنید)، قطعی بودن این محدودیت است. اگر robots.txt فقط یک تابلوی مؤدبانه «ورود ممنوع» باشد، مسدودکننده های سرور، CDN و WAF مانند یک قفل محکم روی دروازه هستند. این روش ها به تمایل خزنده برای رعایت قوانین وابسته نیستند؛ آن ها ربات ها را در همان لحظه شناسایی کرده و جلوی دسترسی آن ها به محتوا را می گیرند (چه ربات مطیع باشد چه نباشد).
یکی دیگر از مزایای این روش، گزارش گیری دقیق این نرم افزارها از ربات های مسدود شده است. این «قفل»، تمام تلاش ها برای باز کردنش را ثبت می کند! این اطلاعات برای تحلیل اینکه چه ربات هایی به دنبال دسترسی به سایت شما هستند بسیار مفید است. برای سایت هایی که توجهِ ناخواسته زیادی از سوی ربات های هوش مصنوعی دریافت می کنند، این گزارش ها حتی می تواند در پیگیری های قانونی و حقوقی علیه مالکان آن ربات ها مورد استفاده قرار گیرد.
معایب
معایب روش های مسدودسازی در لایه سرور در درجه اول به سربار نگهداری و پیچیدگی فنی آن ها برمی گردد. اکثر سرورهای وب دارای دسترسی های بسیار محدود و محافظت شده ای هستند، بنابراین تنها افراد متخصصی که دقیقاً می دانند چه کار می کنند، مجاز به دسترسی به فایل های سرور، WAF یا CDN خواهند بود. این بدان معناست که تغییر در قوانین مسدودسازی احتمالاً باید از طریق یک برنامه نویس یا متخصص شبکه انجام شود و سئوکار به طور مستقیم قادر به اعمال آن نیست. این نیاز به یک واسطه فنی، هزینه ها، منابع و زمان بیشتری را می طلبد (به خصوص اگر سرور شما توسط یک شرکت شخص ثالث یا آژانس توسعه وب مدیریت شود).
همچنین در هر لایه امنیتی، احتمال جعل هویت ربات ها (Bot Spoofing) وجود دارد. اگرچه WAF قوی ترین خط دفاعی شماست، اما باز هم ممکن است ربات های فوق پیشرفته بتوانند از بررسی های اعتبارسنجی آن عبور کنند. این یعنی هیچ روش کاملاً صددرصدی و غیرقابل نفوذی برای مسدود کردن ربات های هوش مصنوعیِ سرکش از طریق سرور وجود ندارد؛ با این حال، این روش برای مقابله با اکثر آن ها همچنان بسیار قدرتمند و مؤثر است.
نتیجه گیری
هیچ پاسخ یکتا و مطلقی برای این سوال وجود ندارد. تصمیم گیری به ساختار فنی وب سایت شما، بودجه، هزینه ها و ساختار مدیریتی تیم تان بستگی دارد.
در یک سناریوی ایده آل، شما باید ربات ها را در تمام لایه های زیرساخت سرور مسدود کنید. سرور راهی عالی برای مسدود کردن User-agentهای شناخته شده است و می تواند الگوهای ساده رفتار ربات ها را شناسایی کند. مسدودکننده های CDN بسیار مؤثرند و از مصرف بی رویه پهنای باند جلوگیری می کنند. و در نهایت WAF مؤثرترین ابزار برای شناسایی ربات های جعل کننده هویت و جلوگیری از دسترسی استخراج کننده های پیشرفته هوش مصنوعی (AI Scrapers) به سایت شماست. البته ممکن است شما همیشه دسترسی آسانی برای پیکربندی WAF خود نداشته باشید (یا اصلاً سایت شما فاقد WAF باشد).
از سوی دیگر، فایل robots.txt ساده ترین روش برای اعلام عدم رضایت شما از ورود ربات های خاص است و در برابر ربات های مسئولیت پذیر (مثل محصولات OpenAI یا گوگل) به خوبی جواب می دهد. با این حال، به راحتی می توان آن را نادیده گرفت؛ بنابراین این روش صرفاً یک عامل «بازدارنده» است، نه یک روش قطعی برای «پیشگیری».
به طور خلاصه، اگر نیاز شدیدی به مسدود کردن ربات های خاص هوش مصنوعی دارید، پیشنهاد می کنم تا جای ممکن این کار را در بالاترین لایه زیرساخت سرور انجام دهید: اگر می توانید در مرحله اول از طریق WAF، اگر نمی توانید از طریق CDN، و در نهایت به عنوان آخرین راهکار، مستقیماً از طریق وب سرور این کار را پیش ببرید.
اگر فقط می خواهید یکی دو مورد از معتبرترین خزنده های هوش مصنوعی را متوقف کنید، احتمالاً تکیه بر robots.txt به عنوان یک عامل بازدارنده برای شما کافی خواهد بود. با این حال، همیشه توصیه می کنم لاگ های سرور (Server Logs) خود را زیر نظر بگیرید تا ببینید آیا ربات هایی وجود دارند که قانون Disallow در فایل روباتکس شما را دور زده باشند یا خیر.