

یک اصلاح ۵ کاراکتری، خطای حسابرسی بخش جدید «مرورگرهای عامل محور» (Agentic Browsing) لایت هاوس را به یک تایید سبز رنگ تبدیل کرد. اما این موضوع درباره آنچه که لایت هاوس واقعاً می سنجد، چه چیزی را به ما نشان می دهد؟
بخش جدید حسابرسی لایت هاوسِ گوگل کروم که با عنوان «مرورگرهای عامل محور» (Agentic Browsing) معرفی شده است، فایل های .txt شما را دقیقاً مانند یک سند مارک داون (Markdown) پردازش می کند. اگر فایل llms.txt شما (که برای راهنمایی ربات های هوش مصنوعی در سایت قرار می گیرد) از سینتکسِ لینک دهی مارک داون استفاده نکند، شما در این بررسی مردود می شوید؛ حتی اگر تک تک لینک های موجود در فایل کاملاً دقیق باشند و به درستی کار کنند.
من این حسابرسی را روی سایت خودم اجرا کردم. از شش فاکتور بررسی شده، دو مورد با موفقیت پاس شدند، سه مورد وضعیت «غیرقابل اعمال» (not applicable) گرفتند و یک مورد با خطا مواجه شد. این خطا مربوط به فایل llms.txt بود که عیناً این پیغام را نمایش می داد: «به نظر می رسد فایل حاوی هیچ لینکی نیست.» راه حل این مشکل تنها اضافه کردن پنج کاراکتر به ازای هر لینک بود. جالب اینجاست که فرمت فایل همچنان به عنوان متن ساده (plain text) خوانده می شود و تنها چیزی که تغییر کرد، نتیجه حسابرسی لایت هاوس بود.
نسخه ۱۳.۳.۰ ابزار لایت هاوس، دسته بندی Agentic Browsing را در کنار سایر بخش های نام آشنای خود یعنی عملکرد (Performance)، دسترسی پذیری (Accessibility)، سئو (SEO) و بهترین شیوه ها (Best Practices) منتشر کرد. تیم سئو در دانش وب همواره در طراحی سایت و بهینه سازی، روی سبز بودن این فاکتورها تاکید ویژه ای دارد. در مجموعه پیش فرض این دسته بندی جدید، شش حسابرسی وجود دارد:
- خوش ساخت بودن درخت دسترسی پذیری ایجنت ها (agent-accessibility-tree)
- تغییرات چیدمان تجمعی (cumulative-layout-shift)
- قابلیت کشف فایل llms.txt (llms-txt)
- و سه بررسی مربوط به پروتکل WebMCP (شامل webmcp-registered-tools، webmcp-form-coverage و webmcp-schema-validity).
این دسته بندی به جای یک امتیاز ۰ تا ۱۰۰، یک نسبت قبولی کسری (مثلاً از ۶ فاکتور) به شما می دهد، زیرا استانداردهای وب عامل محور (وب برای ایجنت های هوش مصنوعی) هنوز در حال توسعه و تکامل هستند.
رد شدن ۱ مورد از ۶ حسابرسی در سایت Nohacks.co
من این حسابرسی را از طریق رابط خط فرمان (CLI) لایت هاوس با این دستور اجرا کردم:
npx lighthouse@latest https://nohacks.co --only-categories=agentic-browsing.
شش فاکتور بررسی شد. سه مورد از آن ها که همگی به پروتکل WebMCP مربوط بودند، وضعیت «غیرقابل اعمال» (not-applicable) دریافت کردند. لایت هاوس هیچ دلیلی برای این وضعیت ارائه نمی دهد، صرفاً وضعیت را ثبت کرده و عبور می کند. سایت nohacks.co در واقع پروتکل WebMCP را ارائه می دهد، اما این کار را فقط از طریق API آزمایشیِ navigator.modelContext انجام می دهد و هیچ انوتیشن فرمِ اعلانی (declarative) ندارد.
اسکن در یک مرورگر کروم نسخه ۱۵۰ بدون رابط کاربری (headless) اجرا شد که هیچ فلگ WebMCP در آن فعال نبود؛ بنابراین، این نتیجه می تواند به این معنا باشد که وب سایت چیزی را که این حسابرسی ها قادر به تشخیص آن باشند ارائه نداده است، یا اینکه محیط اسکن در زمان اجرا هیچ API فعالی برای WebMCP نداشته است. لایت هاوس دقیقاً مشخص نمی کند کدام حالت رخ داده است.
دو حسابرسی به صورت کامل تایید شدند:
مورد agent-accessibility-tree پیام “All audits passed” را گزارش داد که تایید می کند ساختار HTML معنایی (Semantic) و کدهای ARIA به اندازه کافی برای ناوبری ایجنت های هوش مصنوعی ساختاریافته و مناسب هستند. فاکتور تغییرات چیدمان تجمعی (CLS) نیز روی عدد صفر ایستاد.
اما یک حسابرسی رد شد: llms-txt. پیام خطای دقیق لایت هاوس این بود:
«به نظر می رسد فایل حاوی هیچ لینکی نیست.»
امتیاز این دسته بندی ۰.۶۷ شد. این اولین غافلگیری بود. فایل موجود در آدرس nohacks.co/llms.txt لینک های بسیار زیادی دارد: مسیرهای ناوبری به مقالات، قسمت های پادکست، مهمانان و واژه نامه، در کنار URLهای فید RSS و الگوهای آدرس فایل های صوتی. این فایل بیش از ۵ کیلوبایت محتوای ساختاریافته در خود دارد. پس چرا لایت هاوس گزارش می داد که صفر لینک در آن وجود دارد؟
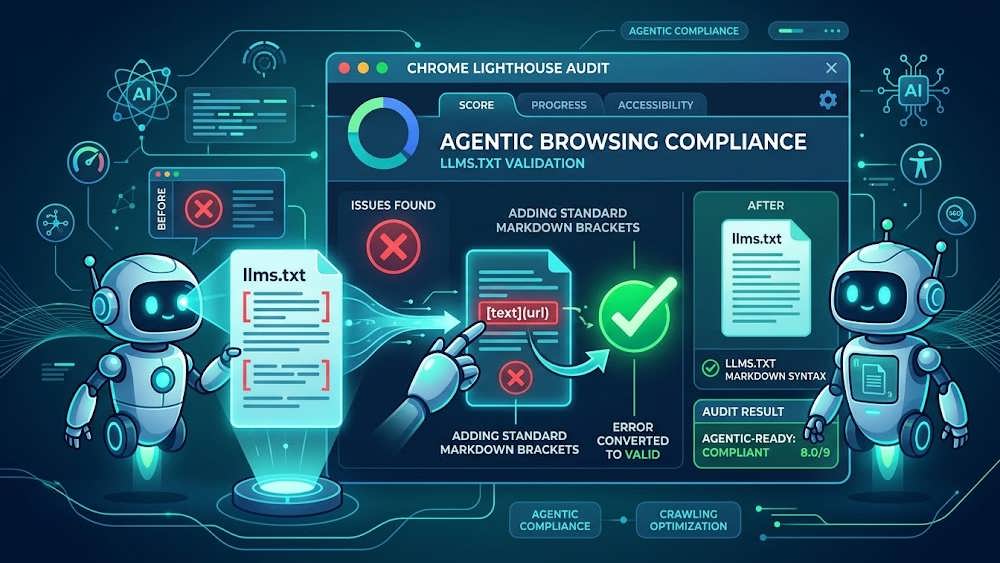
نحوه مواجهه پارسر لایت هاوس با فایل های llms.txt را نشان می دهد؛ جایی که عدم استفاده از نشانه گذاری مارک داون باعث بروز خطا شده و اضافه کردن ۵ کاراکتر به ازای هر لینک، آن را به یک تایید سبز تبدیل می کند.
لایت هاوس فایل های txt را به عنوان مارک داون می خواند و لینک های متنی ساده را رد می کند
پسوند این فایل .txt است، اما لایت هاوس محتویات آن را مانند زبان نشانه گذاری مارک داون (markdown) تجزیه وتحلیل یا اصطلاحاً پارس (Parse) می کند. این ابزار اصرار دارد که برای شناخته شدن هر متن به عنوان یک لینک، باید حتماً از سینتکس لینک دهی مارک داون استفاده شود.
نام فایل llms.txt است. سرور HTTP آن را با نوع داده (MIME type) متنی یعنی text/plain برمی گرداند. اگر آن را در یک مرورگر باز کنید، یک متن کاملاً ساده و بدون فرمت می بینید. اما مشخصات رسمی فایل های llms.txt در سایت llmstxt.org، این فرمت را به عنوان یک «سند مارک داون» تعریف کرده است. این مستندات صریحاً می گوید: «هر بخش شامل یک لیست بولت دار مارک داون از لینک هاست. هر آیتمِ لیست دارای یک لینک است که با یادداشت های اختیاری درباره آن دنبال می شود و این یادداشت ها با یک علامت دو نقطه (:) از لینک جدا می شوند.»
پارسر لایت هاوس این قانون را با سخت گیری تمام اجرا می کند. هر لینک باید دقیقاً با سینتکس مارک داون یعنی فرمت [text](url) کدگذاری شود؛ به طوری که قلاب ها (کروشه ها) متن لینک را در بر بگیرند و پرانتزها آدرس URL را.
فایل من از یک فرمت متنی ساده و طبیعی تر استفاده می کرد:
Homepage: / - Publication masthead, cornerstone series, latest articles and episodesArticles: /blog - All articles on AXO, the agentic web, and AI agentsEpisode: /episode/[slug] - Full show notes, transcript, audio player
مقصدها همان بود. توضیحات همان بود. اطلاعات نیز دقیقاً همان بود. اما پارسر لایت هاوس این خطوط را به عنوان لینک شناسایی نمی کرد. در سرتاسر فایل، تعداد لینک های ثبت شده توسط لایت هاوس دقیقاً صفر بود. در نتیجه حسابرسی مردود شد.
ما با فایلی روبرو هستیم که پسوند .txt دارد، با MIME type نوع text/plain سرو می شود، اما اگر با فرمت مارک داون نوشته نشود، در بررسی های سئو رد می شود! این یک تناقض است که لایه حسابرسی در آینده باید درباره آن صادقانه تر عمل کند. پسوند فایل یک چیز می گوید، نوع محتوا چیز دیگری می گوید، اما پارسر به عنوان مرجع نهایی حقیقت، مارک داون طلب می کند! در پروژه های دیجیتال مارکتینگ دانش وب، ما همواره تاکید داریم که برای جلوگیری از این خطاهای پنهان، باید از قبل با استانداردهای ماشین ها و خزنده های جدید آشنا بود.
راه حل تنها ۵ کاراکتر به ازای هر لینک است
کافیست هدف هر لینک را در سینتکس براکت-پرانتز مارک داون یعنی [text](url) قرار دهید و جداکننده خط تیره (-) قبل از هر توضیح را با دونقطه (:) جایگزین کنید. این یعنی فقط ۵ کاراکتر برای هر لینک. یک تبدیل مکانیکی و ساده که در سراسر فایل تکرار شد.
[Homepage](/): Publication masthead, cornerstone series, latest articles and episodes[Articles](/blog): All articles on AXO, the agentic web, and AI agents[Episode](/episode/[slug]): Full show notes, transcript, audio player
من این ویرایش را انجام دادم و حسابرسی را دوباره اجرا کردم. امتیاز از ۰.۶۷ به ۱.۰ (کامل) رسید. عنوان حسابرسی از «فایل llms.txt از توصیه ها پیروی نمی کند» به «فایل llms.txt از توصیه ها پیروی می کند» تغییر یافت. دیگر هیچ جزئیات خطایی در گزارش وجود نداشت و یک تایید کاملاً سبز و تمیز به دست آمد.
این فایل هنوز هم به عنوان متن ساده (text/plain) سرو می شود. پسوند آن هنوز .txt است. محتوای آن نیز دقیقاً همان محتوای قبلی است. فقط کدگذاری لینک ها تغییر کرده است.
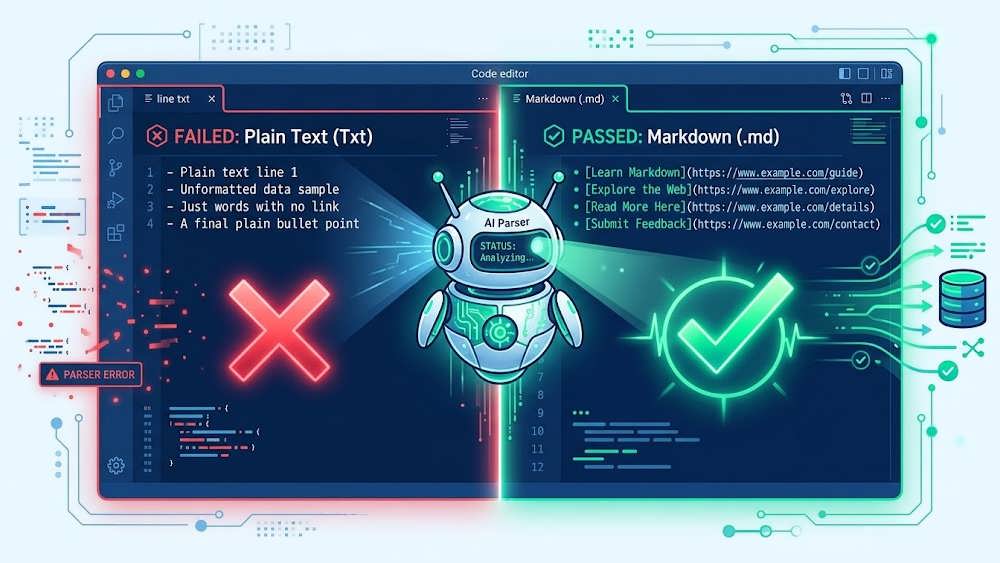
تفاوت کدنویسی قابل پردازش توسط ایجنت های هوش مصنوعی را نشان می دهد؛ لینک های متن ساده علی رغم صحیح بودن آدرس، توسط پارسر رد می شوند اما با قرارگیری در قالب براکت-پرانتز [text](url) تایید می شوند.
لایت هاوس سینتکس قابل تجزیه لینک را می سنجد، نه کیفیت فایل را
این حسابرسی تنها بررسی می کند که آیا فایل شما از نظر مکانیکی قابل خواندن (Parseable) هست یا خیر. این ابزار بررسی نمی کند که آیا فایل واقعاً اطلاعات مفید و درستی از وب سایت شما ارائه می دهد یا نه. هر دو برداشت به طور همزمان درست هستند:
برداشت اول: این حسابرسی در حال سنجش یک چیز واقعی است. سینتکس لینک مارک داون به صورت ماشینی قابل پردازش است، اما خطوط توضیحی متن ساده این طور نیستند. اگر یک ایجنت هوش مصنوعی (یا پارسر لایت هاوس که به نمایندگی از آن ایجنت عمل می کند) بخواهد به صورت برنامه نویسی شده لینک ها را از فایل استخراج کند، به فرمت مارک داون نیاز دارد. حق با لایت هاوس است؛ فایل من قبل از اصلاح، توسط ابزارهای استاندارد برای استخراج لینک قابل خواندن نبود. تغییر به سینتکس مارک داون یک شکاف واقعی در بحث تعامل پذیری (Interoperability) ماشین ها را رفع می کند.
برداشت دوم: رعایت فرمت به معنای بالا بودن کیفیت فایل نیست. یک فایل llms.txt دقیق، جامع و با تفکر نوشته شده که از توضیحات متنی ساده استفاده می کند، در این حسابرسی مردود می شود. در مقابل، یک فایل سطحی و بی ارزش که به صورت خودکار با فرمت مارک داون تولید شده باشد، به راحتی نمره قبولی می گیرد. لایت هاوس نمی تواند تفاوت این دو را تشخیص دهد.
برای مثال، افزونه وردپرسی AIOSEO (که طبق صفحه آن در مخزن وردپرس روی بیش از ۳ میلیون سایت نصب است)، به طور پیش فرض فایل های llms.txt را با سینتکس مارک داون تولید می کند. این رفتار پیش فرض توسط متخصصانی چون «گلن گیب» مطرح شد و مستندات خود این افزونه نیز آن را تایید می کند. این فایل های تولید شده خودکار به این دلیل مارک داون هستند که ژنراتورِ تولیدکننده این طور برنامه ریزی شده است. احتمالاً بیشتر آن ها در حسابرسی لایت هاوس نمره قبولی می گیرند، در حالی که اکثر فایل های llms.txt که با دقت و توسط دست صاحبان سایت ها ایجاد شده اند، در این تست رد می شوند!
این شکاف چیزی است که باید پیش از آنکه نمره قبولی/ردی لایت هاوس را به عنوان «میزان آمادگی واقعی سایت برای هوش مصنوعی» در نظر بگیریم، درباره اش فکر کنیم. این تست فقط چک می کند که فایل شما قابل پردازش هست یا خیر؛ مفید بودن آن برایش اهمیتی ندارد.
آیا باید به چک لیست Llms.txt در لایت هاوس اهمیت بدهید؟
بله، اما با نگاهی محدود. لایت هاوس می تواند به شما بگوید که آیا llms.txt سایت شما به عنوان مارک داون قابل پردازش هست یا خیر؛ اما نمی تواند بگوید که آیا این فایل واقعاً سایت شما را به درستی و صادقانه توصیف می کند یا نه. این بررسی بر عهده خود شماست.
اگر می خواهید این تست را انجام دهید، ابزار Chrome DevTools را باز کنید، به تب Lighthouse بروید، تیک دسته بندی Agentic Browsing را بزنید و روی URL خود کلیک کنید تا آنالیز آغاز شود. این کار کمتر از یک دقیقه طول می کشد. اگر سایت شما ارور «فایل حاوی لینک نیست» را داد، راه حل آن فقط صرف ۵ دقیقه وقت و اضافه کردن ۵ کاراکتر به ازای هر لینک است. اما اگر فایل شما تایید شد، سوال سخت تر اینجاست که آیا این فایل توسط افزونه ای ساخته شده که شما هیچ تنظیمی روی آن انجام نداده اید، یا خودتان آن را با آگاهی کامل نوشته اید؟ در هر صورت، آیا این فایل واقعیت کسب وکار و محتوای وب سایت شما را به هوش مصنوعی می فهماند؟
ستون اصلی «معماری ماشین محور» (Machine-First Architecture) بر پایه ی این اصول بنا شده است: مدل های داده پیش از چیدمان های بصری صفحات، استقلال رندرینگ سایت، و محتوایی که برای خوانده شدن توسط ماشین نیازی به جاوا اسکریپت سمت کاربر یا پیش فرض های نمایش انسانی نداشته باشد. بررسی llms.txt تنها یک چک لیست کوچک در این لایه است. سوال ساختاری بزرگتر این است که آیا بسترِ ماشین خوانِ سایت شما، به درستی محتوایتان را توصیف می کند یا خیر؛ پاسخی که کشف آن بر عهده خود شماست.