

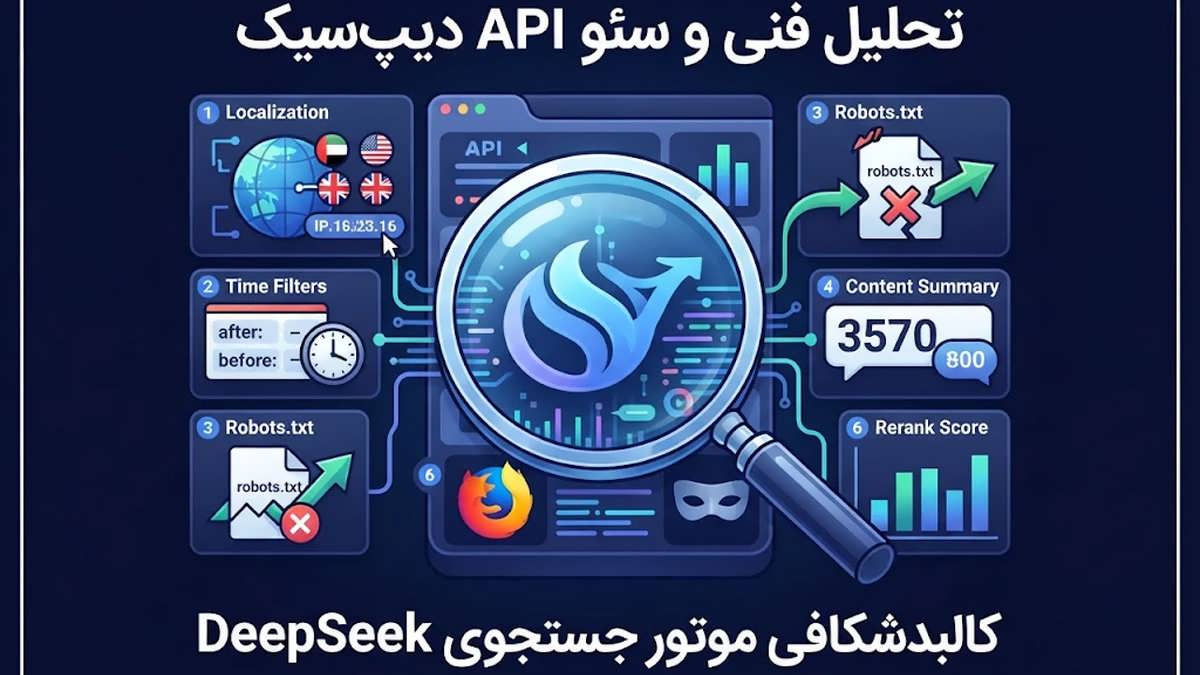
دیپ سیک (DeepSeek) اخیراً API جستجوی اختصاصی خود را همراه با سیستم امتیازدهی اعتبار (Authority Scores) و وعده فیلتر کردن اسپم های سئو (SEO) و دستکاری های مرتبط با موتورهای جستجوی تولیدی (GEO) در دسترس عموم قرار داده است. من تنها با صرف ۰.۰۸ دلار، نتایج واقعی این ابزار را تست کردم تا ببینم دقیقاً چه خروجی هایی به ما می دهد.
دیپ سیک از طریق یک API عمومی جستجو و واکشی (Search and Fetch API)، دسترسی به موتور جستجوی خود را باز کرده است. این سیستم برای هر نتیجه جستجو، یک «امتیاز اعتبار» ارائه می دهد و ادعا می کند که هرزنامه های سئو، دستکاری های هوش مصنوعی (GEO) و محتواهای بی کیفیت را به دقت فیلتر می کند. (منظور از GEO یا Generative Engine Optimization، بهینه سازی محتوا برای موتورهای جستجوی مبتنی بر هوش مصنوعی است).
این یک اتفاق و به روزرسانی بسیار مهم برای متخصصان سئو و وبمسترها محسوب می شود. (در تیم تخصصی دانش وب نیز ما همواره چنین تغییراتی را به دقت رصد می کنیم تا استراتژی های سئو و طراحی سایت مشتریانمان را با آخرین الگوریتم های روز همگام نگه داریم).
معرفی این API در تاریخ ۱۷ اکتبر ۲۰۲۶ همزمان با به روزرسانی مدل Flash این شرکت انجام شد. دیپ سیک می گوید موتور جستجوی آن ها در حال حاضر جستجوهای وب سایت اختصاصی خودشان و API آن را تامین می کند، صدها میلیارد صفحه را ایندکس کرده و روزانه صدها میلیون جستجو را مدیریت می نماید.
اکنون ما می توانیم مستقیماً از این سیستم کوئری (پرس وجو) بگیریم، منابعی که برمی گرداند را بررسی کنیم و بخشی از امتیازهای اختصاص یافته به آن ها را ببینیم. این قابلیت به ما داده های ملموسی می دهد تا قبل از اینکه یک مدل هوش مصنوعی این منابع را به پاسخ نهایی تبدیل کند، آن ها را به دقت تحلیل کنیم.
طبیعتاً، من هم می خواستم بدانم نظر این موتور جستجو درباره وب سایت خودم چیست و آیا سیستم فیلترینگ اسپم آن واقعاً همان طور که ادعا می کند قدرتمند است یا خیر. بنابراین با هزینه کردن ۰.۰۸ دلار این موضوع را بررسی کردم.
نتیجه جالب بود؛ سایت من امتیاز اعتبار (Authority) ۱ را دریافت کرد. در حالی که فایل های PDF اسپم که روی هاست های دولتی و دانشگاهی قرار داشتند، بالاترین امتیاز اعتبار یعنی ۴ را گرفتند! علاوه بر این، ابزار Fetch API این سیستم، خود را به عنوان مرورگر فایرفاکس از کشور هنگ کنگ معرفی کرد و جالب تر اینکه محتواهایی را از URLهایی برگرداند که توسط فایل robots.txt به طور کامل مسدود شده بودند.
این موارد یافته های اولیه من هستند که در ادامه به تفصیل آن ها را بررسی می کنیم.
مواردی که من تست کردم
من در ۱۷ اکتبر ۲۰۲۶، از شهر دبی ۱۱۰ درخواست (Call) اجرا کردم: ۹۳ درخواست جستجو (Search) و ۱۷ درخواست واکشی (Fetch). بر اساس قوانین قیمت گذاری دیپ سیک، حدود ۱۰۳ مورد از این درخواست ها شامل هزینه می شدند که در مجموع چیزی حدود ۰.۰۸ دلار هزینه در برداشت.
این آزمایش ها شامل بررسی توزیع امتیازها، سنجش میزان اعتبار (Authority) در هاست های مختلف، ۶ کوئری مرتبط با ابزارها و تحقیقات خودم، بررسی لوکالیزیشن (بومی سازی جغرافیایی)، فیلترهای زمانی و در نهایت رفتار واکشی (Fetch Behavior) بود. من از مستندات رسمی Search و Fetch به عنوان مرجع اصلی استفاده کردم و هر جا که پاسخ های دریافتی با مستندات رسمی تفاوت داشت، نتایج مشاهده شده را به صورت کاملاً شفاف بیان کرده ام.
دیپ سیک به شما ۲ امتیاز (Score) می دهد
هر نتیجه جستجو در دیپ سیک شامل دو فیلد مهم است که حتماً باید به آن ها توجه داشته باشیم:
| فیلد | معنای آن از زبان دیپ سیک |
|---|---|
| authority (اعتبار) | یک سطح اعتبار از ۰ تا ۴ (عدد ۱- به معنای ناشناخته است). مقادیر ۳ یا بالاتر نشان دهنده منابع بسیار معتبر و مستند هستند. |
| rerank_score (امتیاز رتبه بندی مجدد) | امتیازی از ۰ تا ۳ که ترکیبی از سیگنال هایی مانند میزان ارتباط (Relevance)، اعتبار (Authority) و تازگی محتوا (Freshness) است. امتیاز ۱.۵ یا بالاتر به عنوان محتوای باکیفیت در نظر گرفته می شود. |
این تعاریف مستقیماً از مرجع مستندات API جستجو استخراج شده اند. سطح اعتبار (Authority Tier) ارزیابی اختصاصی خود دیپ سیک است و مستندات، آن را به عنوان یک ویژگی مختصِ همان «صفحه» توصیف می کند.
با اجرای ۲۰ کوئری مرتبط با SEO و GEO و تنظیم تعداد نتایج روی ۵۰ (count=50)، موفق به جمع آوری ۱۰۰۰ نتیجه شدم. امتیازهای rerank_score آن ها بین ۰.۷۵ تا ۲.۷۰ متغیر بود و میانه (Median) این امتیازها روی ۱.۶۳ قرار داشت. نتایج به طور مداوم بر اساس همین امتیاز مرتب می شدند و ۶۸ درصد از نتایج، امتیازی مساوی یا بالاتر از ۱.۵ داشتند.
در میان این ۱۰۰۰ نتیجه، تنها ۱۹۶ امتیاز مجزا مشاهده شد. به نظر می رسید مقادیر بازگشتی در دسته های مشخصی (Bucketed) گروه بندی شده اند، هرچند که این موضوع به تنهایی مشخص نمی کند که آیا امتیازهای پایه رُند شده اند یا الگوریتم آن ها را در گام های ثابت محاسبه می کند. (در دیجیتال مارکتینگ و سئو، درک این نحوه گروه بندی امتیازات کمک می کند تا بفهمیم موتورهای جستجو چطور سایت ها را در دسته های کیفی مختلف دسته بندی می کنند).
به نظر می رسید معیار Authority به هاست (دامنه اصلی) گره خورده است. امتیاز من ۱ بود!
در میان تمام ۴,۳۲۲ نتیجه ای که در این تست اجرا شد، سطوح اعتبار ۱- و ۰ هرگز ظاهر نشدند. توزیع این نتایج به شکل زیر بود:
| اعتبار (Authority) | سهم نتایج | میانه امتیاز rerank |
|---|---|---|
| ۱ | ۲٪ | ۰.۹۵ |
| ۲ | ۳۲٪ | ۱.۴۵ |
| ۳ | ۶۰٪ | ۱.۸۳ |
| ۴ | ۶٪ | ۱.۹۸ |
در این نمونه آماری کاملاً مشخص بود که هرچه سطح اعتبار (Authority) بالاتر است، میانه امتیاز rerank_score نیز افزایش می یابد. البته این موضوع اثرِ مستقیم اعتبار را از سایر سیگنال های رتبه بندی مجزا نمی کند، اما نشان می دهد که بررسیِ عمیق ترِ این فیلد کاملاً ارزشمند است.
سپس برای بررسی دقیق تر، با استفاده از اپراتور site: تعداد ۱۶ بررسی روی ۱۶ هاست (Host) مختلف انجام دادم. نکته بسیار عجیب این بود که در هر هاست، تک تک URLهای بازگردانده شده دقیقاً همان امتیاز اعتبار مشابه را داشتند. در اینجا چند نمونه را می بینید:
| هاست (Host) | اعتبار (Authority) |
|---|---|
| suganthan.com | ۱ |
| growth-memo.com | ۱ |
| ipullrank.com, brodieclark.com, medium.com, reddit.com | ۲ |
| ahrefs.com, moz.com, searchengineland.com, aleydasolis.com, linkedin.com | ۳ |
| zenodo.org | ۴ |
بنابراین، با وجود اینکه مستندات رسمی این فیلد را به عنوان یک «سطح اعتبار صفحه» معرفی می کند، اما در آزمایشات من کاملاً رفتاری شبیه به «امتیاز هاست (دامنه)» از خود نشان داد. ساب دامین های سایت Reddit در اینجا راهنمای بسیار خوبی بودند: ساب دامین qh.reddit.com امتیاز ۱ گرفت، در حالی که آدرس اصلی www.reddit.com امتیاز ۲ را دریافت کرد. این موضوع نشان می دهد که به جای اینکه کل دامنه ثبت شده یک امتیاز واحد را به اشتراک بگذارند، واحدِ اثرگذار در واقع خود Host (و ساب دامین مجزا) است.
جستجوی site:suganthan.com سقف ۵۰ نتیجه را پر کرد. این جستجو، صفحه اصلی، صفحات دسته بندی (/resources/)، یادداشت ها و مقالات وبلاگ مرا بازگرداند. دیپ سیک به خوبی محتواهای سراسر سایت من را پیدا می کرد، اما نکته اینجا بود که تمامی آن صفحات امتیاز اعتبار ۱ را با خود یدک می کشیدند.
کاملاً مشخص بود که صرفاً «ایندکس شدن» در دیتابیس هوش مصنوعی، تنها بخشی از داستان است و اعتبار کلی دامنه حرف اول را می زند.
در کوئری های مربوط به ابزارهای خودم، رقابت را به مارکت پلیس ها و اپ استورها باختم!
من ۶ کوئری هدفمند را با تنظیم count=50 از موقعیت امارات متحده عربی (UAE) اجرا کردم:
| کوئری جستجو شده | بهترین نتیجه سایت من | چه کسی در صدر نتایج ظاهر شد؟ |
|---|---|---|
| کشف اینکه Gemini برای کوئری شما به چه کسی استناد می کند | رتبه ۴۸ (برای مقاله مرتبط خودم)، امتیاز ریرنک: ۱.۱۴ | افزونه های Apify، فروشگاه کروم (Chrome Web Store) |
| افزونه کروم ChatGPT fan-out | رتبه ۳۲ (برای ابزار FanoutFox)، امتیاز ریرنک: ۱.۳۷. (در لوکالیزیشن آمریکا و انگلیس خارج از ۵۰ نتیجه برتر). | کروم وب استور (۳ بار)، Writesonic, Resoneo |
| ردیابی ترافیک Google AI Mode در سرچ کنسول | خارج از ۵۰ نتیجه برتر | support.google.com, developers.google.cn, SEJ, Bounteous |
| بررسی دسترسی خزنده های هوش مصنوعی | خارج از ۵۰ نتیجه برتر | افزونه های wordpress.org, PyPI, Apify |
| پکیج MCP سرچ کنسول گوگل | خارج از ۵۰ نتیجه برتر | PyPI (۳ بار), n8n, mcpworld |
| ایجنت های هوش مصنوعی x402 با پرداخت به ازای خزش | خارج از ۵۰ نتیجه برتر | Akamai, npm, pkg.go.dev |
همان طور که می بینید، مخازن پکیج ها (Package registries)، فروشگاه های اپلیکیشن، و لیست های مارکت پلیس ها در این کوئری های ابزارمحور عملکرد درخشانی داشتند. هاست هایی مانند PyPI، npm، Apify، فروشگاه افزونه های کروم، سایت وردپرس و GitHub پلتفرم هایی بودند که در صدر نتایج می درخشیدند.
مقاله مرتبط با جمینای (Gemini) و ابزار FanoutFox من هر دو دارای امتیاز اعتبار ۱ بودند. امتیازهای rerank آن ها (به ترتیب ۱.۱۴ و ۱.۳۷) نیز پایین تر از آستانه ۱.۵ بود که دیپ سیک آن را برای «محتوای باکیفیت» تعیین کرده است.
این یعنی برای وب سایت شخصی من، داشتن محتوایی که دقیقاً و مستقیماً درباره موضوع جستجو شده صحبت می کرد، برای شکست دادن آن هاست های قدرتمند کافی نبود. اختصاص یافتنِ سطح اعتبارِ پایین توضیح کاملاً قانع کننده ای برای این موضوع است، هرچند این آزمایش ها وزنِ دقیق الگوریتمی این امتیازها را مشخص نمی کنند.
سیستم فیلترینگ اسپم همچنان اجازه عبور به محتواهای مشکوک را می دهد
دیپ سیک صراحتاً ادعا می کند که موتور جستجوی آن، هرزنامه های سئو، دستکاری های مرتبط با موتورهای تولیدی (GEO)، و محتوای بی کیفیت هوش مصنوعی را فیلتر می کند. من می خواستم ببینم این ادعا در دنیای واقعی چقدر صادق است. مواردی که همچنان در نتایج ظاهر شدند را در زیر می بینید:
| هاست (Host) | محتوای پیدا شده | امتیازها و رتبه ها |
|---|---|---|
oig.dc.gov |
فایل های PDF فرم وب با عنوان «تولیدکننده رایگان Robux در سال ۲۰۲۵» روی یک هاست مربوط به بازرس کل دولت آمریکا | اعتبار ۴، امتیاز ریرنک ۱.۴۲ |
business.columbia.edu |
فایل های آپلودی با عنوان «بهترین پاستیل های CBD لو رفته…» در سایت یک دانشگاه | اعتبار ۴، امتیاز ریرنک ۱.۵۰ |
damiangreen.co.uk |
دامنه یک نماینده سابق پارلمان انگلیس که در حال ارائه «کازینوهای با حداقل سپرده انگلیس» بود | اعتبار ۳، رتبه دوم در کوئری “best casino sites uk” |
من همچنین دیدم که «چارچوب های» منتشر شده توسط کاربران عادی در سایت zenodo.org بالاترین اعتبار یعنی ۴ را دریافت کرده و در عبارت کلیدی “generative engine optimization” رتبه های اول و سوم را کسب کرده اند! این مشاهده مهمی درباره نحوه عملکرد معیار Authority است: انتشار محتوا توسط خودِ کاربر در یک سایت معتبر به تنهایی باعث نمی شود که دیپ سیک آن صفحه را اسپم تلقی کند.
توجیه مثال های مربوط به سایت های دولتی و دانشگاهی با ادعای فیلتر کردن اسپم، تقریباً غیرممکن است. آن فایل های آپلودیِ کاملاً بی ربط همچنان بالاترین سطح اعتبار (۴) را دریافت کردند. این دقیقاً همان نقطه ای است که وابستگی دیپ سیک به «امتیاز هاست (Host Score)» خودش را نشان می دهد. سیستمی که اعتبار یک دامنه بزرگ را به تمام صفحات زیرمجموعه اش تعمیم می دهد، در نهایت باعث می شود که محتواهای طفیلی (Parasite SEO) در کنار محتوای مشروع و معتبرِ همان هاست، رتبه های بالایی را غصب کنند.
این نتایج به ما نمی گویند که دیپ سیک دقیقاً چقدر از اسپم ها را حذف کرده است، اما نشان می دهند که این نمونه های واضح توانسته اند از سد فیلترها عبور کنند و یک سطح اعتبار بالا، الزاماً تضمین کننده کیفیت واقعی یک صفحه مجزا نیست.
چگونه دقیقاً همین نوع جستجو را خودمان اجرا کنیم؟
در اینجا نمونه کدی از یک درخواست با استفاده از کلید API (که در یک متغیر محیطی ذخیره شده) آورده شده است:
bash
curl -s https://api.deepseek.com/v1/tools/search \
 -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
 -H "Content-Type: application/json" \
 -d '{"query":"find out who Gemini cites for your query","count":50}'
نمونه ای از یک نتیجه خلاصه شده برای این کوئری:
json
{
 "url": "https://suganthan.com/blog/gemini-citations/",
 "rerank_score": 1.14,
 "authority": 1
}
هزینه جستجو (Search) و واکشی (Fetch) هر کدام معادل ۰.۷۵ دلار به ازای هر ۱۰۰۰ درخواست موفق است. طبق قوانین سیستم صورتحساب دیپ سیک، درخواست های ناموفق، نتایج جستجوی خالی و تایم اوت ها شامل هزینه نمی شوند. همچنین هزینه دریافت ۵۰ نتیجه کامل دقیقاً با هزینه دریافت نتایج کمتر برابر است.
یک معافیت موقت برای فراخوانی های سمتِ سرور Search و Fetch که از طریق ابزارهای Claude Code یا Codex انجام می شوند وجود دارد که تا تاریخ ۱ نوامبر ۲۰۲۶ کاملاً رایگان هستند. تست های API مستقیم من همگی شامل هزینه شدند.
۳ نکته کلیدی که هنگام تست کردن باید در نظر بگیرید
۱. بومی سازی (Localization) خود را به دقت تنظیم کنید:
عدم تنظیم لوکالیزیشن، نتایجی دقیقاً مشابه با زمانی که یک IP امارات (UAE) را روی ۶ کوئری هدفم تنظیم کرده بودم تولید کرد. از آنجا که من از دبی درخواست می فرستادم، مشخص شد که دیپ سیک به صورت پیش فرض از IPِ شخص درخواست دهنده (Caller) استفاده می کند.
شما باید این فیلد را صریحاً روی IP بازاری که می خواهید تست کنید قرار دهید. در غیر این صورت، گزارش سئوی شما ممکن است وضعیت کشوری را نشان دهد که سرور یا اسکریپتتان در آنجا قرار دارد. استفاده از آی پی آمریکا یا انگلیس باعث شد امتیازهای rerank بین ۲۶ تا ۴۱ مورد از ۵۰ نتیجه دستخوش تغییر شده و ۴ تا ۱۵ آدرس URL جابه جا شوند. (تغییر میانگین امتیاز کم بود و این کار بیشتر باعث جابجایی جایگاه نتایج شد).
۲. پرسش اصلی (Original Question) تفاوت بسیار کمی ایجاد کرد:
فیلد ori_question به شما اجازه می دهد تا پرسش اولیه و محاوره ای کاربر را در کنار کوئری اصلی جستجو ارسال کنید تا به درک بهتر موتور جستجو کمک کند. با این حال در سراسر ۶ کوئری من، این فیلد امتیاز رتبه بندی مجدد را تنها برای صفر تا دو نتیجه تغییر داد.
۳. فیلترهای تاریخ، تمام نتایجِ بدون تاریخ را نابود کردند!
اپراتورهای after: و before: در طول ۴ کوئری، تک تک صفحاتی که تاریخ مشخصی نداشتند را از نتایج حذف کردند. ۱۱ درصد از نتایج در حالت عادی فاقد تاریخ (date: null) بودند که پس از اعمال این فیلتر به کلی ناپدید شدند.
این موضوع برای سایت شما حیاتی است؛ اگر محتوای شما باید در جستجوهای پیرامون «اطلاعات اخیر» نمایش داده شود، حتماً از درج تاریخ های قابل فهم برای ماشین (مانند استفاده از Schema Markup) در کدهای صفحه مطمئن شوید.
علاوه بر این، متوجه شدم طول محتوا در فیلد خلاصه (summary) در عمل حدود ۳۵۷۰ کاراکتر است، در حالی که در مستندات رسمی تنها ۶۰۰ تا ۸۰۰ کاراکتر اعلام شده بود! اگر برنامه نویس هستید و قصد ساخت ابزاری بر بستر این API را دارید، این تفاوت در طول متن را حتما لحاظ کنید.
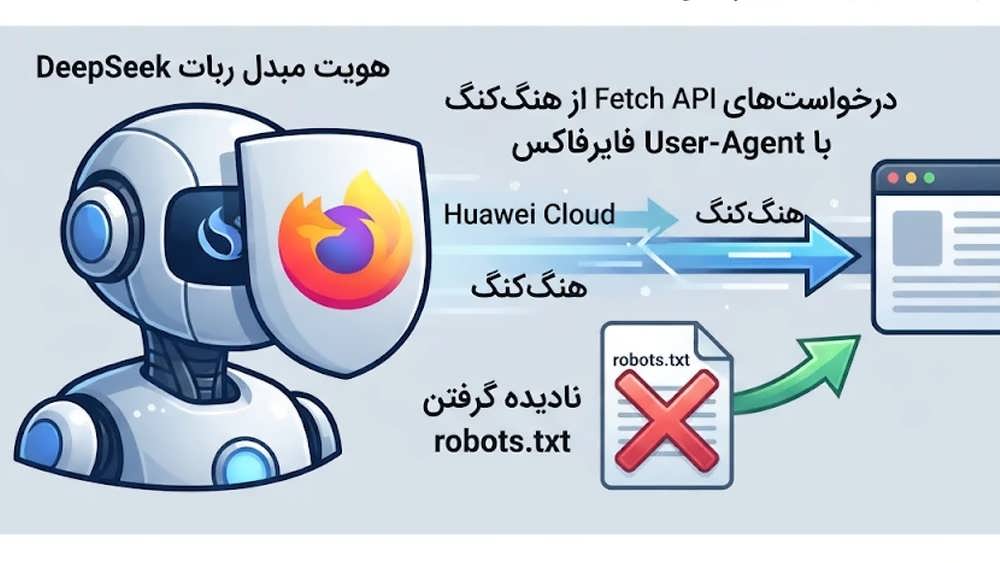
: تصویری گرافیکی از لاگ های سرور که نشان می دهد درخواست های API دیپ سیک با استفاده از User-Agent فایرفاکس و از طریق آی پی های هنگ کنگ (شبکه ابری هواوی) ارسال شده اند.
ابزار Fetch API با چهره مرورگر فایرفاکس از هنگ کنگ وارد عمل شد
درخواست های واکشی (Fetch) که من بررسی کردم، هویت خود را به عنوان دیپ سیک فاش نکردند. آن ها از این یوزر ایجنت (User Agent) استفاده کردند:
Mozilla/5.0 (X11; Linux x86_64; rv:149.0) Gecko/20100101 Firefox/149.0
هدر زبان (Accept-Language) نیز zh-CN,zh;q=0.9 تنظیم شده بود.
هیچ اثری از توکن ربات یا امضای اختصاصی دیپ سیک نبود. این درخواست ها کاملاً خود را جای مرورگر فایرفاکس جا زدند و از ۵ آی پی مختلف متعلق به شبکه ابری هواوی (Huawei Cloud) در هنگ کنگ (با شماره شبکه AS136907) ارسال شدند.
در زمان بررسی نحوه رندر صفحه، این ابزار کدهای CSS را بارگذاری کرد، اما کدهای جاوا اسکریپت (JavaScript) و تصاویر را اجرا نکرد. در نتیجه، محتواهایی از سایت که برای نمایش به اجرای جاوا اسکریپت وابسته بودند، اصلاً توسط دیپ سیک دیده نشدند.
دور زدن قوانین فایل Robots.txt !
موضوع نگران کننده دیگر این بود که Fetch API محتوای کامل را از سه URL معروفی که برای تمامی ربات ها (User-agent: *) مسدود شده بودند، با موفقیت برگرداند! (از جمله مسیر httpbin.org/deny و صفحات جستجوی داخلی گوگل و ویکی پدیا). من نتوانستم تایید کنم که آیا ربات اصلاً به فایل robots.txt سر زده است یا نه؛ اما چیزی که قطعی بود این بود که دستورات منع دسترسی، نتوانستند مانع استخراج محتوا توسط API دیپ سیک شوند.
در فایل های لاگ (Logs) سایت خود به دنبال چه چیزی باشیم؟
اگر فایل های Log سرور شما هدر Accept-Language را ذخیره می کنند، جستجوی این خط کد می تواند به شما در پیدا کردن ربات های دیپ سیک کمک کند:
grep -E 'Firefox/149.0' access.log | grep 'zh-CN'
همچنین اگر از کلودفلر (Cloudflare) استفاده می کنید، قانون کاستوم زیر می تواند آن ها را شناسایی کند:
(ip.src.asnum eq 136907 and http.user_agent contains "Firefox/149.0" and any(http.request.headers["accept-language"][*] contains "zh-CN"))
توجه مهم: این ترکیب صرفاً یک “ردپا” بر اساس مشاهدات فعلی است و ممکن است در آینده تغییر کند. از آنجا که یوزر-ایجنت رسمی دیپ سیک وجود ندارد، مسدود کردن کلمه Firefox یا شبکه ابری هواوی می تواند منجر به مسدود شدن کاربران واقعی سایت شما شود، پس در این باره محتاط باشید.
به عنوان یک متخصص سئو یا دیجیتال مارکتر، چه درسی از این داده ها بگیریم؟
مهم ترین مزیت عمومی شدن این API این است که حالا ما می توانیم به صورت مستقیم، تفکر و امتیازدهی یک هوش مصنوعی را ارزیابی کنیم. کارهایی که به عنوان یک سئوکار باید انجام دهید:
- کوئری های کلیدی کسب وکار خود را در API دیپ سیک جستجو کنید. جایگاه رقبا، امتیاز rerank و میزان Authority دامنه خود و رقبا را مقایسه کنید.
- با دستور
site:yourdomain.com، میزان اعتبار (Authority Tier) سایت خود را در دیپ سیک بسنجید. - در زمان استفاده از ابزار، منطقه مکانی و آی پی کاربران هدف خود را صریحاً در API وارد کنید.
- تاریخ مقالات خود را بررسی کنید! حتماً با استفاده از کدهای اسکیما (Schema) و استراکچرد دیتا، تاریخ انتشار و به روزرسانی محتوا را در سایت قرار دهید تا از نتایج زمانی دیپ سیک حذف نشوید.
- استراتژی توزیع محتوا را جدی بگیرید. همان طور که دیدیم پلتفرم هایی مثل وردپرس، گیت هاب و مارکت پلیس ها رتبه های بهتری از سایت های شخصی می گرفتند.
- لاگ های سرور خود را با احتیاط بررسی کنید.
برای من، هیجان انگیزترین بخش این پژوهش، مشاهده ضعف الگوریتم در تشخیص اسپم های واضحی بود که صرفاً به دلیل قرارگیری در یک هاست معتبر، بالاترین رتبه ها را از آن خود کردند! این مسئله سوالات جدیدی را برای استراتژیست های محتوا ایجاد می کند.