

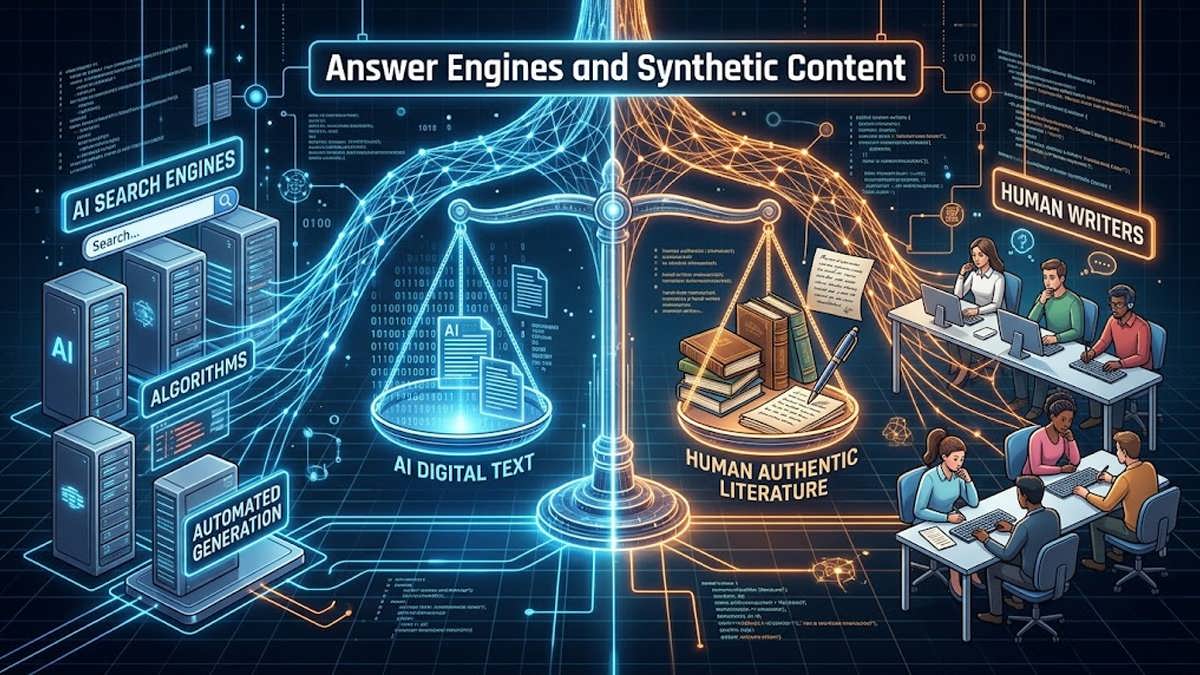
موتورهای پاسخ دهنده (Answer Engines) دقیقاً به خاطر تولید همان محتوایی به شما پاداش می دهند که بی سروصدا در حال مسموم کردن چشمه ای است که خودشان از آن می نوشند.
این یک ادعای اخلاقی یا هشداری درباره «مچ گیری» و جریمه شدن نیست؛ بلکه توصیف مکانیزمی است که تاکنون چندین گروه از پژوهشگران آن را از زوایای مختلف مستند کرده اند. وقتی متوجه شوید که این قطعات پازل چگونه در کنار هم قرار می گیرند، بخش بزرگی از رفتارهای گیج کننده و متناقضِ موتورهای جستجوی مبتنی بر هوش مصنوعی (AI Search) دیگر برایتان عجیب نخواهد بود.
از «موتورهای جستجو» تا «موتورهای پاسخ گو»: تغییر بازی در دنیای اطلاعات
من در این مقاله قصد دارم این روند را ابتدا با اصطلاحات تخصصی و واقعی بررسی کنم—زیرا درک عمیقِ موضوع در گرو شناخت همین مفاهیم است—و سپس هر بخش را با زبانی ساده و روان توضیح دهم تا برای همه قابل فهم باشد.
قبل از اینکه جلوتر برویم، بیایید دو نمودار را در کنار هم قرار دهیم؛ زیرا ترکیب این دو نشان می دهد که چرا این موضوع همین الان اهمیت دارد، نه در آینده ای نامعلوم.
در سمت عرضه، بر اساس تحلیل های موسسه Graphite روی ده ها هزار صفحه، بیش از نیمی از مقالات جدید وبِ انگلیسی زبان در حال حاضر توسط هوش مصنوعی تولید می شوند (در وب فارسی نیز دقیقاً شاهد همین سونامی هستیم؛ جایی که روزانه هزاران مقاله ترجمه شده یا تولیدشده با چت بات ها بدون هیچ گونه ویرایش انسانی روی سایت ها قرار می گیرند).
در سمت تقاضا نیز، ماشین ها در حال تسخیر بخش عمده ای از پرسش گری هستند: جوردی ریباس (Jordi Ribas)، مدیر بخش جستجو و هوش مصنوعی مایکروسافت، اخیراً اعلام کرده است که طی چند سال آینده، ایجنت ها (عوامل) هوش مصنوعی می توانند هزاران بار بیشتر از تمام جستجوهای انسانی، کوئری (Query) ارسال کنند.
وب دقیقاً در همان لحظه ای در حال پر شدن از صفحاتِ نوشته شده توسط ماشین است که خوانندگانِ ماشینی قرار است به مخاطبان اصلی آن تبدیل شوند. هر دو سر این لوله، به طور همزمان در حال تبدیل شدن به محتوای مصنوعی (Synthetic) هستند.
نکته ای که باید به آن توجه کنید این است که احتمالاً پیش از این هم درباره کارهایی که در پایان این مقاله به شما پیشنهاد می دهم، شنیده اید. اما شرط می بندم هنوز نشنیده اید که چرا یا چگونه سیستم هایی کار می کنند که منجر به این تغییرِ پیش بینی شده از سوی من خواهند شد. اگر بخواهم کل ماجرا را در یک جمله خلاصه کنم: در نهایت، انسان ها برنده اند.
حالا بیایید از بخشی شروع کنیم که بیش از همه مرا شگفت زده کرد.
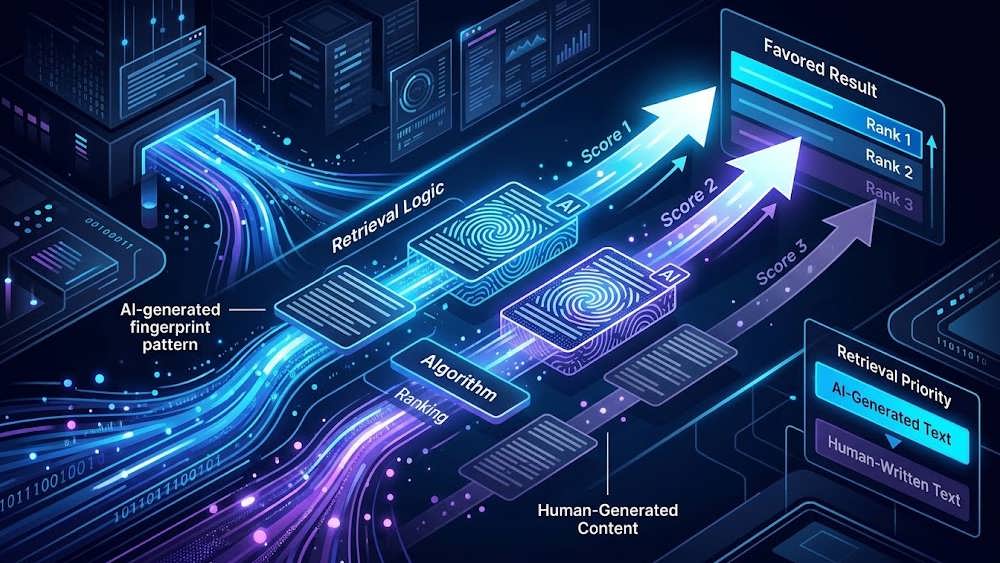
نمایش فرآیند تحلیل داده های متنی توسط موتورهای بازیابی و اولویت دهی به متن های روان و پیش بینی پذیر ماشینی.
سیستم ها کفه ی ترازو را به نفع متن های ماشینی سنگین کرده اند
متن های نوشته شده توسط ماشین دارای یک امضای ساختاریِ قابل تشخیص و یک «ردپای تولید» (Generation Fingerprint) هستند. تحقیقاتِ حوزه تشخیص محتوای هوش مصنوعی، این ردپا را نه به عنوان یک قطعیت ۱۰۰ درصدی، بلکه به عنوان یک احتمال و یک نشانه قوی در نظر می گیرند. تا اینجای کار مشکلی نیست. آنچه اهمیت دارد این نیست که این ردپا وجود دارد (چیزی که مدت هاست می دانیم)، بلکه مسئله این است که سیستم های بازیابیِ اطلاعات (Retrieval Systems) با این ردپا چه می کنند؟ پاسخ، دقیقاً برعکسِ آن چیزی است که اکثر مردم انتظار دارند!
حجم فزاینده ای از مقالات علمیِ داوری شده درباره موضوعی وجود دارد که محققان به آن «سوگیری منبع» (Source Bias) می گویند؛ مفهومی که در یک مقاله تأثیرگذار از آن با عنوان «سوگیریِ نامرئیِ ارتباط» یاد شده است. به زبان ساده: سیستم های بازیابی اطلاعات (یعنی همان قطعاتی که تصمیم می گیرند چه صفحاتی برای ساختن یک پاسخ واکشی شوند)، یک ترجیح و تمایلِ قابل اندازه گیری نسبت به متن های نوشته شده توسط ماشین دارند. آن ها ابتدا به سراغ این متن ها می روند و به آن ها رتبه بالاتری می دهند؛ حتی زمانی که یک صفحه نوشته شده توسط انسان، به همان خوبی به سوال پاسخ داده باشد!
مطالعه ای در کنفرانس SIGIR که این پدیده را نام گذاری کرد، نشان داد که مدل های بازیابی، محتوای تولیدشده توسط هوش مصنوعی را بدون هیچ دلیل موجهی از نظر میزان مرتبط بودن (Relevance)، بالاتر از محتوای انسانی رتبه بندی می کنند. دلیل اصلیِ این اتفاق چیست؟ متن های نوشته شده توسط ماشین معمولاً روان تر هستند و کلماتِ آن ها از نظر آماری پیش بینی پذیرترند. این ویژگی با معیاری به نام Perplexity (سرگشتگی یا پیچیدگی متن) سنجیده می شود. مدل های بازیابی ظاهراً به این «روان بودن و سادگی»، راحت تر اعتماد می کنند. اگرچه محققان هنوز درباره علت دقیق این موضوع بحث می کنند، اما اصلِ این اثر و نتیجه آن بارها تایید شده است.
در حال حاضر، ردپای هوش مصنوعی یک نقطه ضعف نیست؛ بلکه یک مزیت رقابتی در رتبه بندی است!
در عمل، قضیه این گونه است: دو صفحه به یک سوال به طور مساوی و عالی پاسخ می دهند؛ یکی توسط انسان نوشته شده و دیگری خروجی یک مدل هوش مصنوعی است. وقتی هر دو صفحه به سیستم بازیابی پیشنهاد می شوند، سیستم به سراغ نسخه تولیدشده (AI) می رود. نه به این دلیل که دقیق تر است، بلکه به این دلیل که جملاتِ روان و به شدت پیش بینی پذیرِ آن، برای سیستمی که خودش با حجم عظیمی از همین نوع متن ها آموزش دیده، «قابل اعتمادتر» به نظر می رسد. محتوای انسانی بدتر نبود؛ صرفاً شبیه به آن چیزی نبود که ماشین یاد گرفته است به عنوان یک «پاسخ خوب» بپذیرد. این انتظارِ ماشین، اکنون به یک مزیتِ رتبه بندی تبدیل شده که شما برای به دست آوردنش هیچ زحمتی نکشیده اید و رقیب انسانیِ شما هم کاری برای از دست دادنش نکرده است.
حجم کمی از محتوای مصنوعی در استخر داده، به حجم عظیمی در پاسخ ها تبدیل می شود
حالا عنصر «زمان» را هم به این سوگیری اضافه کنید. مقاله ای در کنفرانس وب (Web Conference) در سال ۲۰۲۶، مدلی از اتفاقی که با انباشته شدن مداوم محتوای ماشینی در استخر منابعِ موتورهای جستجو رخ می دهد، ارائه کرد و نام این حالتِ شکست را «فروپاشی سیستم بازیابی» (Retrieval Collapse) گذاشت.
آزمایش کنترل شده ی آن ها بسیار جالب است: آن ها کار را با نتایج جستجوی واقعی آغاز کردند و سپس مرحله به مرحله، صفحات تولیدشده توسط هوش مصنوعی و سئوشده را به این استخر اضافه کردند تا جایی که محتوای مصنوعی، دو سوم (حدود ۶۶٪) از کل استخر داده ها را تشکیل داد.
عدد مهم اینجاست: در این سطح از آلودگیِ استخر (دِو سوم)، بیش از ۸۰ درصد از منابعی که در نهایت برای ساخت پاسخ ها (توسط هوش مصنوعی جستجوگر) واکشی شدند، مصنوعی بودند! بگذارید واضح تر بگویم: یک اکثریتِ نسبی از صفحاتِ ماشینی در استخر داده، توانستند اکثریتِ قاطعِ منابع را در پاسخ های نهایی به خود اختصاص دهند. چرا؟ چون این صفحات دقیقاً برای تحریکِ سیگنال های رتبه بندی ساخته شده بودند و بسیار فراتر از سهم واقعی شان انتخاب شدند. آن «سوگیری و ترجیح ماشین» که در بخش قبل گفتیم، اینجا نقش یک تقویت کننده (آمپلی فایر) را بازی می کند. مقدار کمی محتوای مصنوعی در استخر، به مقدار عظیمی از محتوای مصنوعی در پاسخ ها تبدیل می شود.
این موضوع را روی یک جستجوی ساده تصور کنید؛ مثلاً «پروبیوتیک ها چقدر طول می کشد تا اثر کنند؟». در ابتدا، ۱۰ منبعی که موتور جستجو به سراغ آن ها می رفت شامل تنوع بی نظیری بود: مقاله یک پزشک متخصص، صفحه بهداشت یک دانشگاه معتبر، سایت یک تولیدکننده مکمل، یک تاپیک طولانی در یک انجمن گفتگوی کاربران، و چند سایت معتبر سلامت. این یعنی تنوع کامل از دیدگاه ها و تجربیات واقعی. اما بعد از ۲۰ دور انباشتِ محتوای هوش مصنوعی، ۸ تا از آن ۱۰ جایگاه، مقالاتی ماشینی و تقریباً مشابه هستند که همگی دقیقاً همان چند ادعای محدود را بازنویسی کرده اند و تنها تفاوتشان، لوگوی بالای سایت هایشان است! پاسخی که به عنوان کاربر دریافت می کنید هنوز هم منطقی و روان به نظر می رسد؛ اما اکنون تقریباً به طور کامل از روی «کپی هایی از یک کپی دیگر» مونتاژ شده است. آن تضاد آرا، عمق تجربه و بافت انسانی که در لیست منابعِ قدیمی وجود داشت، حالا کاملاً خفه و خاموش شده است.
به همین دلیل است که ما در دپارتمان سئو و طراحی سایتِدانش وب، همیشه به کسب وکارها گوشزد می کنیم که تولید فله ای محتوای ماشینی بدون ارزش افزوده انسانی، شاید در کوتاه مدت نمودارهای شما را سبز کند، اما در بلندمدت هویت برند شما را در میان انبوهی از محتواهای تکراری دفن خواهد کرد.
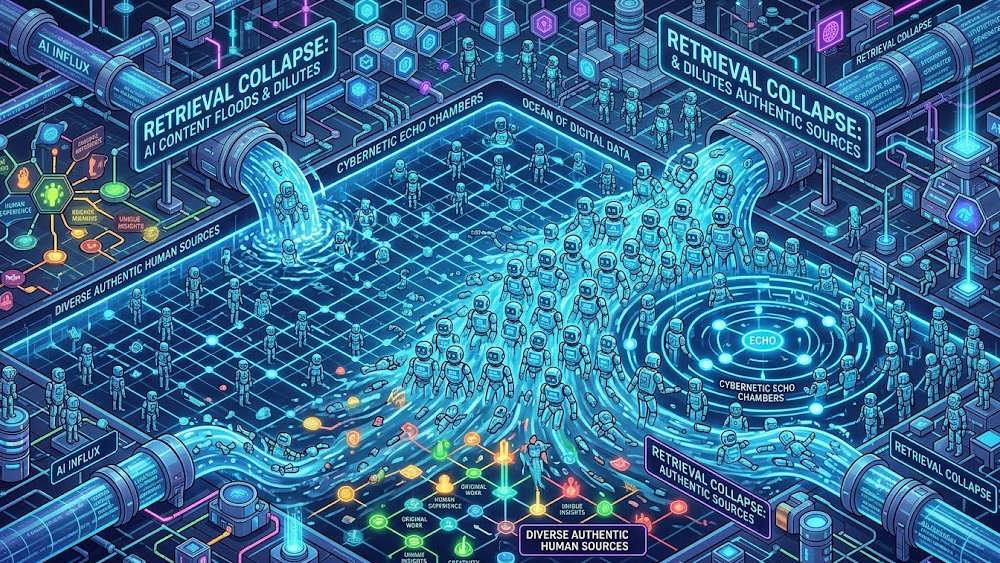
تصویرسازی مفهومی از غلبه محتواهای مشابه و کپی برداری شده ی هوش مصنوعی در پایگاه داده های وب.
عقربه ای که همه به آن نگاه می کنند سبز می ماند (وضعیتِ سالمِ فریبنده)
این همان بخشی است که باید تمام توجه شما را به خود جلب کند. در تمام طولِ این آلودگیِ محتوایی، دقتِ پاسخ های موتور جستجو تقریباً هیچ تغییری نکرد و روی ۶۸ تا ۷۰ درصد ثابت ماند. پژوهشگران به این حالت «وضعیت سالمِ فریبنده» (Deceptively Healthy State) می گویند.
نسخه ساده سازی شده ی این مفهوم، دقیقاً دلیلِ نگارشِ این مقاله است: پاسخ های خروجی هنوز از بیرون «درست» به نظر می رسند، بنابراین هیچ چیز خراب به نظر نمی آید. اما در زیر پوستِ ماجرا، منابعی که در حال تغذیه این پاسخ ها هستند، به شدت محدود شده و به منابعِ عمدتاً مصنوعی تنزل یافته اند. تنوع واقعی منابع از بین رفته است. سیستم در آن عقربه ای که همه به آن زل زده اند (میزان ترافیک یا ایمپرشن ظاهری) کاملاً سبز و سالم به نظر می رسد، اما در عقربه ای که تقریباً هیچ کس به آن نگاه نمی کند (تنوع و اصالت منابع)، کاملاً توخالی شده است.
دامِ واقعی اینجاست: تیم تولید محتوا داشبوردِ ابزار سئوی خود را باز می کند و می بیند که نرخ استناد (Citation Rate) به مقالاتشان ثابت است یا حتی در حال رشد است. همه چیز روی صفحه نمایش سبز است. اما چیزی که این داشبورد به آن ها نشان نمی دهد این است که ۳ یا ۴ منبع دیگری که در کنار آن ها در نتایج موتورهای پاسخ دهنده ظاهر شده اند (که یک سال پیش، ۸ یا ۱۰ رسانه کاملاً متفاوت و مستقل بودند)، حالا همگی خوشه ای از سایت های کپی کار هستند که همان ادعاها را با همان فرمت تکرار می کنند. از آنجا که سایتِ این تیم هنوز هم به عنوان منبع ذکر (Cite) می شود، ابزارهای سئو وضعیت را «سالم» گزارش می دهند. محیطِ اطلاعاتی ای که سایت آن ها در آن قرار گرفته، بی سروصدا به یک «اتاق پژواک» (Echo Chamber) تقلیل یافته است. حضور (Presence) حفظ شده، اما تنوع (Diversity) فروپاشیده است؛ و مشکل اینجاست که داشبوردها فقط مورد اول را به ما نشان می دهند.
این یک درس بزرگ در زمینه متریک ها و تحلیل داده است که به راحتی می توان آن را اشتباه متوجه شد. اگر فقط پیگیری کنید که یک موتور جستجوی هوش مصنوعی چقدر به شما لینک می دهد، یک عددِ ظاهرالصلاح فقط به شما می گوید که در یک جستجوی خاص حضور داشته اید. این عدد هیچ چیزی درباره اینکه آیا استخرِ محتواییِ اطرافِ شما در حال فروپاشی و تبدیل شدن به یک دریای یکنواخت است یا خیر، به شما نمی گوید.
چرا این وضعیت نمی تواند به یک نرمالِ جدید تبدیل شود؟
اگر ماشین ها ردپای هوش مصنوعی را دوست دارند و استخر محتوا در حال یکدست شدن است، چرا به آن «چشمه ی مسموم» می گوییم و آن را یک تعادلِ پایدار نمی دانیم؟
پاسخ روشن است: چون سیستم در حال نوشیدنِ خروجی های خودش است! ما شواهد قدرتمندی داریم که نشان می دهد در طول زمان چه اتفاقی برای چنین سیستمی می افتد. تحقیق مجله معتبر Nature درباره «فروپاشی مدل» (Model Collapse) نشان داد که مدل های زبانی ای که با داده های تولیدشده توسط خودشون (به صورت بازگشتی) آموزش می بینند، در نسل های متوالی دچار افت کیفیت و فروپاشی می شوند؛ درست شبیه به گرفتنِ یک فتوکپی از یک فتوکپی دیگر، که در هر مرحله کمی از کیفیت آن کم می شود تا اینکه در نهایت تصویر به یک لکه نامفهوم تبدیل می گردد.
لایه بازیابی اطلاعاتِ موتورهای جستجو که روزبه روز پاسخ هایش را بیشتر بر پایه منابع تولیدشده توسط هوش مصنوعی (که توسط همان مدل ها تولید شده اند) استوار می کند، در واقع در حال تجربه کردنِ همین چرخه ویرانگر با سرعتی کمتر است. موتورهای جستجو برای «بقا» باید به این موضوع اهمیت دهند. نویسندگانِ مقاله فروپاشی سیستم بازیابی، صراحتاً توصیه می کنند که سازمان ها باید محتوای تأییدشده و انسانی (Trusted, Human-reviewed Content) را به عنوان یک دارایی استراتژیک در نظر بگیرند و به جای تمرکز صرف روی دقت، شروع به ردیابی منشأ (اصالت) و تنوع منابع کنند.
در اینجا یک تناقض مهم وجود دارد: در حال حاضر، پلتفرم ها (مثل گوگل) می گویند که برایشان فرقی نمی کند محتوا چگونه تولید شده است. دستورالعمل های رسمی گوگل درباره هوش مصنوعی به وضوح می گوید که آنچه اهمیت دارد «مفید بودن» محتواست (Helpful Content)، نه نحوه تولید آن.
بنابراین سه نیروی قدرتمند به طور همزمان در سه جهتِ متفاوت در حال کشمکش هستند:
- یک سوگیریِ مستند و فعلی در سیستم های بازیابی که به نفع متن های ماشینی است.
- ادعای بی طرفی از سوی پلتفرم ها که محتوای ماشینی را نه پاداش می دهند و نه جریمه می کنند.
- یک فشار ساختاری برای «بقا» که در نهایت باید این سیستم ها را مجبور کند به منابع متنوع و تأییدشده توسط انسان ها امتیاز ویژه بدهند.
من نمی توانم تاریخ دقیقی برای حل این درگیری به شما بدهم یا بگویم کدام نیرو در نهایت پیروز می شود. اما می توانم با قطعیت بگویم که بنا کردن یک استراتژی بر اساس این فرض که «سوگیری فعلیِ موتورهای جستجو تا ابد پابرجا می ماند»، در واقع شرط بندی علیه تنها نیرویی است که ادامه حیاتِ خود موتورهای جستجو به آن وابسته است. انتخاب من در این شرط بندی؟ من روی ارزشمندتر شدنِ محتوایِ تولیدشده توسطِ انسان در گذر زمان شرط می بندم.
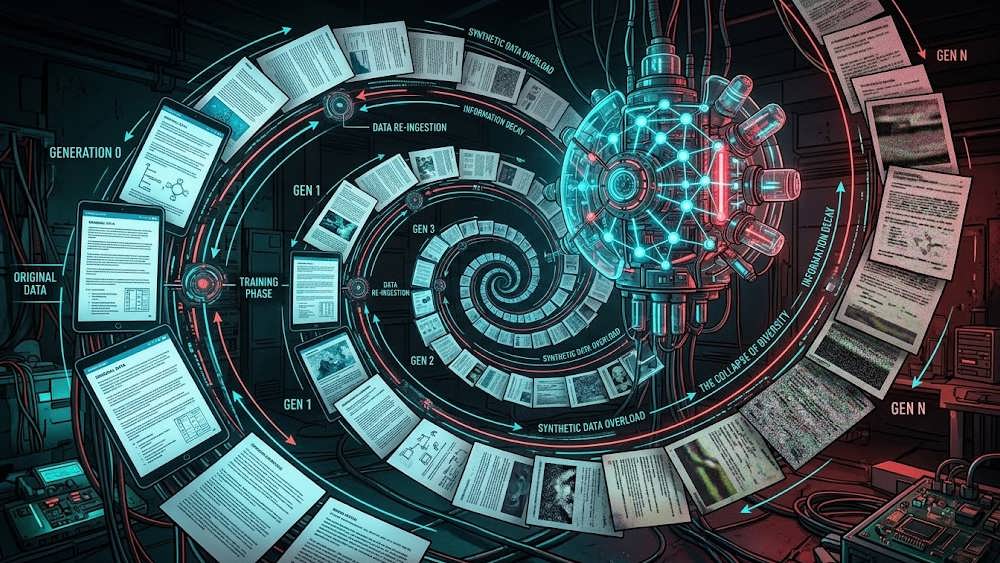
حلقه ای بی انتها از تغذیه هوش مصنوعی از خروجی های خودش که منجر به افت کیفیت تدریجی پاسخ ها می شود.
چه باید کرد؟ (راهکارهای عملی)
هیچ کدام از مواردی که در ادامه می آید، توصیه های کلیشه ای و عمومیِ سئو نیستند؛ بلکه هر اقدام مستقیماً به یکی از مکانیزم هایی که در بالا به آن اشاره شد، متصل است:
۱. چیزی را تولید کنید که یک استخر محتوای ماشینی قادر به بازتولید آن نیست.
تنها دسته ای از محتوا که یک شبکه یکنواخت و خودارجاع دهنده ی هوش مصنوعی از نظر ساختاری نمی تواند آن را تولید کند، شواهد اورجینال است: داده های دست اول (First-party data)، تحقیقات اولیه، تست و بررسی شخصی محصولات، و گزارش های میدانی مستقیم.
هر چیزی که یک مدل زبانی (LLM) می نویسد، برگرفته از چیزهایی است که از قبل وجود داشته اند. اطلاعات واقعاً جدید، باید از خارجِ این سیستم وارد آن شود؛ و این کارِ کسی است که رفته و آن اطلاعات را پیدا کرده است. این نه تنها یک بازی بر سر کیفیت است، بلکه دقیقاً همان متریالی است که به گفته محققان، «تنوع منابع» را حفظ می کند و موتورهای جستجو در آینده به شدت به آن محتاج خواهند شد.
۲. اصالت خود را خوانا و شفاف کنید (Provenance).
اگر فشار آینده موتورهای جستجو به سمت اولویت دادن به منابعِ تأییدشده توسط انسان هاست، حرکت عملی و کوتاه مدت شما این است که بدون هیچ ابهامی به عنوان یک انسانِ معتبر قابل شناسایی باشید. (توضیح تکمیلی: این دقیقاً همان مفهوم E-E-A-T در گوگل است).
نام نویسنده واضح باشد، مدارک معتبر مرتبط با افراد واقعی وجود داشته باشد، منابعی ارائه دهید که خواننده (یا ماشین) بتواند آن ها را بررسی کند، و سوابق درخشانی در فضای وب از خود به جا بگذارید. شما در حال تلاش برای تبدیل شدن به گره ای هستید که یک سیستمِ حساس به اصالت منبع (که به زودی از راه می رسد)، بتواند آن را شناسایی کرده و حفظ کند. به یاد داشته باشید: محتوای تأییدشده توسط انسان، یک دارایی استراتژیک است.
۳. اعداد و ارقام خود را با در نظر گرفتن «فروپاشی محتوا» تحلیل کنید.
نرخ لینک دهی (Citation Frequency) را به عنوان یک شاخصِ جهت دار در نظر بگیرید، نه یک عدد مطلق. مراقب آن «شکافِ فریبنده» در داده های خود باشید: آیا سایت شما دارد در میان پاسخ هایی نمایش داده می شود که در محاصره مشتی سایتِ بی کیفیتِ ماشینی هستند؟ افزایش نرخ ارجاع در یک استخرِ در حالِ فروپاشی، اصلاً آن پیروزی بزرگی نیست که تصور می کنید. تیم های حرفه ای به جای تمرکز صرف بر میزان حضورشان، روی تنوع منابع و میزان اصالتِ رقبای اطرافشان تمرکز می کنند.
۴. خودتان را شبیه به «ردپای هوش مصنوعی» سئو و بهینه سازی نکنید.
این سخت ترین و غیرقابل هضم ترین توصیه است؛ چرا که دقیقاً همان نوع از بهینه سازی که امروز باعث می شود سیستم های بازیابیِ اطلاعات به شما علاقه مند شوند، همان چیزی است که فردا باعث «فروپاشی سیستم» خواهد شد.
منظور من این نیست که ساختار یا شفافیت متن خود را رها کنید؛ منظورم این است که اگر محتوای شما از نظر ساختاری و لحن هیچ تفاوتی با مقالاتِ پرکننده و بی ارزشِ تولیدشده توسط هوش مصنوعی ندارد، شما تمام دارایی خود را روی یک «باگ و سوگیری موقت» شرط بسته اید که موتورهای جستجو برای حفظ بقای خود مجبور به اصلاح آن هستند! راه فرار این است که در جاهایی که اهمیت دارد، یعنی در ارائه مدارک مستدل، هویت نویسنده و قضاوت های انسانی ای که ماشین قادر به جعل آن نیست، به شکلی کاملاً اثبات پذیر انسان باشید.
نتیجه گیری
حرف آخر این است: محتوایی که امروز در موتورهای جستجوی هوش مصنوعی برنده می شود، در یک مسیر تصادفِ شاخ به شاخ با چیزی قرار دارد که این موتورها برای ادامه حیاتشان در آینده به آن نیاز دارند!
متخصصینی که در حال ساختن گره های ارتباطی غیرمصنوعی، دارای هویت شفاف و مبتنی بر شواهد واقعی هستند، به دنبال سوءاستفاده از سوگیریِ فعلی سیستم نیستند؛ آن ها در حال جاگیری و استقرار برای زمانی هستند که سیستم، اصلاحاتِ لازم برای بقای خود را اعمال کند.
بله، این یک بازیِ کُندتر از بهینه سازی های سریع برای گرفتن ورودی در این ماه یا این فصل است؛ اما این دقیقاً همان بازی ای است که من پول و سرمایه ام را روی آن شرط می بندم.