

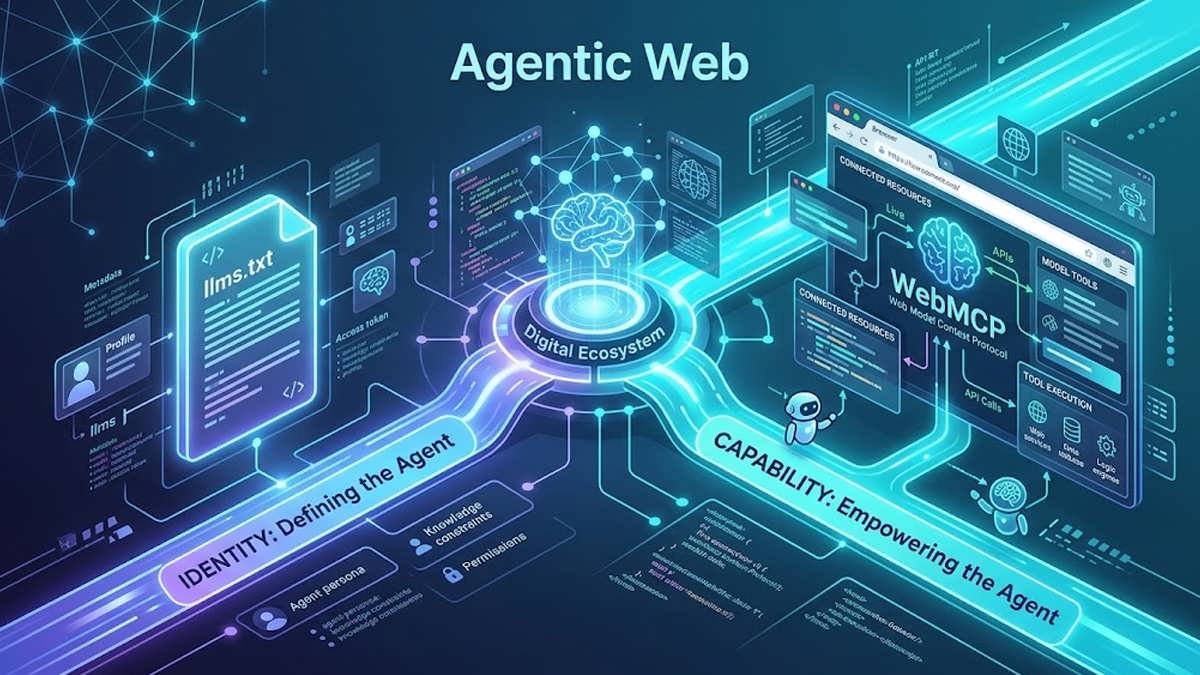
لایه پروتکل در وب مبتنی بر عامل های هوش مصنوعی (Agentic Web) در حال تقسیم شدن به دو مسیر یا استراتژی متفاوت است؛ و جالب اینجاست که اکثر وب سایت ها، بدون اینکه حتی روحشان هم خبر داشته باشد، در یکی از این مسیرها قرار گرفته اند.
مسیر اول درباره «هویت» (Identity) است: فایلی به نام llms.txt که به مدل های هوش مصنوعی می گوید شما چه کسی هستید و محتوای سایتتان درباره چیست. مسیر دوم درباره «قابلیت» (Capability) است: یک استاندارد مرورگر به نام WebMCP که به عامل هوشمند (AI Agent) می گوید وقتی وارد سایت شما شد، دقیقاً چه کارهایی می تواند انجام دهد.
شاید در نگاه اول هر دو یک مفهوم به نظر برسند، اما در واقعیت به دو سؤال کاملاً متضاد پاسخ می دهند. درک این تفاوت مشخص می کند که در سال آینده باید زمان و بودجه خود را روی چه چیزی سرمایه گذاری کنید؛ زیرا یکی از این مسیرها به طور پیش فرض برای شما فعال شده است، در حالی که دیگری – یعنی همان مسیری که واقعاً به هوش مصنوعی اجازه می دهد یک کار را در سایت شما به پایان برساند – نیازمند تلاش و برنامه ریزی هدفمند است. (توضیح تکمیلی: در تیم دانش وب، ما همیشه به کارفرمایان خود یادآوری می کنیم که در سئوی مدرن، داشتن یک ویترین زیبا کافی نیست، بلکه زیرساخت سایت باید برای تعامل ربات ها نیز بهینه سازی شده باشد).
۲ فایل، ۲ سؤال متفاوت
یک عامل هوشمند (AI Agent) که وارد وب سایت شما می شود، معمولاً به دنبال یافتن پاسخ دو چیز است:
- این سایت چیست و چه موضوعاتی را پوشش می دهد؟
- حالا که اینجا هستم، چگونه باید وظیفه ای که کاربر به من سپرده است را انجام دهم؟
ابتدا «هویت»، سپس «قابلیت». وبِ مبتنی بر عامل ها، برای هر یک از این موارد پاسخ جداگانه ای می سازد و این دو پاسخ از دو فایل متفاوت که توسط دو جبهه مختلف پشتیبانی می شوند، نشأت می گیرند.
پاسخِ بخش هویت، فایل llms.txt است؛ یک فایل متنی ساده که در روت (Root) دامنه خود منتشر می کنید. این فایل شبیه به یک نقشه راهنماست: «من این هستم، این ها مهم ترین صفحات من هستند و هر کدام درباره این موضوع صحبت می کنند.»
اما پاسخِ بخش قابلیت، WebMCP است؛ یک استاندارد مرورگر که به وب سایت شما اجازه می دهد ابزارهای قابل فراخوانی (Callable Tools) را در اختیار عامل هوشمند قرار دهد. با این استاندارد، هوش مصنوعی می تواند به جای حدس زدن و کلیک کردنِ تصادفی روی رابط کاربری شما، با فراخوانی یک تابع مشخص، مستقیماً در سایت شما جستجو کند، فیلتر بگذارد، قیمت ها را چک کند یا یک رزرو انجام دهد.
امروزه llms.txt و WebMCP به اشتباه در یک دسته قرار می گیرند و هر دو را زیر چتر «آمادگی برای هوش مصنوعی» (Agent-readiness) می شناسند. اما این دو به سؤالات کاملاً متفاوتی پاسخ می دهند. هویت، یک بروشور تبلیغاتی است؛ قابلیت، دستگاه کارتخوان (صندوق فروشگاهی) است. در حال حاضر، صنعت وب در حال هل دادنِ همه سایت ها به سمت «بروشور» است؛ مسیری که شواهد ضعیف تری برای اثربخشی دارد. در حالی که «صندوق فروشگاهی» – یعنی همان چیزی که واقعاً باعث ایجاد تراکنش و فروش می شود – تنها برای تیم های معدودی که حاضرند برای ساختنش وقت بگذارند، باقی مانده است.
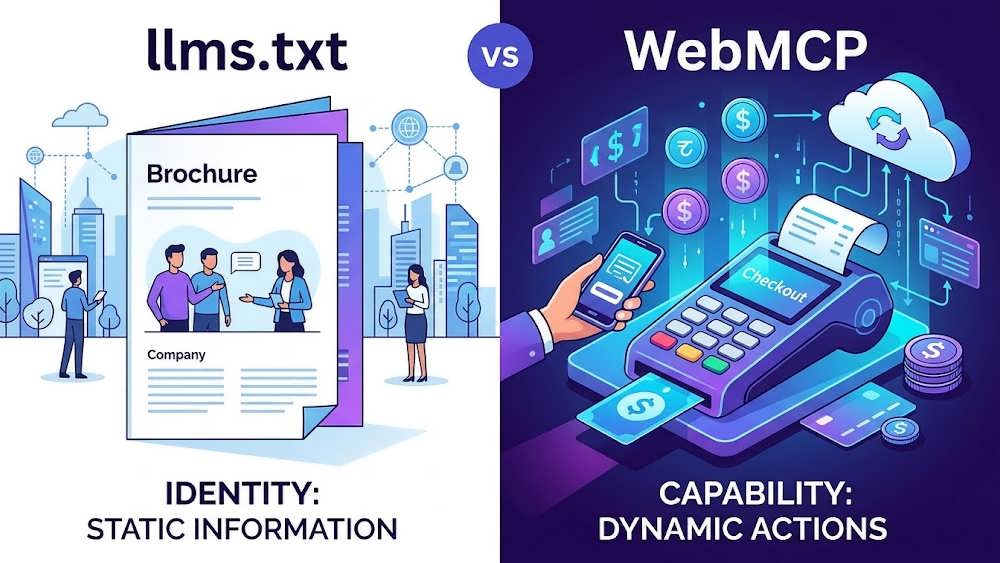
تصویری مفهومی که یک دفترچه راهنما (هویت) را در مقابل یک دستگاه پایانه فروشگاهی و تعاملی (قابلیت) قرار می دهد.
مسیر هویتی: فایل LLMs.txt
فایل llms.txt یک فایل با فرمت مارک داون (Markdown) است که در آدرس yourdomain.com/llms.txt قرار می گیرد. این ایده اولین بار در ۳ سپتامبر ۲۰۲۴ توسط جرمی هاوارد (Jeremy Howard)، هم بنیان گذار Answer.AI، مطرح شد. هدف این بود که به جای مجبور کردن مدل های زبانی برای خزش (Crawl) سایت و استخراج محتوا از میان کدهای HTML شلوغ، منوها، تبلیغات و اسکریپت ها، یک فهرست تمیز و تنظیم شده توسط انسان در اختیار آن ها قرار گیرد. این ایده در ظاهر کاملاً منطقی است: مدل های هوش مصنوعی با ساختارِ منظم بهتر کار می کنند، پس بیایید به آن ها ساختار بدهیم.
اما مشکل اینجاست که شواهدِ اثربخشی این فایل بسیار ناچیز است. در ژوئن ۲۰۲۶، جان مولر (John Mueller) از مدیران گوگل، در ردیت پاسخ داد که llms.txt “در حال حاضر کاملاً جنبه گمانه زنی دارد (این فایل سال هاست که وجود دارد، اما هنوز هیچ یک از سیستم های اصلی هوش مصنوعی از آن استفاده نمی کنند)” (به نقل از Search Engine Journal). این حرفِ یکی از حامیان اصلی جستجوی گوگل است که حقیقتِ پنهان را فاش می کند: فایلی که بیش از یک سال از عمرش می گذرد، هیچ سیستم هوش مصنوعی بزرگی استفاده از آن را تأیید نکرده است و از شما می خواهد که یک کپی دوم از محتوای سایتتان را همیشه با آن همگام سازی (Sync) کنید!
حتی با وجود این شواهد ضعیف، llms.txt به طور پیش فرض برای بسیاری از سایت ها فعال می شود. مثلاً افزونه AIOSEO که در بیش از ۳ میلیون سایت وردپرسی استفاده می شود، به طور پیش فرض این فایل را تولید می کند. (نکته تخصصی: در پروژه های طراحی سایت و سئوی دانش وب، ما همواره تنظیمات پیش فرض افزونه ها را بررسی می کنیم تا از ایجاد فایل های بیهوده و مصرف بی دلیل بودجه خزش (Crawl Budget) جلوگیری کنیم). در نتیجه، اکنون تعداد بسیار زیادی از صاحبان سایت ها در حال انتشار فایلی هستند که هرگز تصمیمی برای ساختنش نداشته اند و سایتشان در فایلی توصیف می شود که خودشان تا به حال آن را نخوانده اند.
برای روشن شدن موضوع: من مخالف این فایل نیستم. یک llms.txt که به خوبی نگهداری شود، فهرست محتواییِ مناسبی است. مشکل، «فعال بودن پیش فرض» آن است. مسیر هویتی در حال پیروز شدن در نرخ استفاده است، اما نه به خاطر اینکه کار می کند، بلکه فقط به این دلیل که تیکِ یک افزونه به صورت پیش فرض روشن مانده است. این بسیار عجیب است که فایلی که خودتان ننوشته اید، هیچ هوش مصنوعی ای آن را نمی خواند و به محض اینکه فراموشش کنید از محتوای واقعی سایتتان عقب می افتد، به هسته اصلی استراتژی هوش مصنوعی شما تبدیل شود!
مسیر قابلیتی: استاندارد WebMCP
واژه WebMCP مخفف Web Model Context Protocol است. این یک استاندارد مرورگر است که به سایت شما اجازه می دهد ابزارهایی را ثبت کند که یک عامل هوشمند می تواند از طریق API به نام navigator.modelContext آن ها را فراخوانی کند.
این استاندارد با سؤالی متفاوت از فایل هویتی آغاز می شود: سؤال این نیست که شما چه کسی هستید، بلکه این است که با توجه به اینکه هوش مصنوعی هم اکنون داخل سایت شماست، چگونه می تواند وظیفه ای که برای آن آمده را به درستی انجام دهد؟ این دقیقاً همان رویکردی است که جان مولر هم به آن علاقه نشان داد. او گفت که استاندارد WebMCP و ادغام های فروشگاهیِ آن را دوست دارد، زیرا “آن ها اهداف و فرآیندهای واضحی دارند.”
به جای اینکه عامل هوشمند از صفحه شما اسکرین شات بگیرد و با پردازش تصویر حدس بزند که باید کجا کلیک کند، سایت شما مستقیماً به او می گوید: “این ها اکشن هایی هستند که من پشتیبانی می کنم، این ها ورودی هایی هستند که هر کدام نیاز دارند و در نهایت این خروجی را دریافت می کنی.” بدین ترتیب کنترل ماجرا معکوس می شود؛ سایت قابلیت های خود را مستقیماً اعلام می کند، به جای اینکه هوش مصنوعی مجبور باشد با مهندسی معکوس آن ها را کشف کند.
این استاندارد توسط مهندسان گوگل و مایکروسافت در گروه کاربری یادگیری ماشین وب W3C نوشته شده و در ۱۰ فوریه ۲۰۲۶ به صورت پیش نویس منتشر شد. اکنون این ویژگی در یک دوره آزمایشی (Origin Trial) عمومی از نسخه کروم ۱۴۹ تا کروم ۱۵۶ در حال اجراست. (توضیح: Origin Trial روشی است که کروم به وب سایت ها اجازه می دهد با ثبت نام و دریافت یک توکن، یک ویژگی آزمایشی را برای بازدیدکنندگان واقعی خود فعال کنند، نه اینکه آن را فقط پشت پرچم های مخصوص توسعه دهندگان پنهان کنند). بنابراین شما همین الان می توانید ابزارهای WebMCP را روی ترافیک زنده سایتتان اجرا کنید. جالب است بدانید عاملی که امروز در کروم از این ابزارها استفاده می کند، هوش مصنوعی Gemini گوگل است.
WebMCP استراتژیِ قدرتمندتری است، زیرا وظیفه مشخصی دارد. فایل هویتی شما را توصیف می کند و «امیدوار» است که کسی آن را بخواند. اما ابزار قابلیتی مستقیماً فراخوانی می شود، داده های ساختاریافته (Structured Data) را برمی گرداند و کار کاربر را یک قدم به اتمام نزدیک تر می کند. بروشور فقط منتظر خوانده شدن می ماند، اما صندوق فروشگاهی به صدا درمی آید و پول خلق می کند.
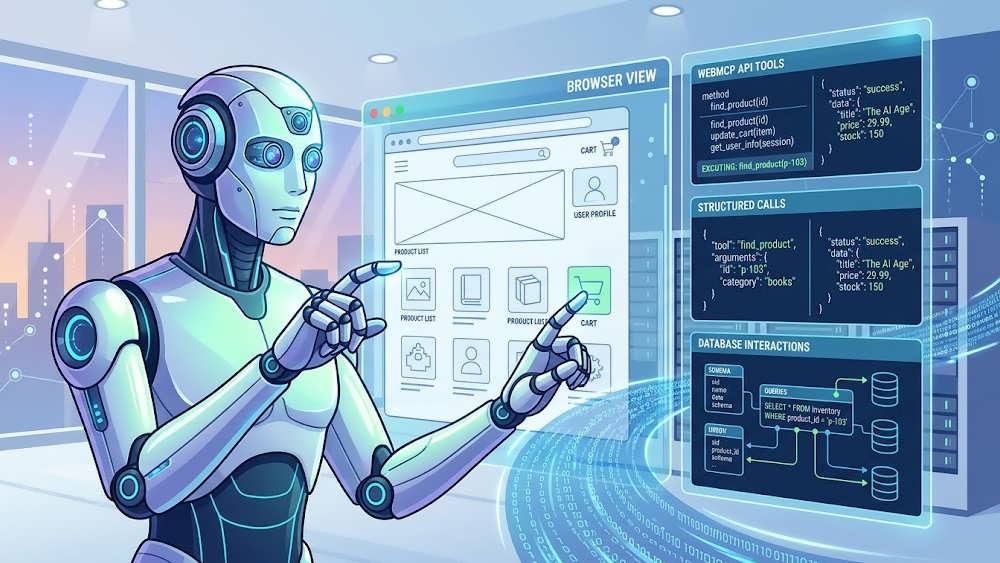
ربات هوش مصنوعی که مستقیماً ابزارها و اکشن های API یک سایت را از طریق مرورگر فراخوانی می کند.
چرا این دو استراتژی قابل جایگزینی با یکدیگر نیستند؟
بهترین راه برای درک این تفاوت، نگاه به دو محدودیت طراحی در «معماری مبتنی بر ماشین» (Machine-First Architecture) است: هویت و تعامل.
هویت یعنی برند و محتوای شما به شکلی خوانا برای ماشین ها ارائه شود. تعامل یعنی به یک عامل اجازه دهید یک اقدام را با نتیجه ای قابل پیش بینی کامل کند. فایل llms.txt بازی در لایه هویت است، در حالی که WebMCP بازی در لایه تعامل است. وب سایت شما بسته به اینکه می خواهد هوش مصنوعی در آن چه کاری انجام دهد، ممکن است به هر دو، یکی یا هیچ کدام نیاز داشته باشد.
این موضوع زمانی اهمیت بیشتری پیدا می کند که بدانید عامل های هوشمند دیگر فقط یک بخش جزئی از ترافیک سایت شما نیستند. متیو پرینس (Matthew Prince)، مدیرعامل کلادفلر (Cloudflare)، در ژوئن ۲۰۲۶ اعلام کرد که برای اولین بار ترافیک ربات های خودکار از ترافیک انسانی پیشی گرفته است (۵۷.۳٪ درخواست ها از سوی ماشین ها در برابر ۴۲.۷٪ از سوی انسان ها). وقتی بیشتر درخواست های سایت شما توسط ماشین هایی انجام می شود که از طرف انسان ها کار می کنند، اینکه آیا ماشین می داند شما کیستید، دیگر سؤال مهمی نیست. اینکه آیا ماشین می تواند واقعاً کاری که مشتری شما خواسته را انجام دهد، تمام بازی را تغییر می دهد. هویتِ بدون قابلیت، مانند ماشینی است که تابلوی مغازه شما را می خواند اما پشت دری می ایستد که نمی تواند آن را باز کند!
من هر دو استراتژی را با آگاهی روی سایت خودم پیاده کردم
من در وب سایت خودم (No Hacks) از هر دو استفاده می کنم و تفاوت هزینه پیاده سازی این دو، به خوبی نشان دهنده اصل ماجراست.
برای بحث هویت، من یک فایل llms.txt دارم و به جای اینکه اجازه دهم یک افزونه آن را به صورت خودکار بسازد (که هرگز هم آن را نمی خوانم)، هر بار که سایت را آپدیت می کنم، این فایل را از روی محتوای اصلی سایت بازتولید می کنم. این بخشِ آگاهانه ماجراست. از آنجا که با هر تغییر سایت، فایل را دوباره می سازم، همیشه با محتوای واقعی همگام است. اگر روزی هوش مصنوعی واقعاً شروع به خواندن این فایل کند، سایت من آماده است. اما روی آن شرط بندی نمی کنم! فقط آن را به روز و کم هزینه نگه می دارم و آن را با یک استراتژی واقعی اشتباه نمی گیرم.
برای بحث قابلیت، من WebMCP را پیاده سازی کردم. وقتی یک مرورگرِ پشتیبانی کننده از WebMCP سایت را لود می کند، چهار ابزار قابل فراخوانی ثبت می شوند. دو مورد مربوط به واژه نامه (Glossary) سایت هستند تا هوش مصنوعی بتواند تعاریف تخصصی و لینک منابع را مستقیماً استخراج کند. دو مورد دیگر مربوط به لیست محصولات و مرورگرهای هوشمندِ در حال رصد من هستند. بنابراین، هوش مصنوعی برای پیدا کردن اطلاعات نیازی به اسکرپ کردن (Scrape) صفحات من ندارد؛ فقط کافی است ابزار را فراخوانی کند تا پاسخی تمیز و ساختاریافته دریافت کند.
نکته طلایی این است که ابزارها داده های خود را از کجا می خوانند. ابزارهای من دقیقاً از همان دیتابیسی استفاده می کنند که صفحه کاربر انسانی را می سازد. بنابراین پاسخ هوش مصنوعی و پاسخ انسانی هرگز با هم تناقض ندارند، زیرا هر دو از یک منبع تغذیه می شوند. این همان تفاوتِ بین «ایجاد قابلیت» و «نگهداری یک فایل توصیفیِ جداگانه» است.
به همین دلیل است که من هر دو را دارم: پیاده سازی یکی یک بعدازظهر زمان برد و واقعاً کار می کند، دیگری را فقط از محتوای خودم بازتولید می کنم و به آن به چشم یک بیمه نگاه می کنم، نه یک نقشه راه عملی.
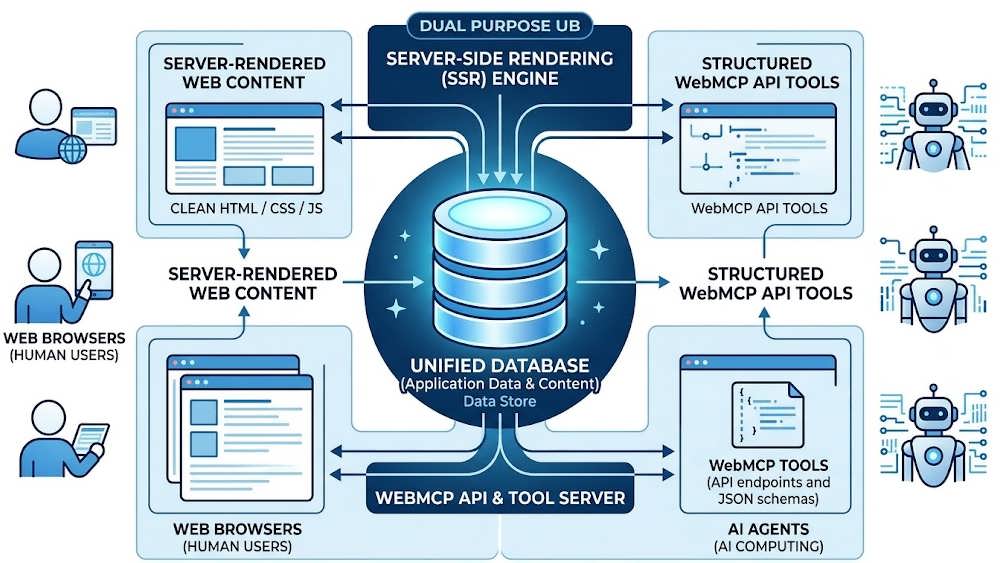
نموداری فنی که تغذیه همزمان صفحات وب انسانی و ابزارهای WebMCP را از یک دیتابیس واحد نشان می دهد.
این موضوع برای وب سایت شما چه معنایی دارد؟
اول از همه، ببینید در حال حاضر چه چیزی در سایتتان منتشر شده است. آدرس yourdomain.com/llms.txt را در مرورگر وارد کنید. اگر چیزی لود شد، احتمالاً افزونه های شما به صورت پیش فرض آن را ساخته اند. آن را بخوانید و بپرسید که آیا واقعاً سایت شما را به درستی توصیف می کند؟ اگر روزی هوش مصنوعی بخواهد این فایل را بخواند، یک فایلِ پر از غلط به مراتب بدتر از نداشتن فایل است! بررسی این مورد فقط ۵ دقیقه زمان می برد، اما بیشتر وبمسترها هرگز آن را انجام نداده اند.
دوم، تصمیم بگیرید که آیا پیاده سازی لایه «قابلیت» برای شما ارزش دارد یا خیر؟ اگر دلایلی وجود دارد که هوش مصنوعی در سایت شما کاری انجام دهد (مثل جستجو در انبار، بررسی قیمت ها، رزرو وقت، خرید یا ثبت مرجوعی کالا)، پس WebMCP استراتژی برنده ی شماست. (اشاره تخصصی: اگر سایت فروشگاهی یا خدماتی دارید، تیم دیجیتال مارکتینگ و توسعه دانش وب می تواند در طراحی رابط های API اختصاصی برای این منظور به شما کمک کند). اما اگر سایت شما صرفاً یک وبلاگ محتوایی است که فقط خوانده می شود، لایه قابلیت می تواند فعلاً صبر کند و تمرکز شما باید روی ارائه محتوای تمیزِ سمت سرور (Server-rendered) باشد.
چیزی که نباید انجام دهید این است که تصور کنید فایلی که افزونه شما به صورت پیش فرض ساخته، همان استراتژی هوش مصنوعی شماست. این فقط یک ادعای هویتی است که هنوز هیچ هوش مصنوعی بزرگی به آن اهمیت نمی دهد.
نتیجه گیری
استراتژی هویتی نمرده است، بلکه هنوز «اثبات نشده» است. اگر فردا یک سیستم بزرگ هوش مصنوعی اعلام کند که llms.txt را می خواند و به آن وزن می دهد، معادلات تغییر می کند. من دقیقاً منتظر چنین سیگنالی هستم، اما تا امروز (سپتامبر ۲۰۲۶) آن را ندیده ام.
از سوی دیگر، WebMCP هم سؤالات حل نشده خود را دارد. این هنوز یک پیش نویس است، نه یک استاندارد قطعی. تاکنون Gemini در مرورگر Chrome مصرف کننده اصلی آن بوده است و پشتیبانی از آن در سایر مرورگرها هنوز ضعیف است. هرچند مایکروسافت از نویسندگان این استاندارد است، اما در یادداشت های انتشارِ رسمی مرورگر Edge تا نسخه ۱۴۷ خبری از WebMCP نیست.
تا زمانی که نشانه های قطعی از راه برسند، نظر من کاملاً مشخص است: تا پایان سال ۲۰۲۶، این «قابلیت» است که اهمیت دارد و «هویت» تنها یک اقدام پیشگیرانه است. فایلی که امیدوار است خوانده شود، در برابر ابزاری که فراخوانی می شود، بازنده است. چرا؟ چون عامل های هوشمند بر اساس اینکه «آیا توانستند وظیفه کاربر را به پایان برسانند یا خیر» سنجیده می شوند، نه بر اساس اینکه تابلوی راهنمای سایت شما را چقدر خوب خوانده اند!