

فایل llms.txt سایت خود را بررسی کنید، دوره آزمایشی عمومی (Origin Trial) استاندارد WebMCP را بسنجید و سپس تصمیم بگیرید که وب سایت شما واقعاً به کدام شرط بندی نیاز دارد: هویت یا قابلیت؟
لایه پروتکل در وب ایجنتیک (Agentic Web – وب مبتنی بر ایجنت ها و عامل های خودمختار هوش مصنوعی) در حال دو تکه شدن و ورود به دو مسیر کاملاً مجزاست؛ و واقعیت این است که اکثر وب سایت ها همین حالا هم بدون آنکه خودشان بدانند، روی یکی از این دو مسیر شرط بسته اند!
- مسیر اول، شرط بندی روی «هویت (Identity)» است: فایلی به نام
llms.txtکه به مدل های هوش مصنوعی می گوید شما چه کسی هستید و محتوای شما چه موضوعاتی را پوشش می دهد. - مسیر دوم، شرط بندی روی «قابلیت (Capability)» است: یک استاندارد مرورگری جدید به نام WebMCP که به ایجنت هوش مصنوعی می گوید وقتی وارد سایت شما شد، دقیقاً چه کارهایی را می تواند به صورت عملی انجام دهد.
در نگاه اول، این دو مفهوم شبیه به هم به نظر می رسند، اما در واقعیت به دو پرسش کاملاً متضاد پاسخ می دهند. درک این تفاوت مشخص می کند که شما در سال آینده باید تمرکز و انرژی تیم سئو و توسعه فنی خود را روی کدام بخش بگذارید؛ زیرا یکی از این دو مسیر به صورت پیش فرض و خودکار برای شما فعال شده است، در حالی که مسیر دیگر — یعنی همان گزینه ای که به ایجنت اجازه می دهد یک کار یا تراکنش واقعی را در سایت به پایان برساند — نیازمند توسعه هدفمند و کار فنی آگاهانه است.
۲ فایل، ۲ پرسش بنیادین
زمانی که یک ایجنت هوش مصنوعی (مانند ایجنت های جستجوگر گوگل، چت جی پی تی یا جمینای) وارد وب سایت شما می شود، معمولاً دو سوال اصلی دارد:
- پرسش اول: این وب سایت چیست و چه موضوعاتی را پوشش می دهد؟
- پرسش دوم: حالا که به اینجا رسیده ام، چگونه کاری را که کاربر انسانی به من محول کرده است به سرانجام برسانم؟
ابتدا «هویت»، سپس «قابلیت». وب ایجنتیک در حال ساخت دو پاسخ کاملاً مجزا برای این دو سوال است و این پاسخ ها از دو فایل و رویکرد متفاوت می آیند که توسط دو جبهه مختلف پشتیبانی می شوند:
- پاسخ به هویت: فایل
llms.txtیک فایل متنی ساده (Plain-text) که در ریشه دامین (Root) سایت شما قرار می گیرد. این فایل مانند یک نقشه دست چین شده عمل می کند: «من این برند هستم، این ها مهم ترین صفحات من هستند و این هم خلاصه موضوع هر صفحه.» - پاسخ به قابلیت: استاندارد
WebMCPیک استاندارد مرورگری پیشرفته که به سایت شما اجازه می دهد توابع و ابزارهای اجرایی (Callable Tools) را در اختیار ایجنت قرار دهد. بنابراین ایجنت هوش مصنوعی به جای حدس زدن روی رابط کاربری (UI)، کلیک تصادفی یا خواندن کدهای پیچیده HTML، با فراخوانی مستقیم یک تابع اقدام به جستجو، فیلتر محصولات، استعلام قیمت یا رزرو نهایی می کند.
متأسفانه این روزها llms.txt و WebMCP به اشتباه در یک دسته و تحت عنوان کلی «آمادگی برای هوش مصنوعی (Agent-Readiness)» قرار می گیرند. اما آن ها دو نیاز کاملاً متفاوت را برطرف می کنند:
هویت مانند یک «بروشور یا کاتالوگ تبلیغاتی» است؛ اما قابلیت، حکم «صندوق دریافت وجه» را دارد.
در حال حاضر جریان غالب صنعت وب، همه سایت ها را به سمت بروشور (یعنی گزینه ای با شواهد اثربخشی ضعیف تر) سوق می دهد، در حالی که صندوق فروشگاه — یعنی گزینه ای که فرآیند تبدیل و تراکنش واقعی را جلو می برد — تنها در اختیار تیم های معدودی قرار گرفته که حاضرند از نظر فنی آن را کدنویسی و پیاده سازی کنند.
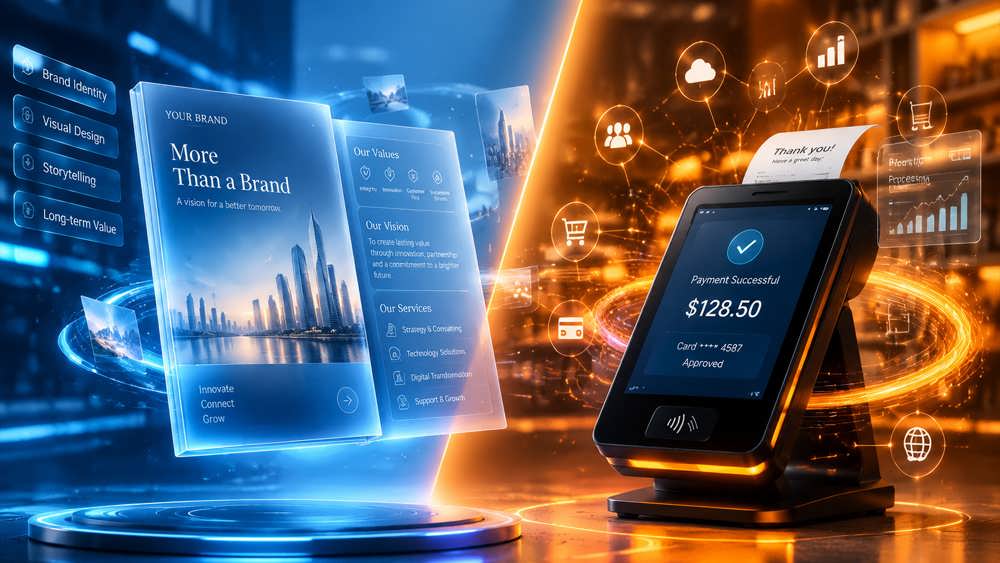
در دنیای هوش مصنوعی، فایل llms.txt حکم یک بروشور اطلاعاتی را دارد، در حالی که WebMCP مانند یک صندوق فروشگاه، تراکنش ها را نهایی می کند.
شرط بندی روی هویت: فایل LLMs.txt
فایل llms.txt یک فایل با فرمت مارک داون (Markdown) است که در آدرس yourdomain.com/llms.txt بارگذاری می شود. این فرمت نخستین بار در ۳ سپتامبر ۲۰۲۴ توسط جرمی هاوارد (Jeremy Howard)، هم بنیان گذار Answer.AI، پیشنهاد شد. ایده او این بود که به جای اینکه مدل های زبانی را وادار کنیم در کدهای درهم ریخته HTML، بنرهای تبلیغاتی، منوها و اسکریپت های سنگین بخزند و صفحه را بازسازی کنند، یک ایندکس تمیز و سازمان یافته توسط انسان در اختیارشان بگذاریم. این ادعا در ظاهر کاملاً منطقی به نظر می رسد: مدل ها با داده های ساختاریافته بهتر کار می کنند، پس بیایید ساختار مرتبی به آن ها بدهیم.
اما مشکل کجاست؟ شواهد اثربخشی آن بسیار ضعیف است.
در ژوئن ۲۰۲۶، جان مولر (John Mueller)، سخنگوی ارشد سرچ گوگل، در پاسخ به کاربران در ردیت صراحتاً فایل llms.txt را «در حال حاضر کاملاً حدس و گمان» خواند و گفت: (این فایل سال هاست وجود دارد، اما هیچ یک از سیستم های اصلی هوش مصنوعی از آن استفاده نمی کنند) (گزارش شده توسط Search Engine Journal). این اظهارنظر از سوی یک چهره رسمی سئو در گوگل، حقیقت پشت پرده را فاش کرد: فایلی که بیش از یک سال از سر و صدای آن می گذرد، هنوز توسط هیچ موتور هوش مصنوعی بزرگی رسماً تأیید نشده که خوانده شود، اما شما را وادار می کند نسخه دومی از محتوای سایت خود را مدام همگام سازی (Sync) و به روز نگه دارید.
با وجود این شواهد ضعیف، llms.txt به طور پیش فرض برای میلیون ها سایت فعال شده است. به عنوان مثال، افزونه محبوب AIOSEO که روی بیش از ۳ میلیون سایت وردپرسی نصب است، به صورت خودکار این فایل را می سازد. به این ترتیب، تعداد بسیار زیادی از صاحبان وب سایت ها اکنون فایلی را منتشر می کنند که هرگز خودشان تصمیمی برای انتشار آن نگرفته اند و سایتی را در آن توصیف کرده اند که خودشان یک بار هم متنش را نخوانده اند!
سوءبرداشت نشود؛ هدف نفی کامل این فایل نیست. یک فایل llms.txt که به خوبی مدیریت و به روزرسانی شود، ایندکس تمیزی از محتواست. مشکل اصلی «فعال سازی پیش فرض و کورکورانه» آن است. شرط بندی روی هویت در میزان نصب و پذیرش پیشتاز است، نه به خاطر اینکه واقعاً کار می کند، بلکه فقط به این دلیل که تیک یک افزونه به صورت پیش فرض فعال بوده است. داشتن فایلی که شما آن را ننوشته اید، هیچ هوش مصنوعی بزرگی خواندن آن را تأیید نکرده و به محض فراموش کردن از محتوای اصلی سایت عقب می افتد، استراتژی عجیبی برای وب ایجنتیک است.
شرط بندی روی قابلیت: استاندارد WebMCP
در سمت دیگر، WebMCP (مخفف Web Model Context Protocol) قرار دارد؛ یک استاندارد مرورگری پیشرفته که به وب سایت شما اجازه می دهد ابزارهای قابل فراخوانی را از طریق API اختصاصی navigator.modelContext ثبت کند.
نقطه شروع WebMCP کاملاً متفاوت است؛ مسئله این نیست که «شما که هستید؟»، بلکه این است: «حالا که ایجنت در سایت شماست، چگونه می تواند وظیفه اش را به بهترین و درست ترین شکل انجام دهد؟»
این رویکرد به دیدگاه جان مولر در همان گفت وگو بسیار نزدیک است. او اشاره کرد که رویکرد WebMCP و یکپارچه سازی های تجاری را ترجیح می دهد، زیرا «دارای اهداف و فرآیندهای شفاف و معین هستند».
در این حالت، به جای اینکه ایجنت مدام از صفحه اسکرین شات بگیرد و حدس بزند کجا باید کلیک کند، وب سایت مستقیماً به آن اعلام می کند:
- این عملیات ها در سایت من پشتیبانی می شوند؛
- هر عملیات چه ورودی هایی نیاز دارد؛
- و در پاسخ چه خروجی ساختاریافته ای دریافت خواهی کرد.
کنترل فرآیند وارونه می شود: سایت قابلیت هایش را اعلام می کند، نه اینکه ایجنت مجبور باشد با مهندسی معکوس رفتار سایت را حدس بزند.
این استاندارد در گروه W3C Web Machine Learning توسط مهندسان گوگل و مایکروسافت تدوین شده و پیش نویس آن در ۱۰ فوریه ۲۰۲۶ منتشر شد. هم اکنون این پروتکل در مرحله آزمایش عمومی (Origin Trial) در مرورگر کروم (از نسخه Chrome 149 تا Chrome 156) فعال است. دوره Origin Trial قابلیتی است که گوگل به سایت ها اجازه می دهد بدون نیاز به فعال سازی فلگ های پیچیده توسط کاربران، ویژگی های آزمایشی را روی ترافیک زنده و واقعی تست کنند. در حال حاضر، ایجنت اصلی که این توابع را در کروم مصرف می کند، Gemini است.
به همین دلیل WebMCP شرط بندی بسیار قوی تری است: چون وظیفه شفافی دارد. فایل هویت تنها خود را معرفی می کند و امیدوار است کسی آن را بخواند؛ اما ابزار قابلیت فراخوانی می شود، داده ساختاریافته برمی گرداند و کار کاربر را یک گام به اتمام نزدیک تر می کند. بروشور در انتظار خوانده شدن خاک می خورد، اما صندوق فروشگاه بلافاصله پول را جابه جا می کند.
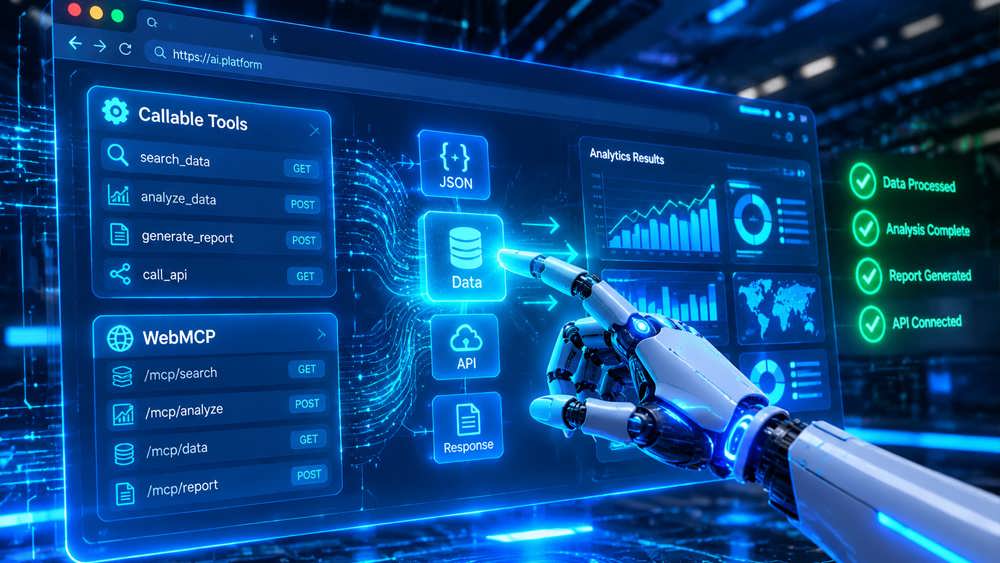
استاندارد WebMCP به ایجنت ها اجازه می دهد به جای حدس زدن رفتار سایت، مستقیماً ابزارهای کاربردی را فراخوانی کرده و خروجی ساختاریافته دریافت کنند.
چرا این دو رویکرد جایگزین یکدیگر نیستند؟
شفاف ترین راه برای تفکیک این دو، استفاده از مفهوم «معماری اولویت با ماشین (Machine-First Architecture)» است که بر دو اصل استوار است: هویت و تعامل.
- هویت (Identity): یعنی تبدیل برند و محتوا به قالبی که ماشین بدون ابهام بتواند آن را بفهمد.
- تعامل (Interaction): یعنی به ایجنت امکان دهید یک اکشن مشخص را با نتیجه ای دقیق و قابل پیش بینی انجام دهد.
فایل llms.txt در لایه هویت بازی می کند و WebMCP در لایه تعامل. هر وب سایتی بسته به هدف خود ممکن است به هر دو، یکی از آن ها، یا هیچ کدام نیاز نداشته باشد.
اما اهمیت این موضوع زمانی دوچندان می شود که بدانیم ترافیک ایجنت ها دیگر یک عدد ناچیز در آمار وب سایت ها نیست. متیو پرینس (Matthew Prince)، مدیرعامل کلودفلر، در ژوئن ۲۰۲۶ اعلام کرد که ترافیک خودکار ربات ها و ایجنت ها برای نخستین بار از ترافیک انسانی پیشی گرفته است (۵۷.۳٪ در برابر ۴۲.۷٪)؛ رخدادی تاریخی که او پیش تر پیش بینی کرده بود تا سال ۲۰۲۷ اتفاق نخواهد افتاد.
وقتی بیش از نیمی از درخواست های ورودی به سایت شما ماشین هایی هستند که از طرف کاربران انسانی اقدام می کنند، دانستن اینکه شما که هستید دیگر بخش جذاب ماجرا نیست! سوال حیاتی این است: آیا ایجنت توانست کاری را که کاربر خواسته بود انجام دهد؟
هویت بدون قابلیت، شبیه به ماشینی است که تابلو و سردرِ مغازه شما را خوانده، اما پشت دری قفل شده ایستاده که کلیدی برای باز کردنش ندارد.
پیاده سازی عملی: تجربه اجرای هر دو شرط بندی روی یک سایت واقعی
من هر دوی این راهکارها را روی وب سایت خودم (No Hacks) پیاده کرده ام و تفاوت هزینه و ارزش هرکدام، کل این بحث را خلاصه می کند:
- برای هویت: یک فایل
llms.txtنگهداری می کنم؛ اما به جای اینکه آن را به افزونه ها بسپارم، با هر بار به روزرسانی سایت، آن را مستقیماً و به صورت خودکار از محتوای واقعی دیتابیس سایت تولید می کنم. به این ترتیب، محتوا همیشه هماهنگ است و اگر روزی هوش مصنوعی رسماً تصمیم به خواندن آن گرفت، من آماده ام. این فقط یک پیش گیری ارزان قیمت است، نه کل استراتژی من. - برای قابلیت: پروتکل
WebMCPرا پیاده سازی کرده ام. وقتی مرورگری با قابلیت WebMCP سایت را باز می کند، ۴ ابزار فراخوانی از طریقnavigator.modelContextثبت می شوند:- ۲ ابزار برای بخش واژه نامه (Glossary): یکی فهرست تمام اصطلاحات را برای کشف ایجنت لیست می کند و دیگری تعریف رسمی هر اصطلاح را با لینک منبع برمی گرداند.
- ۲ ابزار برای بررسی وضعیت محصولات و مرورگرهای ایجنتیک: یکی محصولات را بر اساس دسته بندی لیست می کند و دیگری جزئیات دقیق یک محصول خاص را ارائه می دهد.
ایجنت هوش مصنوعی برای درک تعاریف سایت من، نیازی به کراول کردن کل صفحات ندارد؛ تنها یک تابع مشخص را صدا می زند و پاسخی ساختاریافته دریافت می کند. نکته کلیدی اینجاست که این ابزارها مستقیماً از همان منبع داده ای (Single Source of Truth) می خوانند که به کاربران انسانی نمایش داده می شود. بنابراین خروجی هوش مصنوعی و خروجی انسان هرگز مغایرت نخواهد داشت.
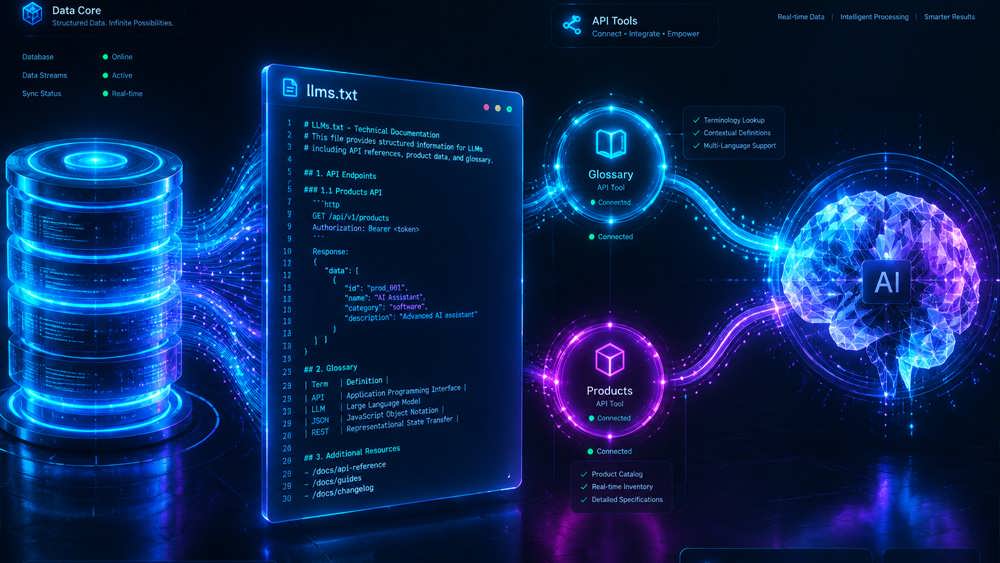
یک استراتژی موفق شامل تولید خودکار فایل هویت از دیتابیس و هم زمان ایجاد ابزارهای تعاملی برای دسترسی ایجنت ها به محصولات و واژه نامه است.
این موضوع چه معنایی برای وب سایت شما دارد؟
(اگر به عنوان مدیر کسب وکار یا متخصص سئو می خواهید سایت خود را برای نسل جدید وب آماده کنید، این دو مرحله را دنبال کنید:)
۱. ابتدا ببینید در حال حاضر چه چیزی منتشر کرده اید
آدرس yourdomain.com/llms.txt را در مرورگر باز کنید. اگر فایلی لود شد، سیستم مدیریت محتوا یا افزونه های سئوی شما آن را بدون اطلاع شما ایجاد کرده اند. آن را بخوانید و بررسی کنید که آیا واقعاً معرف محتوای سایت شماست؟ اگر یک مدل هوش مصنوعی این فایل را بخواند و اطلاعات نادرست دریافت کند، داشتن یک فایل ناقص و غلط بسیار بدتر از نداشتن آن است. اگر می خواهید آن را حفظ کنید، فرآیندی بچینید که از دیتابیس محتوای اصلی تولید شود تا دچار ناهمگامی نگردد.
۲. بررسی کنید که آیا به لایه قابلیت (WebMCP) نیاز دارید یا خیر
اگر ایجنت ها در وب سایت شما دلیلی برای انجام کار دارند — مانند جستجو در انبار محصولات، استعلام آنلاین قیمت، شروع فرآیند رزرو، پیگیری سفارش یا مرجوعی کالا — در این صورت WebMCP همان گزینه ای است که بازدهی تجاری دارد. به لطف دوره آزمایشی کروم، می توانید همین امروز آن را برای ترافیک واقعی پیاده سازی کنید. اما اگر سایت شما صرفاً ماهیت محتوایی و مقاله ای دارد، لایه قابلیت می تواند منتظر بماند و اولویت اصلی شما باید تولید محتوای تمیز و بهینه سازی رندر سمت سرور (SSR) باشد.
تیم های تخصصی در حوزه تکنیکال، همانند کارشناسان طراحی سایت و سئو در دانش وب، همواره تاکید دارند که آمادگی فنی برای نسل بعدی وب به معنای نصب کورکورانه افزونه ها نیست؛ بلکه باید معماری دیتامحور و ساختار کدهای سایت را متناسب با نیاز ایجنت ها و کاربران بهینه سازی کرد.
هرگز تصور نکنید فایلی که یک افزونه به صورت خودکار ساخته، همان «استراتژی هوش مصنوعی» شماست!
مسائلی که هنوز مبهم و در حال تغییر هستند
باید با عدم قطعیت های این مسیر صادق باشیم:
- شرط بندی روی هویت (llms.txt) نمرده، بلکه هنوز اثبات نشده است. اگر فردا گوگل، OpenAI یا آنتروپیک رسماً اعلام کنند که این فایل را معیار رتبه بندی یا استناد قرار می دهند، معادلات تغییر می کند.
- استاندارد WebMCP نیز سوالات بی پاسخ خود را دارد. این استاندارد هنوز یک پیش نویس در گروه W3C است و به استاندارد نهایی تبدیل نشده است. در حال حاضر جمینای در کروم مصرف کننده اصلی آن است. پشتیبانی در سایر مرورگرها مانند مایکروسافت اج (Edge) هنوز در نسخه رسمی ۱۴۷ به صورت پیش فرض دیده نشده و باید منتظر ماند.
با وجود پیشتازی لایه قابلیت، استانداردهای وب ایجنتیک هنوز در مرحله پیش نویس هستند و استراتژی های سئو باید انعطاف پذیر باقی بمانند.
نتیجه گیری
تا زمانی که نشانه های جدیدی ظاهر شوند، نتیجه گیری و برنده میدان مشخص است: قابلیت برنده اصلی وب ایجنتیک است و هویت صرفاً نقش یک بیمه حمایتی را دارد. فایلی که تنها امیدوار است خوانده شود، در برابر ابزاری که مستقیماً اجرا می شود و تسک کاربر را تکمیل می کند، شکست خواهد خورد؛ زیرا موفقیت ایجنت های هوش مصنوعی بر اساس این سنجیده می شود که آیا توانستند کار کاربر را به سرانجام برسانند یا خیر، نه اینکه صرفاً تابلوی ورودی سایت شما را خوانده باشند. فایل هویت خود را دقیق و هماهنگ با محتوا نگه دارید، اما سرمایه گذاری واقعی را روی ایجاد قابلیت های عملیاتی و تعاملی در سایت متمرکز کنید.