

بسیاری از برندها، دیده شدن در نتایج جستجوی هوش مصنوعی (AI Search) را صرفاً یک مشکل «تولید محتوا» می دانند. اما واقعیت چیز دیگری است! شما نمی توانید اطلاعات غلط یا تاریخ گذشته ای که در مدل های زبانی بزرگ (LLMs) وجود دارد را صرفاً با انتشار مقالات معتبرتر، اضافه کردن بخش سوالات متداول (FAQ)، نگارش مقالات مقایسه ای یا توضیح احساسیِ دوباره محصولاتتان برطرف کنید.
در بسیاری از مواقعی که اطلاعات یک برند در هوش مصنوعی قدیمی یا اشتباه است، مشکل از «کمبود داده» نیست؛ بلکه مشکل اصلی «حجم بیش از حد داده ها» است. در واقع، برند شما نسخه های متفاوتی از حقیقت را در سطح وب منتشر کرده است و نسخه ای که بیشترین تطابق را با سوال کاربر دارد، لزوماً جدیدترین و درست ترین نسخه نیست!
وب سایت شما یک چیز می گوید، اما یک فایل PDF قدیمی چیز دیگری را نشان می دهد. مستندات محصول از اصطلاحاتی استفاده می کنند که تیم مارکتینگ دو سال پیش آن ها را کنار گذاشته است. در صفحه «درباره ما»، بیوگرافی مدیران با عناوین شغلی ای گره خورده که دیگر در چارت سازمانی وجود ندارند. صفحات مربوط به شرکای تجاری، ویژگی هایی از خدمات شما را توصیف می کنند که مدت هاست تغییر کرده اند.
برخی از این اطلاعات از اساس غلط هستند؛ اما برخی دیگر در زمان انتشار کاملاً درست بوده اند، منتها مربوط به سه سال پیش هستند و دیگر وضعیت فعلی کسب وکار شما را توصیف نمی کنند.
در سئوی سنتی، موتورهای جستجو می توانستند چندین صفحه مختلف را هم زمان رتبه بندی کنند و تصمیم گیری درباره اینکه کدام صفحه به روزتر است را بر عهده خود کاربر بگذارند. اما امروزه، موتورهای جستجوی مبتنی بر هوش مصنوعی منابع را استخراج کرده و از آن ها برای تولید «یک پاسخ واحد» استفاده می کنند. این پاسخ به گونه ای قاطعانه ارائه می شود که گویی هیچ شکی در آن نیست، حتی اگر شواهد و منابع زیربنایی آن پر از تناقض باشند.
بنابراین، این فقط یک مشکل محتوایی ساده نیست؛ بلکه یک بحران در سیستم بازیابی اطلاعات (Retrieval) و حاکمیت محتوا (Content Governance) است که با روی کار آمدن هوش مصنوعی، مستقیماً به یک چالش جدی در سئو (SEO) تبدیل شده است.
پرامپت (دستور کاربر) تعیین می کند کدام نسخه از حقیقت بازیابی شود
زمانی که شخصی از یک مدل زبانی (LLM) سوالی می پرسد، پرامپت (Prompt) یا همان دستور متنی کاربر، چارچوب و بخش عمده ای از کلمات کلیدی مورد نیاز برای یافتن اطلاعات را مشخص می کند. سیستم ممکن است سوال را کمی بازنویسی کند یا چند جستجوی مرتبط انجام دهد، اما در نهایت تلاش می کند دقیقاً به همان سوالی که پرسیده شده پاسخ دهد.
این موضوع زمانی دردسرساز می شود که سوال کاربر حاوی پیش فرضی است که خود او نمی داند منسوخ شده است. به عنوان مثال، اگر کاربری بپرسد: «مدیرعامل شرکت [X] کیست؟»، پیش فرض او این است که این شرکت هنوز سِمتی به نام «مدیرعامل» دارد. کاربر آنقدر اطلاعات ندارد که بپرسد «چه کسی در حال حاضر رهبری برند را بر عهده دارد؟»، یا «آیا تیم رهبری به شرکت مادر منتقل شده است؟» و حتی نمی داند جایگزین فعلیِ سمت مدیرعامل در این شرکت چه نام دارد.
یک جستجو که حول محور نام شرکت و کلمه «مدیرعامل» شکل گرفته باشد، طبیعتاً صفحاتی را بالا می آورد که دقیقاً همین ارتباط کلمه ای را در خود دارند. بیوگرافی های قدیمی، اخبار روابط عمومی (رپورتاژها)، مصاحبه ها، پروفایل های مربوط به همایش ها و اخبار ادغام شرکت، همگی ممکن است نام مدیرعامل سابق را یدک بکشند.
از طرفی، صفحه فعلی «تیم رهبری» در سایت شما ممکن است از ادبیات متفاوتی استفاده کند که اصلاً با کلمه «مدیرعامل» همخوانی ندارد. اطلاعات جدید ممکن است از عناوینی مثل «مدیر کل»، «رئیس برند»، «معاون ارشد برند» یا عناوین دیگری استفاده کند که کاربر اصلاً از آن ها خبر نداشته تا در جستجوی خود لحاظ کند.
اگر منابعی که ساختار جدید سازمان شما را توضیح می دهند، به طور واضح و مستقیم این تغییر را به اصطلاحات قدیمی ربط ندهند، ممکن است هرگز وارد دایره نتایج بازیابی شده توسط هوش مصنوعی نشوند. و فراموش نکنید: هوش مصنوعی نمی تواند به منبعی که آن را پیدا نکرده، استناد کند!
نتیجه این می شود که اطلاعات قدیمی برنده بازی می شوند، چون تطابق زبانیِ بیشتری با سوال کاربر دارند؛ اما واقعیتِ امروزِ کسب وکار شما چون با ادبیات سوال همخوانی ندارد، نادیده گرفته می شود.
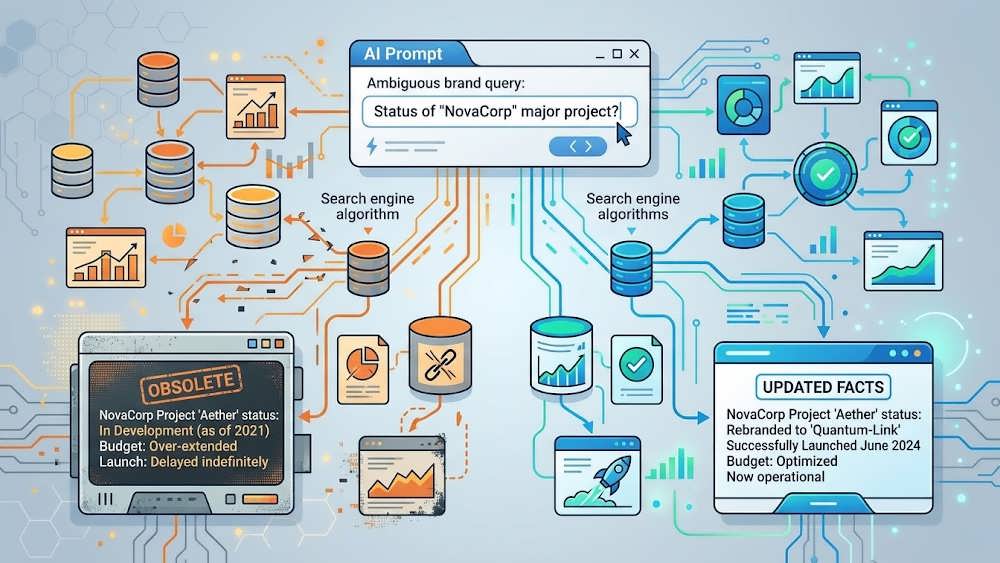
نمایش مفهومی نحوه پردازش دستورات متنی کاربر توسط مدل های زبانی بزرگ (LLM) و تطابق زبانی داده های قدیمی با سوالات کاربران.
یک مثال واقعی از شرکتی که نامش فاش نخواهد شد
من این اتفاق را در دنیای واقعی دیده ام. در یک مورد، اگر از هوش مصنوعی می پرسیدید که مدیرعامل فعلی فلان شرکت چه کسی است (تاکید روی «است»، نه «بود»)، نام یکی از چهار مدیر ارشد سابق را به شما می داد. هیچ کدام از این پاسخ ها توهم یا ساختگی نبودند. تمام آن افراد در مقطعی این سمت را بر عهده داشتند و شرکت مورد نظر و هلدینگ مادر آن هنوز صفحاتی تاریخی و معتبر داشتند که این نقش ها را تایید می کرد.
اما ساختار سازمانی فعلی از ادبیات کاملاً متفاوتی استفاده می کرد. صفحه معرفی تیم در وب سایت شرکت، رهبر ارشد جدید را با عنوان «معاون ارشد و مدیر کل» (SVP & GM) معرفی کرده بود، در حالی که در صفحه «تاریخچه»، از یک تیم رهبری گسترده تر (که شامل مدیران ارشد مهندسی و محصول بود) صحبت می شد. صفحات هلدینگ مادر نیز مدیرانی را معرفی می کرد که مسئولیت کل گروه تجاری (که این شرکت زیرمجموعه آن بود) را بر عهده داشتند. هیچ کدام از این حقایقِ جدید به گونه ای نوشته نشده بودند که بتوانند پاسخی برای سوال «مدیرعامل شرکت [X] کیست؟» باشند.
سوابق عمومی منتشر شده در وب نیز کاملاً متناقض بودند. پروفایل مدیر فعلی با عنوان «معاون ارشد و مدیر کل» شروع می شد، اما در متن معرفی برخی از صفحات دیگر سایت، به اشتباه هنوز به عنوان «مدیرعامل» خطاب شده بود. از طرفی، صفحه تاریخچه شرکت به درستی نام مدیران عامل قبلی و دوره فعالیت آن ها را حفظ کرده بود.
بنابراین، کاربری که این سوال بدیهی را می پرسید، سیستم را وادار می کرد تا به سراغ ادعاهای قدیمی برود که کلمه «مدیرعامل» در آن ها واضح بود، در حالی که مدیر فعلی با اصطلاحات دیگری معرفی شده بود.
شاید این موضوع پیچیده به نظر برسد و صادقانه بگویم، واقعاً هم پیچیده است. اگر درک این موضوع برای انسان ها دشوار است، شک نکنید که فهمیدن آن برای هوش مصنوعی تقریباً غیرممکن است. به همین دلیل است که حل این مشکل، چیزی فراتر از ویرایش ساده صفحه «درباره ما» است. (در طراحی سایت های شرکتی توسط دانش وب، معماری اطلاعات به گونه ای پایه ریزی می شود که از بروز چنین گره های کوری در آینده جلوگیری شود).
خودِ پرامپت (سوال کاربر) حاوی یک مدل سازمانی منسوخ است. تا زمانی که یک منبع جدید، پُلی میان «سوال قدیمی» و «ساختار جدید» نسازد، موتور جستجوی هوش مصنوعی مدام کلمات قدیمی و افراد مرتبط با آن کلمات را بازیابی خواهد کرد.
اطلاعات جدید باید پاسخگوی سوالات قدیمی باشند
چگونه باید این سوابق را اصلاح کنیم؟ واکنش غریزی اکثر افراد این است که یک صفحه «تیم رهبری» جدید منتشر کنند و امیدوار باشند که این اصلاحیه راه خود را به پاسخ های هوش مصنوعی باز کند. بله، گاهی اوقات این کار کمک می کند، اما «انتشار دادن» به معنای «اصلاح کردن» نیست. اطلاعات دقیقی که با کلمات و اصطلاحات اشتباه نوشته شده باشند، در برابر سوالات واقعیِ کاربران نامرئی باقی می مانند.
برندها به «محتوای واسط» (Bridge Content) نیاز دارند؛ محتوایی که ادبیات منسوخ گذشته را به واقعیت امروز متصل کند.
در مثال تیم رهبری، جمله ای که باید برای اصلاح سوابق منتشر کنید صرفاً این نیست که: «سارا احمدی، معاون ارشد و مدیر کل است.» بلکه باید بنویسید:
«پس از ادغام شرکت، برند [X] دیگر سمت مستقلی به نام مدیرعامل ندارد. در حال حاضر، سارا احمدی به عنوان معاون ارشد و مدیر کل، زیر نظر [هلدینگ مادر] رهبری برند [X] را بر عهده دارد.»
این جمله دقیقاً کاربر (و هوش مصنوعی) را در همان نقطه ای که سوءتفاهم آغاز شده، راهنمایی می کند. این جمله:
- به نقش قدیمی اشاره می کند.
- دلیل اینکه چرا آن نقش دیگر وجود ندارد را توضیح می دهد.
- و جایگزین فعلی آن را نام می برد.
این تکنیک به سیستم های بازیابی هوش مصنوعی (و موتورهای جستجو) منبعی می دهد که هم شامل کلمه کلیدی قدیمی (مثل مدیرعامل) است و هم از نسبت دادن غلطِ این عنوان به افراد دیگر جلوگیری می کند. این اصل طلایی سئو، در تمام موارد مشابه کاربرد دارد: زمانی که نام یک محصول تغییر می کند، زمانی که یک خدمت متوقف می شود، وقتی شرکت ها ادغام می شوند، گواهینامه ها منقضی می شوند، مناطق خدمات دهی تغییر می کنند یا ویژگی های یک محصول به پکیج های دیگری منتقل می شوند.
هرگز تصور نکنید که کاربران نام جدید را به قدری خوب می شناسند که آن را جستجو کنند. شما باید ارتباط میان «اصطلاحی که هنوز در زبان مردم می چرخد» و «واقعیتی که جایگزین آن شده» را به صورت شفاف منتشر کنید.
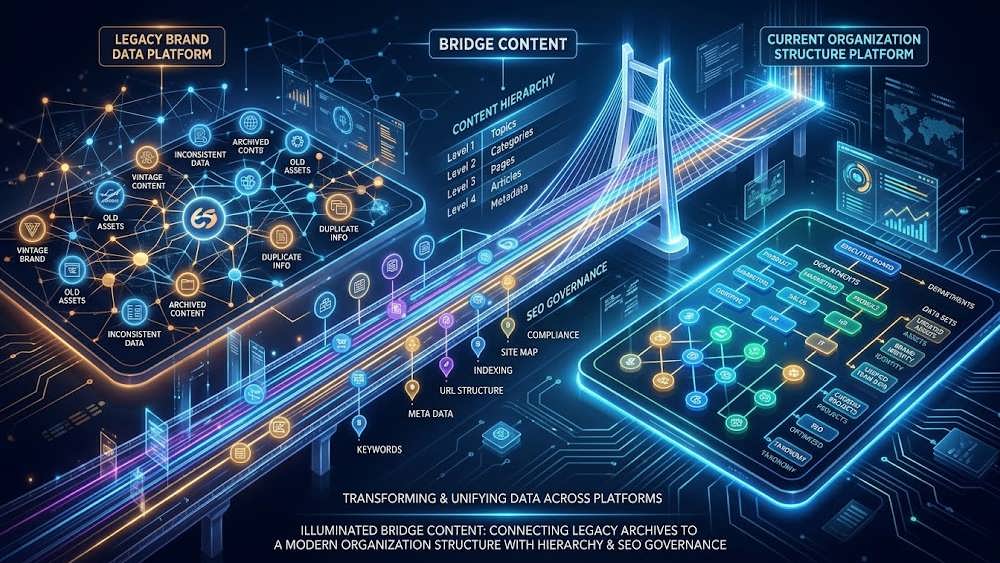
تصویرسازی استعاری از «محتوای واسط» که اصطلاحات منسوخ شده گذشته را به واقعیت فعلی کسب وکار و سیستم های بازیابی هوش مصنوعی متصل می کند.
زنجیره شواهد را اصلاح کنید، نه فقط جدیدترین صفحه را
به محض اینکه متوجه شدید هوش مصنوعی پاسخ غلطی درباره برند شما می دهد، باید آن را از طریق استنادها و نتایج جستجویی که آن پاسخ را تایید می کنند، ردیابی کنید. هدف شما باید پیدا کردن «زنجیره شواهدی» باشد که آن پاسخ را تولید کرده اند، نه اینکه صرفاً سعی کنید آن اطلاعات را زیر خروارها صفحه جدید دفن کنید!
صفحات متعلق به خودتان (Owned Media) را می توانید به روزرسانی، ادغام یا ریدایرکت (Redirect 301) کنید، و یا توضیحاتی به آن ها بیفزایید. نیازی نیست یک خبر قدیمی را طوری بازنویسی کنید که انگار تاریخ جور دیگری رقم خورده است؛ بلکه می توانید یک تاریخ دقیق، یک برچسب وضعیت (مثل: بایگانی شده) یا یک لینک به اطلاعات جدید و فعلی (Canonical یا لینک داخلی) در آن قرار دهید.
بیوگرافی های فعلی نباید در متون مقدماتی خود عناوین شغلی منسوخ را نگه دارند. پروفایل ها و دایرکتوری های فعالِ شرکا باید اصلاح شوند. فایل های PDF کاتالوگ ها و بروشورهای فروشی که دیگر نماینده کسب وکار شما نیستند باید از روی سایت حذف شوند یا برچسب «بایگانی / Archive» بخورند.
اما در مورد رسانه های شخص ثالث (مثل خبرگزاری ها) باید هوشمندانه تر عمل کنید. شما نمی توانید از یک رسانه خبری بخواهید مقاله دقیقِ پنج سال پیش خود را تغییر دهد فقط به این دلیل که سازمان شما امروز تغییر کرده است! اما می توانید توضیح جامع و قطعی (Canonical) خودتان را در سایتتان به قدری در دسترس و سئو شده قرار دهید که پیدا کردن آن آسان باشد. همچنین می توانید از شرکای تجاری، سایت های دایرکتوری و پلتفرم هایی که موظف به نمایش اطلاعات فعلی شما هستند بخواهید تا سوابق شما را در دیتابیس خود آپدیت کنند.
گاهی اوقات قوی ترین استراتژی تولید محتوا و دیجیتال مارکتینگ این است که: محتواهای قدیمی ای که فراموش کرده اید منتشر کرده اید را اصلاح کنید!
ممیزی دیده شدن برند کافی نیست؛ شما به «ممیزی ادعای برند» نیاز دارید
یک بررسی و موجودی گیری سنتی محتوا، معمولاً شامل لیست کردن URLها، عناوین، ترافیک، رتبه ها و احتمالاً نرخ تبدیل است. اما در دنیای هوش مصنوعی، شما به ممیزی ادعای برند (Brand Claim Audit) نیاز دارید. این یعنی باید بررسی کنید که دارایی های محتوایی شما چه «حقایق و ادعاهایی» را مطرح می کنند. در سئوی هوش مصنوعی، این ممیزی باید ادبیاتی که مردم هنگام پرسیدن درباره آن حقایق استفاده می کنند را نیز ثبت کند. (انجام این نوع ممیزی عمیق محتوایی، یکی از خدمات تخصصی دانش وب برای برندهایی است که به دنبال استیلای دیجیتال و سئوی پایدار هستند).
برای هر ادعا یا فکت مهم درباره برندتان، موارد زیر را مستند کنید:
- سوال یا پرامپتی که احتمال دارد کاربر استفاده کند.
- هرگونه پیش فرض منسوخ شده ای که در آن سوال نهفته است.
- اصطلاحات قدیمی و معادل های فعلی آن ها.
- حقیقتِ تاییدشده فعلی و منبع مرجعِ عمومی آن (لینک صفحه اصلی روی سایت شما).
- سایر دارایی های متعلق به شما (صفحات وب، PDFها، بیوگرافی ها، فایل های فید محصول و…) که نسخه های قدیمی در آن ها دیده می شود.
- منابعی که در حال حاضر توسط هوش مصنوعی برای ارائه پاسخ های غلط استناد می شوند.
- اقدام مورد نیاز: به روزرسانی، حاشیه نویسی، ادغام، ریدایرکت، بایگانی کردن یا ساخت محتوای واسط (Bridge Content).
- تیم مسئول: چه کسی وظیفه نگهداری از این اطلاعات و بازبینی آن ها در صورت تغییر شرایط را بر عهده دارد؟
این ممیزی را صرفاً به صفحات HTML (لینک های سایت) محدود نکنید. مدیا کیت ها، فایل های پرزنتیشن فروش، مقالات مرکز آموزش (Help Center)، کدهای اسکیما (Schema Markups)، فید محصولات، توضیحات اپلیکیشن در مارکت ها (مثل بازار یا گوگل پلی)، بیوگرافی سخنرانان سمینارها، آگهی های استخدامی و ساب دامین های قدیمی را زیر و رو کنید. از تیم های فروش، پشتیبانی، منابع انسانی، محصول، حقوقی و روابط عمومی بپرسید که چه محتواهایی را بدون هماهنگی با تیم سایت منتشر می کنند.
هدف این نیست که همه جملات در همه جا دقیقاً مثل هم باشند. مخاطبان مختلف به سطوح متفاوتی از جزئیات نیاز دارند. اما «حقایق زیربنایی» باید به یک پاسخ واحد ختم شوند و زبانی که مردم هنوز از آن استفاده می کنند، باید آن ها را به سمت «توضیحات فعلی» هدایت کند، نه اینکه سیستم های بازیابی هوش مصنوعی را در تله ی گذشته گیر بیندازد.
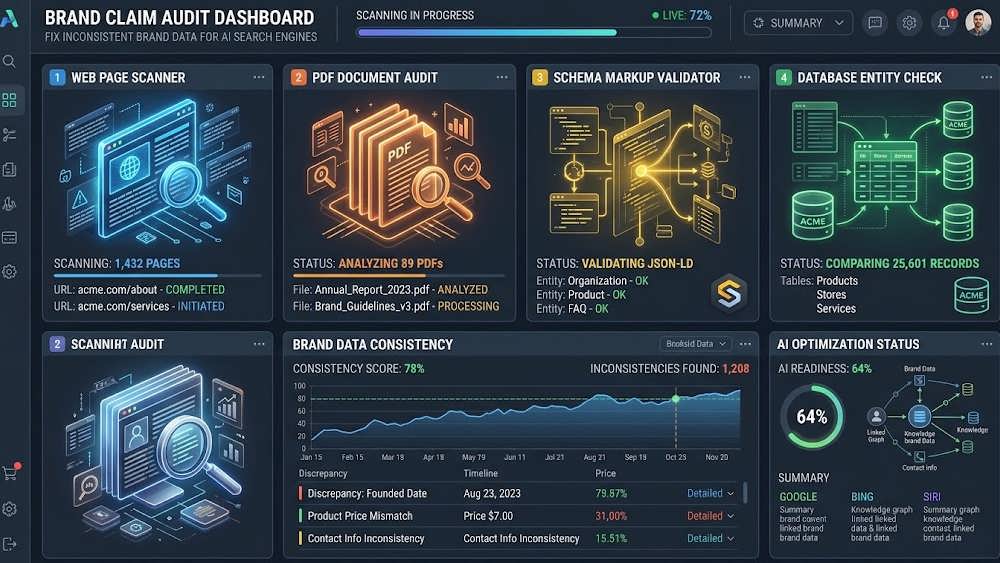
نمایی از داشبورد بررسی و ممیزی عمیق محتوا، فایل های PDF، اسکیما و سوابق عمومی جهت اصلاح زنجیره شواهد و حقایق برند.
نتیجه گیری
گزارش های دیده شدن در هوش مصنوعی (AI Visibility Reports) معمولاً روی این موضوع تمرکز دارند که آیا برند شما در پاسخ به یک سری پرامپت ها ذکر شده (Mention)، استناد شده یا در لیست قرار گرفته است یا خیر. این آمارها مفید هستند، اما «صرفاً حضور داشتن» می تواند اعتماد به نفس کاذب ایجاد کند.
برای پرامپت ها و کلمات کلیدیِ پرارزشِ خود، خودِ پاسخ تولید شده را ارزیابی کنید. آیا دقیق است؟ آیا به روز است؟ آیا به نیت واقعی کاربر (User Intent) پاسخ می دهد، یا صرفاً همان پیش فرض غلطی که در سوال کاربر بوده را تایید می کند؟ وقتی پاسخ غلط است، منابع استناد شده را بررسی کنید و قبل از اینکه فورا مدل هوش مصنوعی را به «توهم زدن» متهم کنید، جستجوهای احتمالی را خودتان شبیه سازی کنید تا ببینید سیستم چطور به این نتیجه رسیده است.
اگر هوش مصنوعی نام برند شما را بیاورد اما از مدیرعامل قبلی شما نام ببرد، قیمت های قدیمی را به کاربر نشان دهد، ویژگی حذف شده ای را به محصول فعلی شما نسبت دهد یا رابطه برند شما با هلدینگ مادرتان را اشتباه متوجه شود، این «منشن شدن» یک پیروزی محسوب نمی شود!
شما نمی توانید تک تک جملاتی که در سطح اینترنت درباره برندتان منتشر می شود را کنترل کنید، و نمی توانید تضمین کنید که سیستم هوش مصنوعی همیشه پاسخ دلخواه شما را تولید کند. اما شما می توانید مطمئن شوید سوالاتی که مردم واقعاً می پرسند، یک مسیر روشن و سئو شده به سمت حقیقت فعلی برند شما دارند.
این کار شاید باعث نشود در پایان ماه نموداری زیبا از «انتشار ۲۰۰ مقاله جدید توسط تیم محتوا» روی میز مدیران بگذارید؛ اما باعث می شود درک برند شما برای موتورهای جستجو، سیستم های هوش مصنوعی، مشتریان، روزنامه نگاران و حتی کارمندان خودتان بسیار آسان تر شود. در عصرِ جستجوی هوش مصنوعی، این «شفافیت اطلاعات»، معنای واقعیِ دیده شدن است.