

حقایق پنهان جستجوی مبتنی بر هوش مصنوعی را با یافته های جذابِ حاصل از ۱۵ میلیون نقطه داده کشف کنید. یاد بگیرید که چه چیزی واقعاً روی رتبه بندی ها تأثیر می گذارد.
ما در Ahrefs روی بیش از ۵۰ پژوهش و مطالعه تخصصی در حوزه هوش مصنوعی (AI) کار کرده ایم.
تقریباً هدفِ شکل گیریِ تک تک این مطالعات، راستی آزمایی ادعاهایی بود که توسط افراد مختلف در صنعت سئو (یا حتی خود گوگل) با کمترین شواهد و مدارک تکرار می شدند.
آنچه در ادامه می خوانید، چکیده ای از جالب ترین چیزهایی است که آموخته ایم و افسانه هایی است که با بررسی ۱۵ میلیون نقطه داده (Data Point) از مطالعات اخیرِ جستجوی هوش مصنوعی، آن ها را در هم شکسته ایم.
حقایق جستجوی هوش مصنوعی که ما کشف کردیم
- دیده شدن در هوش مصنوعی: مقالات لیستی «بهترین ها» بیشتر به رقبای شما کمک می کنند تا خودتان!
- فایل llms.txt: هیچ کس فایل llms.txt شما را نمی خواند (۹۷٪ آن ها حتی یک بار هم فراخوانی نمی شوند).
- اسکیما (Schema): افزودن کدهای اسکیما میانبری برای استناد هوش مصنوعی به شما نیست.
- جایگاه در نتایج (SERP): رتبه گرفتن در جستجوی کلاسیک، همچنان راز اصلی استناد ChatGPT به سایت شماست.
- رتبه یک: رتبه اول بودن در صفحه اول گوگل، حضور شما در هوش مصنوعی را تضمین نمی کند.
۱. مقالات لیستی «بهترین ها» بیشتر به رقبای شما کمک می کنند تا خودتان!
❌ افسانه رد شده: «یک مقاله لیستی از ‘بهترین ها’ بنویس، برندت را در آن قرار بده و هوش مصنوعی تو را پیشنهاد خواهد داد.»
هیچ چیز برای ChatGPT جذاب تر از لیست های پیشنهادی «بهترین ها» نیست. گلن آلسوپ (Glen Allsopp) با بررسی ۷۵۰ پرامپت (دستور) در ChatGPT متوجه شد که مقالات وبلاگیِ «بهترین فلان چیز» (مانند: “۱۰ تا از بهترین ابزارهای سئو”) به طور میانگین ۴۳.۸۳٪ از کل صفحاتی را تشکیل می دهند که هوش مصنوعی در کوئری های مربوط به نرم افزار، آژانس ها و محصولات به آن ها استناد کرده است.
جای تعجب ندارد که بسیاری از شرکت های B2B اکنون لیست های خودشان را می نویسند و خود را در رتبه اول قرار می دهند؛ اما باید بدانید که استناد کردن (Citation) به معنای پیشنهاد دادن (Recommendation) نیست.
📊 داده ها چه می گویند؟
همکار من، ماتئوش ماکوسیویچ، یک آزمایش کنترل شده انجام داد. او ۳۴ مقاله لیستیِ «خودتبلیغی» را در ۵ دامنه مختلف منتشر کرد و ۹۸۸۶ پاسخ را در پلتفرم های ChatGPT، Gemini، Perplexity و Copilot زیر نظر گرفت. او دقیقاً همان چیزی را تایید کرد که متخصصان سئو مانند لیلی ری (Lily Ray) به آن مشکوک بودند: هوش مصنوعی از مقاله شما به عنوان منبع اطلاعاتی خود استفاده می کند، اما در پاسخ خود اصلاً نامی از برند شما نمی آورد و حتی ممکن است رقیبتان را پروموت کند!
برای مثال، در ابزار Brand Radar ما مشاهده شد که برند Attio یک مقاله لیستی برای «بهترین CRMها» نوشته و خود را در رتبه ۱ و رقیبش HubSpot را در رتبه ۲ قرار داده است. اما در کمال تعجب، در پاسخ ChatGPT، برند HubSpot به عنوان پیشنهاد شماره ۱ و Attio به عنوان پیشنهاد دوم معرفی شد! یعنی Attio ناخواسته به رقیب خود کمک کرد تا رتبه بهتری در هوش مصنوعی بگیرد.
در نمونه ای دیگر، ماتئوش یک مقاله لیستی برای تبلیغ کنفرانس خودمان (Ahrefs Evolve) نوشت. نتایج نشان داد که در ۴۳٪ از پاسخ ها، هوش مصنوعی رویدادِ رقیب ما را به جای رویداد ما پیشنهاد داد.
بنابراین، انتشار یک پست «بهترین ها» و قرار دادن نام خودتان در صدر آن، برای دیده شدن در هوش مصنوعی کافی نیست.
💡 به جای آن چه کنیم؟
ریپورتاژ آگهی، ارتباطات عمومی، کمپین های اینفلوئنسری و مهندسیِ تبلیغات دهان به دهان (مانند تسلط بر موضوعی که می خواهید برندتان با آن مترادف شود) می تواند باعث شود نام برند شما در ده ها منبع مستقل و معتبر ذکر شود. این دقیقاً همان چیزی است که هوش مصنوعی در درازمدت آن را به عنوان «اعتبار» می شناسد. اما یک مقاله خودنوشته ی «بهترین ها» هرگز چنین اعتباری برایتان نمی آورد.
نمودار مقایسه ای حجم بازدیدکنندگان هدایت شده از سمت موتور جستجوی گوگل در برابر ارجاعات ChatGPT.
۲. هیچ چیز فایل llms.txt شما را نمی خواند (۹۷٪ فراخوانیِ صفر دارند!)
(توضیح تکمیلی: فایل llms.txt فایلی مشابه robots.txt است که اخیراً برای راهنمایی خزنده های هوش مصنوعی (LLMs) در روت سایت ها قرار می گیرد).
❌ افسانه رد شده: «برای دیده شدن در هوش مصنوعی حتماً به فایل llms.txt نیاز دارید.»
در ماه مِی ۲۰۲۶، گوگل توصیه متناقضی به ما کرد: به ما گفت که باید فایل های llms.txt خود را بررسی و ممیزی کنیم، در حالی که همزمان ادعا کرد این فایل ها برای دیده شدن در هوش مصنوعی الزامی نیستند! ما تصمیم گرفتیم خودمان داده ها را بررسی کنیم.
📊 داده ها چه می گویند؟
ما لاگ سرورها و ترافیک ربات های ۱۳۷,۰۰۰ سایت را با استفاده از ابزارهای تحلیل وب و تحلیل رباتِ Ahrefs بررسی کردیم.
در مجموع، ۳۸ هزار سایت (۲۸٪) فایل llms.txt را منتشر کرده بودند، اما آمار خیره کننده ای نشان داد که ۹۷٪ از این فایل ها هرگز خوانده نشده بودند! نه توسط ربات ها و نه توسط انسان ها.
از میان آن ۳٪ که خوانده شده بودند نیز، ۷۷٪ اصلاً ربات های هوش مصنوعی نبودند! بیشتر آن ها ابزارهای بررسی سئو، پلتفرم های GEO (بهینه سازی موتورهای جستجوی تولیدی) و ابزارهایی بودند که صرفاً برای بررسیِ میزان استقبال از ساخت فایل های llms.txt طراحی شده بودند!
این یک چرخه باطل است: سئوکاران فایل های llms.txt را می نویسند که فقط توسط ابزارهای خودشان (که برای مطالعه این فایل ها ساخته شده اند) خوانده می شود.
💡 به جای آن چه کنیم؟
فایل llms.txt را نادیده بگیرید. انرژی خود را صرف این کنید که محتوای فعلی سایتتان به راحتی قابل خزش (Crawl)، تجزیه و استناد باشد. (ما در تیم طراحی سایت دانش وب، معماری و کدنویسی سایت ها را از ابتدا به گونه ای پیاده سازی می کنیم که ساختار اطلاعاتی برای تمامی ربات های جستجوگر و هوش مصنوعی کاملاً شفاف و بهینه سازی شده باشد).
۳. افزودن کدهای اسکیما (Schema) میانبری برای استناد هوش مصنوعی نیست
❌ افسانه رد شده: «اضافه کردن اسکیما مارک آپ به یک صفحه، بلافاصله استنادهای هوش مصنوعی به شما را افزایش می دهد.»
اخیراً ترندی شکل گرفته که در آن «متخصصان ادعاییِ سئوی هوش مصنوعی (GEO)»، رشدهای سریع در هوش مصنوعی را به بهینه سازی اسکیما ربط می دهند.
📊 داده ها چه می گویند؟
ما این ادعا را به بوته آزمایش سپردیم. ۱۸۸۵ صفحه ای که کدهای اسکیما (JSON-LD) به آن ها اضافه شده بود را در برابر ۴۰۰۰ صفحه کنترل (بدون تغییر) قرار دادیم و تغییرات استناد به آن ها را قبل و بعد از این کار بررسی کردیم.
پس از ۳۰ روز، هیچ رشد معناداری در Google AI Mode یا ChatGPT مشاهده نکردیم. (رشد ChatGPT تنها ۲.۲٪ و Google AI Mode تنها ۲.۴٪ بود). در بخش AI Overviews گوگل حتی شاهد افت واقعی ۴.۶ درصدی بودیم! البته نمی توانستیم این افت را مستقیماً به اسکیما ربط دهیم، زیرا روند نزولیِ هر دو گروه (صفحات تست و کنترل) از قبل آغاز شده بود.
پایگاه های داده ای مانند Wikidata و گراف دانش گوگل (Knowledge Graph) سال هاست که از داده های اسکیما تغذیه می کنند. اینکه آیا این ساختار واقعاً نحوه درک مدل های هوش مصنوعی از موجودیت ها (Entities) را شکل می دهد یا خیر، هنوز یک سوال بی پاسخ است. اما اگر هم اسکیما درک هوش مصنوعی را تقویت کند، این کار از طریق مسیر کُند و غیرمستقیمِ گراف دانش انجام می شود، نه به عنوان یک تکنیک میانبر.
💡 به جای آن چه کنیم؟
از اسکیما برای ساخت ارتباطات بلندمدتِ موجودیت ها استفاده کنید. داده های Organization (سازمان) و Person (شخص) را با لینک های sameAs به ویکی پدیا، ویکی دیتا و کرانچ بیس متصل کنید؛ زیرا یک موجودیتِ خوب تعریف شده، چیزی است که گراف دانش گوگل را تغذیه می کند و یک گراف دانشِ واضح تر، شانس بیشتری برای شکل دادن به درک هوش مصنوعی از برند شما دارد.
یک کارشناس در حال ممیزی کدهای سورس و لاگ های سرور سایت در یک محیط مدرن.
۴. رتبه گرفتن در جستجوی کلاسیک، همچنان کلید اصلی استناد در ChatGPT است
❌ افسانه رد شده: «برای حضور در نتایج هوش مصنوعی، نیازی به رتبه داشتن در جستجوی کلاسیک گوگل ندارید.»
امروزه بیشتر ما می دانیم که پلتفرم های هوش مصنوعی از طریق تکنولوژی RAG (تولید افزوده شده با بازیابی)، صفحات را از جستجوی سنتی استخراج می کنند. اما رتبه بندی جستجو دقیقاً چقدر در این استنادها نقش دارد؟ ما ۱.۴ میلیون پرامپت ChatGPT را برای یافتن پاسخ بررسی کردیم.
📊 داده ها چه می گویند؟
ما هر URL بازیابی شده را بر اساس نوع منبع (ref_type) دسته بندی کردیم و متوجه شدیم که ۸۸.۴۶٪ از تمام استنادها (بیش از ۲۵.۵ میلیون داده) از ایندکس جستجوی عمومی می آیند؛ یعنی همان رتبه بندی های جستجوی کلاسیکِ قدیمی و آشنای خودمان!
بخش اخبار ۱۲.۰۱٪، ردیت ۱.۹۳٪، یوتیوب ۰.۵۱٪ و مقالات آکادمیک ۰.۴۰٪ را به خود اختصاص دادند. کانال های تخصصی مثل ردیت و یوتیوب در مقیاس وسیع استخراج می شوند، اما به ندرت در پاسخ نهایی به آن ها استناد می شود.
بنابراین، داشتن رتبه خوب در جستجوی کلاسیک، همچنان سنگین ترین وزنه در تصمیم گیری های ChatGPT برای معرفی منابع است.
💡 به جای آن چه کنیم؟
روی کارهای سئوی کلاسیک که برایتان رتبه می آورند سرمایه گذاری کنید:
- هدف گذاری کلمات کلیدی مناسب.
- پاسخگویی دقیق به قصد کاربر (Search Intent).
- رفع مشکلات تکنیکال که مانع رشد صفحات می شوند.
(در دپارتمان سئوی دانش وب نیز همواره به کارفرمایان یادآوری می کنیم که فونداسیونِ حضور موفق در عصر هوش مصنوعی، داشتن یک سئوی تکنیکال و محتواییِ قدرتمند در بستر کلاسیک است).
۵. رتبه یک بودن، دیده شدن در هوش مصنوعی را تضمین نمی کند!
❌ افسانه رد شده: «اگر در صفحه اول نتایج جستجو رتبه داشته باشید، شانس بیشتری برای معرفی شدن در هوش مصنوعی دارید.»
فرض کردن اینکه رتبه صفحه اول به شما شانس فوق العاده ای برای دیده شدن در هوش مصنوعی می دهد، بسیار وسوسه کننده است. اما داده های ما چیز دیگری می گویند.
📊 داده ها چه می گویند؟
ما ۸۶۳ هزار صفحه نتایج (SERP) و ۴ میلیون استناد را تجزیه و تحلیل کردیم. متوجه شدیم که تنها حدود ۳۸٪ از URLهایی که در AI Overviews (نتایج هوش مصنوعی گوگل) استناد شده بودند، در بین ۱۰ نتیجه برتر همان کوئری حضور داشتند (این رقم در سال قبل حدود ۷۶٪ بود).
مابقی صفحاتِ استناد شده (۳۱.۲٪) رتبه های بین ۱۱ تا ۱۰۰ داشتند و ۳۱٪ دیگر اصلاً در ۱۰۰ نتیجه اول حضور نداشتند!
دلیل چیست؟ گوگل تاکید بسیار بیشتری روی تکنیکِ «بسط پرس و جو» (Query Fan-out) گذاشته است. در این تکنیک، گوگل به جای اینکه فقط پرامپت اصلی کاربر را مبنا قرار دهد، منابع را از جستجوهای مرتبطِ پیرامونِ آن پرامپت بیرون می کشد. بنابراین رتبه بندی مهم است، اما نه لزوماً برای آن کلمه کلیدیِ مستقیمی که شما انتظار دارید.
💡 به جای آن چه کنیم؟
پوشش موضوعیِ (Topical Coverage) خود را در خوشه ای از کوئری های مرتبط گسترش دهید، نه فقط برای یک کلمه کلیدیِ هدف. به این ترتیب در جستجوهای بسط یافته و فرعی نیز دیده خواهید شد.
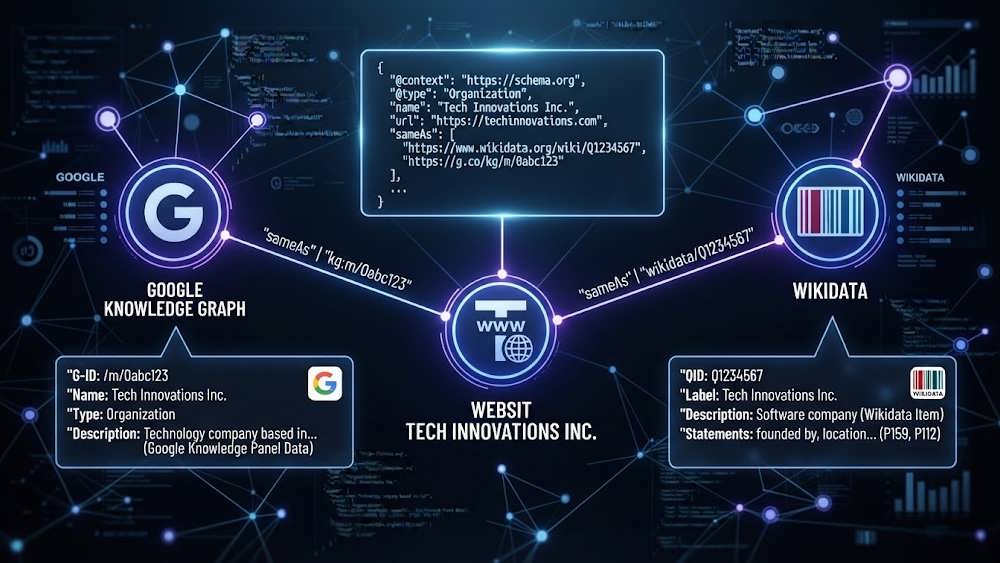
نمایش نحوه اتصال کدهای JSON-LD اسکیما به پایگاه داده گراف دانش گوگل و ویکی دیتا.
۶. هوش مصنوعی منابع را بر هم می زند، اما نظرش را تغییر نمی دهد
❌ افسانه رد شده: «پاسخ های هوش مصنوعی آنقدر نوسان دارند که ردیابیِ آن ها کار بیهوده ای است.»
برخی از سئوکاران با توجه به غیرقابل پیش بینی بودن پاسخ های AI، معتقدند که ردیابی جایگاه در هوش مصنوعی ارزش وقت گذاشتن ندارد. بله، ظاهر پاسخ های هوش مصنوعی مدام تغییر می کند، اما اصل ماجرا چیز دیگری است.
📊 داده ها چه می گویند؟
ما ۴۳,۰۰۰ کلمه کلیدی را به مدت یک ماه زیر نظر گرفتیم و AI Overview هر کدام را بیش از ۱۶ بار بررسی کردیم. نتایج نشان داد که در ۷۰٪ مواقع جمله بندی ها تغییر می کردند، در ۴۶٪ مواقع برندهای معرفی شده جابه جا می شدند و در ۴۵.۵٪ مواقع منابع استناد شده تغییر می یافتند.
اما هسته اصلیِ پاسخ به سختی تغییر می کرد! وقتی ما «معنی و مفهوم» را به جای جمله بندی مقایسه کردیم، نمره شباهت و پایداری محتوایی هوش مصنوعی ۰.۹۵ از ۱ بود!
این یعنی گوگل تصمیم خود را درباره اینکه «پاسخ درست چیست» گرفته است، فقط مدام در حال تغییر منابع و بازنویسی جملات برای بیان همان پاسخ است.
💡 به جای آن چه کنیم؟
اگر بتوانید در «مفهوم و موضوع» پیروز شوید (نه فقط در یک عبارت دقیق)، با ثبات بیشتری دیده خواهید شد. دیده شدن خود در هوش مصنوعی را بر اساس «موضوع و لحن (Sentiment)» در طول زمان پیگیری کنید، زیرا نویزهای ظاهری گاهی سیگنال های پایدارِ زیرین را پنهان می کنند.
۷. هوش مصنوعی جستجو را نکشته است؛ گوگل ۱۹۰ برابر ترافیک بیشتری می فرستد
❌ افسانه رد شده: «گوگل مرده است. جستجوی هوش مصنوعی جایگزین آن شده است.»
هر سال، سئوکاران از نوشتن آگهی ترحیم برای گوگل لذت می برند! این یک سرگرمی قدیمی است که با رشد هوش مصنوعی دوباره بر سر زبان ها افتاده است. اما گوگل همیشه زنده می ماند تا داستان را روایت کند و طبق داده های ما، این رویه تا سال های طولانی ادامه خواهد داشت.
📊 داده ها چه می گویند؟
پاتریک استوکس کشف کرد که اگر استفاده های غیرجستجویی مانند کمک به کدنویسی یا ترجمه را از ChatGPT حذف کنیم، این ابزار تنها معادل ۱۲٪ از حجم جستجوهای سنتیِ گوگل را در اختیار دارد.
با مطالعه ۷۶,۰۰۰ سایتی که به ابزار وب آنالیتیکس Ahrefs متصل بودند متوجه شدیم که گوگل ۱۹۰ برابر بیشتر از ChatGPT ترافیک ارسال می کند! سهم گوگل از هدایت ترافیک وب سایت ها نزدیک به ۴۰٪ (دقیقاً ۳۹.۹۸٪) است، در حالی که سهم ChatGPT تنها ۰.۲۱٪، پرپلکسیتی ۰.۰۲٪ و جمینای ۰.۰۱٪ است.
هوش مصنوعی گوگل را نکشته است، فقط در حال جنگیدن برای گرفتن سهم کوچکی از آن است.
💡 به جای آن چه کنیم؟
همچنان ترافیک گوگل را در اولویت استراتژی خود قرار دهید. این موتور جستجو هنوز هم با اختلاف بسیار زیاد، بزرگترین کانال ترافیک شماست (حتی در شرایطی که دارید روی دیده شدن در هوش مصنوعی نیز کار می کنید).
نمودارهای پایش افت کلیک و تاثیر AI Overviews بر ترافیک ارگانیک سایت در یک پنل مدیریت.
۸. مرورهای هوش مصنوعی (AIO) بیش از نیمی از کلیک های شما (۵۸٪) را می بلعند!
❌ افسانه رد شده: «حضور در AI Overview باعث افزایش کلیک های شما می شود.»
در مِی ۲۰۲۴، لیز رید (مدیر جستجوی گوگل) پستی منتشر کرد و ادعا کرد: «لینک هایی که در AI Overviews قرار می گیرند، کلیک بیشتری نسبت به زمانی که همان صفحه در لیست وب سنتی ظاهر می شود، دریافت می کنند.»
این ادعا با تجربه واقعیِ فعالان این صنعت همخوانی نداشت، بنابراین رایان لاو تصمیم گرفت ادعای گوگل را تست کند.
📊 داده ها چه می گویند؟
او در اوایل سال ۲۰۲۵ تاثیر AI Overviews بر نرخ کلیک (CTR) را بررسی کرد و متوجه شد که این ویژگی، کلیکِ محتواهای دارای رتبه برتر را ۳۴.۵٪ کاهش داده است.
سپس در سال ۲۰۲۶، زمانی که احساس کرد تاثیر منفیِ AIO بدتر شده، مطالعه خود را روی ۳۰۰,۰۰۰ کلمه کلیدی تکرار کرد. نتیجه شوکه کننده بود: حضور AI Overview، نرخ کلیک رتبه ۱ نتایج جستجو را ۵۸٪ کاهش داده بود! (افت از ۰.۰۳۷ به ۰.۰۱۶).
این یافته ی تلخ توسط آژانس های معتبر دیگر مانند Seer Interactive (افت بیش از ۶۵.۲٪)، Kevin Indig (افت بیش از ۵۰٪) و Authoritas (افت ۴۷.۵٪) نیز تایید شد.
💡 به جای آن چه کنیم؟
منابع ترافیک خود را متنوع کنید و افت واقعیِ کلیک های خود را مستقیماً پیگیری نمایید. ادعاهای روابط عمومی گوگل را چشم بسته باور نکنید!
۹. برای دیده شدن در هوش مصنوعی، منشن های برند از بک لینک ها مهم ترند
❌ افسانه رد شده: «بک لینک ها و اتوریتی دامنه (DR) محرک های اصلیِ دیده شدن در هوش مصنوعی هستند.»
ترک عادت موجب مرض است! بسیاری از سئوکاران تصور می کنند چون بک لینک و قدرت دامنه (DR) در جستجوی سنتی عالی جواب می دهند، پس مهم ترین فاکتورها برای هوش مصنوعی هم هستند.
📊 داده ها چه می گویند؟
ما ۷۵,۰۰۰ برند را مطالعه کردیم و مجموعه ای از معیارها را در مقابل میزان اشاره به نام برند (Brand Mentions) در پاسخ های ChatGPT، AI Mode و AI Overviews قرار دادیم.
در کمال تعجب، DR همبستگی بسیار ضعیفی با منشن شدن در پاسخ های هوش مصنوعی داشت (۰.۲۶۶ تا ۰.۳۲۶) و تعداد بک لینک ها نیز تاثیر ناچیزی نشان داد (۰.۱۹۱ تا ۰.۲۴۴).
اما آنچه همبستگی بسیار قدرتمندی داشت چه بود؟ اشاره به نام برند در یوتیوب (YouTube mentions) با امتیاز بالای ۰.۷۳۷ بالاتر از هر فاکتور دیگری قرار گرفت! و در رتبه بعدی، اشاره متنی به نام برند در سطح وب (Branded web mentions) با امتیاز ۰.۶۵۶ تا ۰.۷۰۹ قرار داشت.
لینک ها، اتوریتی (اعتبار) شما را برای گوگل می سازند؛ اما برای هوش مصنوعی، آنچه اهمیت دارد این است که آیا انسان های واقعی در سطح وب و رسانه هایی مانند یوتیوب درباره شما حرف می زنند یا خیر.
💡 به جای آن چه کنیم؟
دریافت منشن برند (Brand Mentions) در پوشش های خبری و انجمن ها را در اولویت قرار دهید. همچنین از طریق راه اندازی کانال اختصاصی، همکاری با تولیدکنندگان محتوا یا اسپانسرینگ، حضور پررنگی در رسانه های ویدیویی داشته باشید. (ما در دانش وب در بخش تدوین استراتژی های جامع دیجیتال مارکتینگ، روی ایجاد روابط عمومی دیجیتال و منشن های واقعی برند تمرکز ویژه ای داریم، چرا که ارزش آن در عصر هوش مصنوعی غیرقابل انکار است).
کارشناسان بهینه سازی وب سایت در حال بررسی رتبه بندی ها و داده های رقابتی در محیط کار.
نتیجه گیری
با مطالعه حدود ۱۵ میلیون نقطه داده، ما چیزهای زیادی درباره جستجوی هوش مصنوعی یاد گرفتیم؛ از جمله اینکه چه چیزی واقعاً کار می کند، گوگل ادعا می کند چه چیزی کار می کند، و چه چیزی صرفاً سروصدای توخالی در لینکدین است!
شاید با خواندن این مقاله به این نتیجه برسید که موفقیت در جستجوی هوش مصنوعی نیازمند کار طاقت فرسا با بازدهی کم است. اما واقعیت این است که تاکتیک هایی که در عصر هوش مصنوعی با شکست مواجه می شوند، عمدتاً همان «میانبرها» (مانند اضافه کردن عجولانه کدهای اسکیما یا نوشتن لیست های دروغینِ بهترین ها) هستند.
آنچه واقعاً جواب می دهد، همان استراتژی های آشنا اما کُندتر است: رتبه گرفتن اصولی در گوگل، کسب منشن های واقعی از برند، ایجاد پوشش جامع و خوشه ایِ موضوعات، و ساختن برندی که مردم واقعاً درباره آن صحبت کنند. هوش مصنوعی پدیده ای غیرقابل شناخت نیست، اما قطعاً به تکنیک های فریبنده و میانبر (Hacks) آلرژی دارد. در بازار وب فارسی نیز پیروزی از آنِ کسب وکارهایی است که روی برندسازیِ واقعی و ارائه محتوای جامع سرمایه گذاری می کنند.