

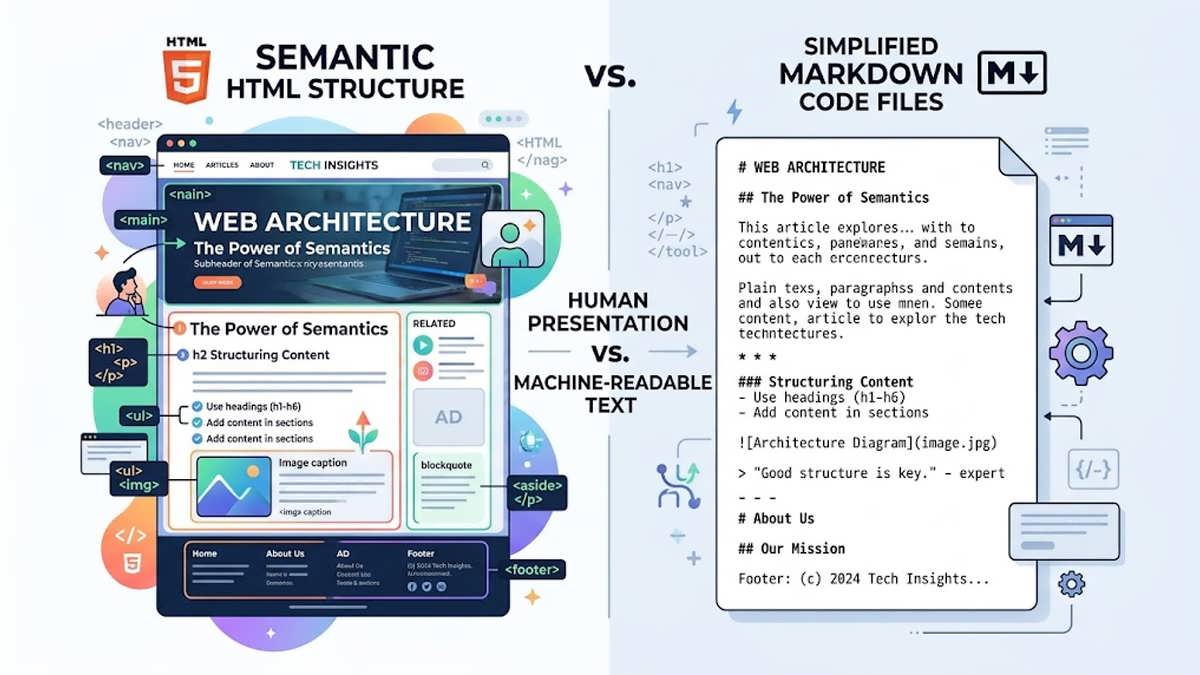
چند هفته گذشته در دنیای وب حسابی پر سروصدا بود. ابتدا گوگل چیزی به نام «فرمت دانش باز» یا OKF (Open Knowledge Format) را منتشر کرد. سپس تیم توسعه دهندگان گوگل (Google Developers) استاندارد جدیدی به نام «کشف منابع مبتنی بر عامل» یا ARD (Agentic Resource Discovery) را معرفی کردند.
در همین حال، اگر سری به فید لینکدین متخصصان سئو بزنید، می بینید که پر شده از افرادی که یا مارک داون (Markdown) را آینده وب می دانند، یا در حال توضیح این موضوع هستند که چرا باید تمام این اخبار را نادیده بگیرید.
اما مثل همیشه، حقیقت در نقطه ای بسیار جذاب تر از نظرات این دو گروه افراطی قرار دارد.
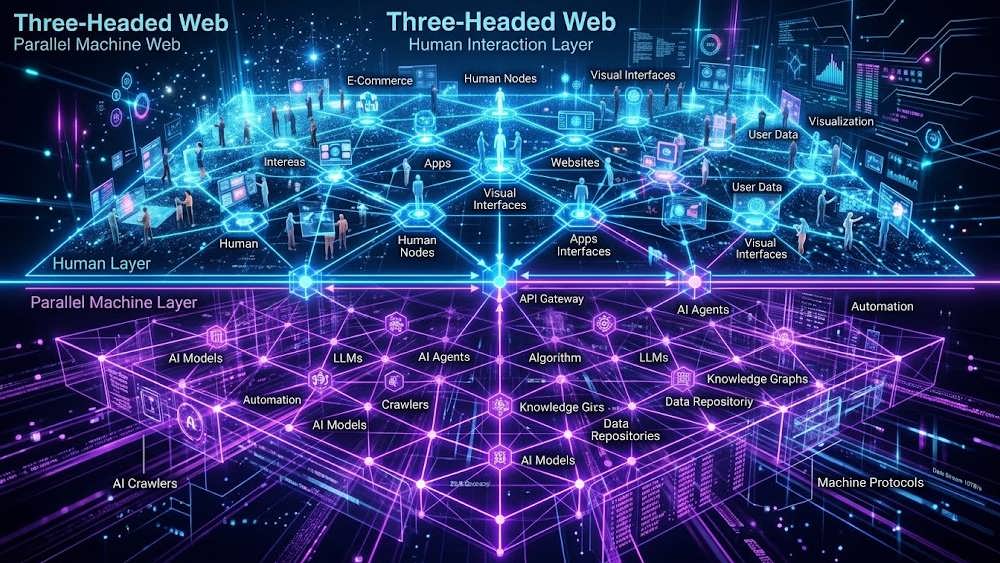
وب در حال توسعه یک زیرساخت موازی و قابل خواندن برای ماشین هاست (شامل MCP/WebMCP، OKF، ARD، LLMs.txt و…). آن دسته از متخصصان سئو که به جای استفاده از واژه کلیشه ای «سئوی هوش مصنوعی (AI SEO)» یا دیدن این ابزارها به عنوان یک چوب جادو، واقعاً درک کنند که هر لایه چه وظیفه ای دارد، تصمیمات بهتری برای صرف زمان و انرژی خود خواهند گرفت. همان طور که ما در آژانس دانش وب همواره به مشتریانمان یادآوری می کنیم، داشتن یک استراتژی دیجیتال مارکتینگ موفق نیازمند درک عمیق زیرساخت هاست، نه فقط دنبال کردن ترندهای زودگذر.
اول از همه: کیک چند لایه وب
حداقل شش مفهوم متمایز وجود دارد که همگی زیر چتر «آماده سازی سایت برای هوش مصنوعی» مورد بحث قرار می گیرند. این مفاهیم در لایه های مختلفی قرار دارند و اهداف متفاوتی را دنبال می کنند:
- صفحات HTML قابل خزش (Crawlable HTML Pages): این بخش همچنان فونداسیون و پایه کار است. هیچ چیز در اینجا تغییر نکرده و تمام لایه های دیگر روی این پایه بنا می شوند. طراحی سایت استاندارد دقیقاً از همین نقطه شروع می شود.
- اسکیما و داده های ساختاریافته (Schema.org/Structured Data): سرنخ های معنایی که درون کدهای HTML تعبیه می شوند و به طور واضح به ماشین ها می گویند که صفحه درباره چیست. در واقع، این یک نوع دایره لغات تخصصی برای موتورهای جستجو است.
- فایل LLMs.txt: اساساً یک فایل ناوبری و مسیریابی است. هدف این فایل این است که به یک عامل هوش مصنوعی (AI agent) که از قبل وارد سایت شما شده، بگوید کدام صفحات اهمیت بیشتری دارند. همان طور که جان مولر (John Mueller) در پادکست Search Off the Record می گوید: «اگر کسی (یا سیستمی) از قبل در وب سایت شما حضور دارد، شاید یک سیستم خودکار بتواند به او کمک کند. مثلاً اگر کاربر بگوید “من می خواهم به سایت مارتین اسپلیت بروم و یک عکس بخرم”، سیستم هوش مصنوعی (LLM) می تواند وارد وب سایت شما شود و بگردد که فرآیند خرید عکس چگونه است. شاید مارتین راهنمایی هایی برای من به عنوان یک عامل هوشمند (Agent) برای خرید عکس نوشته باشد. این منطقی به نظر می رسد.»
- پروتکل های MCP/WebMCP: قبل از اینکه ARD وارد بازی شود، ما با راهکار دیگری برای چالش تعامل پذیری مواجه بودیم. MCP در ساده ترین تعریف، یک روش استاندارد برای اتصال هوش مصنوعی به خدمات شما جهت استخراج دانش یا انجام یک اقدام خاص است. WebMCP، همان طور که از نامش پیداست، به وب سایت ها این امکان را می دهد تا به طور مستقیم با این عوامل هوشمند تعامل داشته باشند. (WebMCP برای تعاملات زنده مرورگر در یک صفحه وب است، در حالی که MCP برای ابزارها و خدمات خارج از صفحه کاربرد دارد.)
- فرمت دانش باز (OKF): مجموعه ای از فایل های مارک داون (Markdown) که دارای ساختار فراداده ای به نام YAML frontmatter هستند.
- کشف منابع مبتنی بر عامل (ARD): یک استاندارد باز جدید که نشان می دهد عوامل هوشمند (Agents) چگونه ابزارها، مهارت ها و سایر عوامل را در سراسر وب پیدا و تأیید می کنند. در اینجا تمرکز روی محتوای شما نیست، بلکه روی «قابلیت ها و توانمندی های» شماست.
برای سایت های فروشگاهی، لایه دیگری هم وجود دارد که باید به طور جداگانه به آن اشاره کرد: فید محصول (Product Feed) که احتمالاً آینده ی کشف محصولات در خرده فروشی ها خواهد بود.
هر کدام از این لایه ها کار متفاوتی انجام می دهند. من می توانستم این لیست را همچنان ادامه دهم؛ چرا که هر پنج دقیقه یک لایه جدید ظاهر می شود! اما همین جا متوقف می شوم تا موضوع بیش از حد پیچیده نشود.
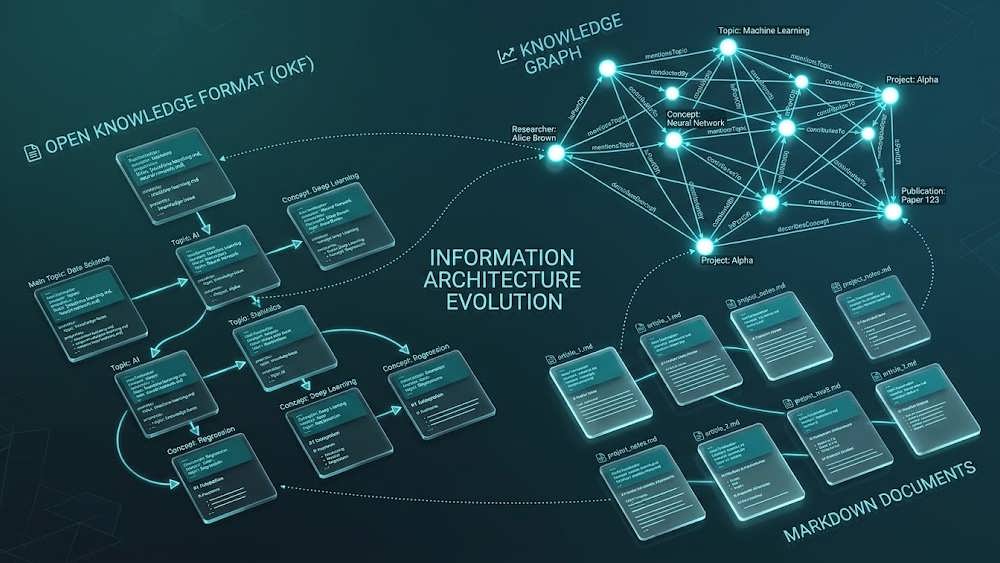
اینفوگرافیک کیک چند لایه زیرساخت هوش مصنوعی وب
فرمت OKF واقعاً چیست (و چه چیزی نیست)
گوگل استاندارد OKF را در سکوت خبری و به عنوان بخشی از ری برندینگ پلتفرم Dataplex به Knowledge Catalog منتشر کرد.
خود این فرمت به طرز غافلگیرکننده ای ساده است: یک دایرکتوری از فایل های مارک داون که هر کدام دارای یک هدر کوچک YAML هستند و نوع، عنوان، توضیحات، منبع و برخی برچسب ها (تگ ها) را مشخص می کنند. این فایل ها مانند هر سند مارک داون دیگری به یکدیگر لینک می دهند. همین و بس!
همان طور که در وبلاگ خود گوگل آمده است، OKF «فقط مارک داون، فقط فایل و فقط YAML frontmatter است.»
سوگانثان موهاناداسان (Suganthan Mohanadasan)، متخصص سئو، تحلیل روشنی از این موضوع دارد. او OKF را به عنوان یک طبقه از یک ساختمان چندطبقه توصیف می کند که اکنون شامل sitemap.xml (کدام URLها وجود دارند)، LLMs.txt (کدام صفحات را بیشتر دوست دارید خوانده شوند) و OKF (خود کتابخانه) است. این لایه ها روی هم قرار می گیرند و با هم رقابت نمی کنند.
سردرگمی زمانی به وجود می آید که نه به چیستیِ OKF، بلکه به کاری که انجام می دهد و جایگاه آن در هیاهوی جستجو و عوامل هوش مصنوعی نگاه می کنیم.
به اعتقاد من، OKF یک سیستم بازیابی (Retrieval System) نیست. این فرمت جایگزین خزش (Crawling) موتورهای جستجو نمی شود. من شخصاً آینده ای را نمی بینم که در آن سیستم های هوش مصنوعی دیگر حجم عظیمی از کدهای HTML را پردازش نکنند، یا جستجو و فرآیند RAG (تولید محتوای افزوده شده با بازیابی) به یک پایپ لاین چندمرحله ای و پیچیده متشکل از سیگنال های خودگزارش دهی و سیگنال های اثبات نشده تبدیل نشود.
توهم میانبر: OKF و واقعیت سئو
هر سیستم خودگزارش دهی (Self-reported) می تواند و حتماً مورد سوءاستفاده (اسپم) قرار می گیرد. بنابراین، اگر فکر می کنید فقط با قرار دادن یک دسته فایل مارک داون در سایت خود می توانید به «انتخاب اول» در بازیابی و کشف هوش مصنوعی تبدیل شوید، سخت در اشتباهید.
OKF صرفاً یک منبع با سیگنال بالاتر در میان منابع متعدد است. ممکن است هزینه پردازش را برای ربات ها کاهش دهد و کیفیت سیگنال را بهبود بخشد، اما جایگزین فرآیندهای فعلی سئو و طراحی سایت نمی شود.
باید صادق باشیم: OKF برای تیم های داده (Data Teams) ساخته شده است، نه سایت های بازاریابی و مارکتینگ. این فرمت به عنوان راهی برای اشتراک گذاری دانش داخلی درون سازمان ها (مثل طرح های دیتابیس، دستورالعمل ها و تعاریف متریک ها) میان عوامل هوش مصنوعی ارائه شد. استفاده از آن برای یک وب سایت عمومی، حداقل به نظر من، استفاده ای نامربوط و تغییر کاربریِ نابجا است.
فرانسوا واندرسیپن (Francois Vanderseypen) دقیق ترین نکته را درباره ماهیت واقعی OKF بیان می کند: یک گراف جهت دار از فایل های مارک داون، در واقع یک شبکه از اسناد است، نه یک گراف دانش (Knowledge Graph) به معنای واقعی کلمه. یک گراف دانش واقعی دارای روابط صریح، قابل پرس وجو و نوع بندی شده است. اما OKF اینکه یک لینک چه معنایی دارد را کاملاً به عهده تولیدکننده می گذارد و یک مدل زبانی (LLM) هنوز هم باید هر بار که آن را می خواند، معنای آن را استنتاج کند.
برای من، این موضوع به هسته اصلی درک ما از وب و وظیفه ما به عنوان متخصصان سئو اشاره دارد. OKF ساختار را تغییر نمی دهد، بلکه تنها یک ورودی جدید به آن اضافه می کند.
این یک میانبر نیست. اساساً هیچ میانبری وجود ندارد!
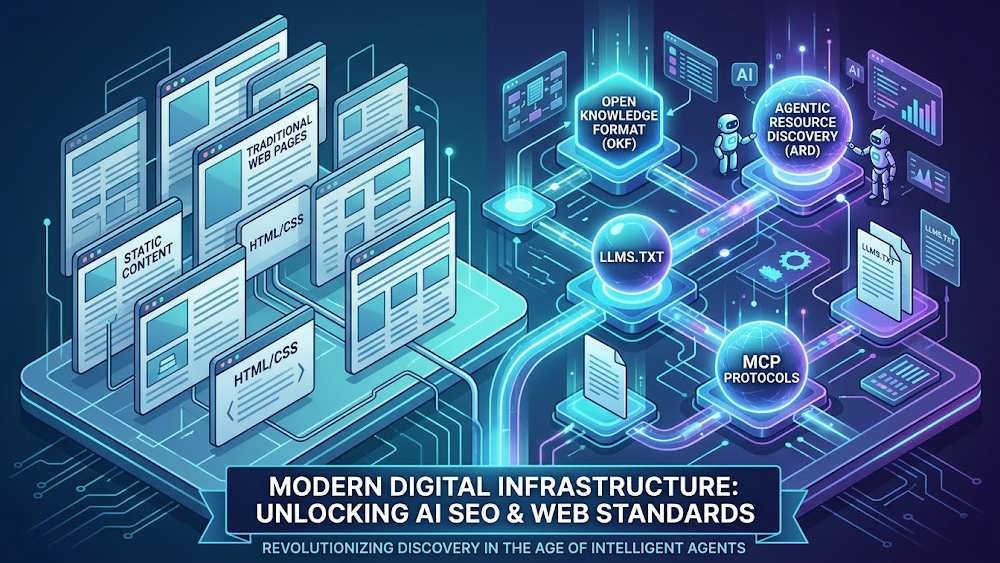
نحوه سازماندهی فایل های Markdown همراه با YAML Frontmatter در استاندارد Open Knowledge Format.
شباهت به مسیر Schema.org و چرایی اهمیت آن
یکی از الگوهایی که باید در اینجا درک کنیم، مسیری است که پیش از این Schema.org طی کرده است.
داده های ساختاریافته (Structured Data) یک مسیر قابل پیش بینی را طی کردند:
پذیرش اولیه -> افزایش رتبه -> استفاده گسترده (و سوءاستفاده و اسپم) -> یادگیری پلتفرم ها -> کاهش وابستگی به عنوان یک سیگنال رتبه بندی.
اسکیمای FAQ مدتی در نتایج جستجو (SERP) جولان داد، اما در نهایت گوگل ریچ ریزالت FAQ را متوقف کرد. پلتفرم ها از سیگنال ها یاد می گیرند، این درس ها را در الگوریتم ادغام می کنند و پس از مدتی، نشانه گذاری های صریح ضرورت کمتری پیدا می کنند.
متخصصان تیم سئو در دانش وب به خوبی با این چرخه آشنا هستند. فایل های OKF و LLMs.txt نیز ممکن است همین مسیر را طی کنند. آن ها در مراحل اولیه بیشترین ارزش را دارند؛ یعنی در دنیایی که سیستم های هوش مصنوعی هنوز در حال یادگیری نحوه پردازش وب هستند، این فایل ها به عنوان سیگنال های واضح عمل می کنند.
با گذشت زمان، اگر این فرمت ها به درستی کار کنند، سیستم ها یاد می گیرند و نشانه گذاری صریح یا زائد می شود یا صرفاً به عنوان یک لایه تأییدیه باقی می ماند. به عنوان مثال در تجارت الکترونیک، هماهنگی بین اسکیما و فید محصولات روز به روز مهم تر شده است. (دلیل دیگری برای اینکه تیم سئو و تیم تبلیغات پولی باید مالکیت مشترکی روی فید محصول داشته باشند!)
سال ها جستجوی گوگل و گوگل مرچنت سنتر نیازمندی های متفاوتی برای داده های ساختاریافته داشتند که وب مسترها را مجبور می کرد کدها را کپی کنند. اسکیما تکامل می یابد تا این شکاف ها را پر کند، اما کُند است، پیچیده است و پیاده سازی آن هنوز هم اغلب دردسرساز است.
همان طور که داده های ساختاریافته هیچ گاه یک اهرم رتبه بندی ساده ی «نصب کن و نتیجه بگیر» نبودند، OKF هم نخواهد بود.
آیا باید وب سایت خود را به فرمت Markdown تبدیل کنید؟
از نظر من پاسخ قطعی «خیر» است! البته این بدان معنا نیست که آن را تست نمی کنم یا با احتیاط به کار نمی برم.
جان مولر در پادکست Search Off the Record در این باره می گوید:
«وقتی صحبت از یک موتور جستجو یا حتی یک سیستم عمومی LLM می شود، داشتن وب سایتی که از HTML استاندارد برای صفحات استفاده کند، بسیار حیاتی است. زیرا موتور جستجو یا ربات خزنده می تواند به سادگی وارد آن صفحه شود و تمام لینک های دیگر موجود در وب سایت را تشخیص دهد.»
اطلاعات ساختاری موجود در HTML (مثل لینک های ناوبری، فوترها، سلسله مراتب هدرها، لینک های داخلی) دقیقاً همان روشی است که خزنده ها شکل و ساختار سایت شما را درک می کنند. فایل های مارک داون تمام این اطلاعات را حذف می کنند. در واقع با این کار، شما قابلیت کشف (Discovery) سایت را نابود می کنید تا شاید خوانایی ماشین را برای تک تک صفحات کمی بهبود ببخشید!
اخیراً در لینکدین تحقیقی دیدم که نشان می داد «ممکن است منوی ناوبری سایت شما، بودجه خواندن LLM (به طور دقیق تر ChatGPT Deep Research) را ببلعد!». یافته های جالبی بود، اما لطفاً منوی ناوبری سایت خود را برای «ذخیره چند توکن» حذف نکنید!
جونو آلدرسون (Jono Alderson) این نکته را به زیبایی بیان می کند: «یک صفحه وب فقط ظرفی برای کلمات نیست، بلکه یک اثر ویراستاری است.» سلسله مراتب، تأکید، چیدمان، اینکه چه چیزی اول می آید، چه چیزی برجسته است، چه چیزی در پاورقی پنهان شده… این ها صرفاً تزئیناتی برای زیبایی چشم انسان نیستند، بلکه «سیگنال هایی در مورد معنای محتوا» هستند.
او می گوید: «وقتی یک صفحه را در قالب مارک داون مسطح می کنید، فقط بی نظمی را از بین نمی برید؛ بلکه قضاوت و بافت (Context) را هم حذف می کنید.» به محض اینکه یک نسخه صرفاً ماشینی منتشر می کنید، شما در واقع یک نسخه کاندیدای دوم از واقعیت سایتتان خلق کرده اید.
راهکار خسته کننده اما قدیمی همچنان کارساز است: HTML معناگرا (Semantic HTML)، ساختار شفاف، سلسله مراتب منطقی، و محتوایی که همگام با لود شدن صفحه وجود دارد.
جان مولر بحث مارک داون را در پادکست به طور گسترده ای پوشش می دهد: مشکل نسخه های موازی، درس هایی که قبلاً از رندر پویا (Dynamic Rendering) به سختی آموخته ایم، و اینکه چرا حفظ یک نسخه سایه (Shadow Version) از وب سایت برای هوش مصنوعی، بار نگهداری و دیباگ کردن را دوبرابر می کند و یک کابوس فنی برایتان می سازد.
تنها استثنایی که مولر قائل می شود، مستندات توسعه دهندگان (Developer Documentation) است:
«اگر چیزی شبیه به مستندات توسعه دهندگان دارید، در صورتی که عامل هوشمند یا LLM از قبل با سایت شما آشنا باشد و کاربر بپرسد “چگونه از این API استفاده کنم؟”، ارائه یک فایل مارک داون به LLM فهم آن را بسیار آسان تر می کند.»
صادقانه بگویم، من هم می توانم این کاربرد مستقیم و منطقی را برای مارک داون درک کنم.
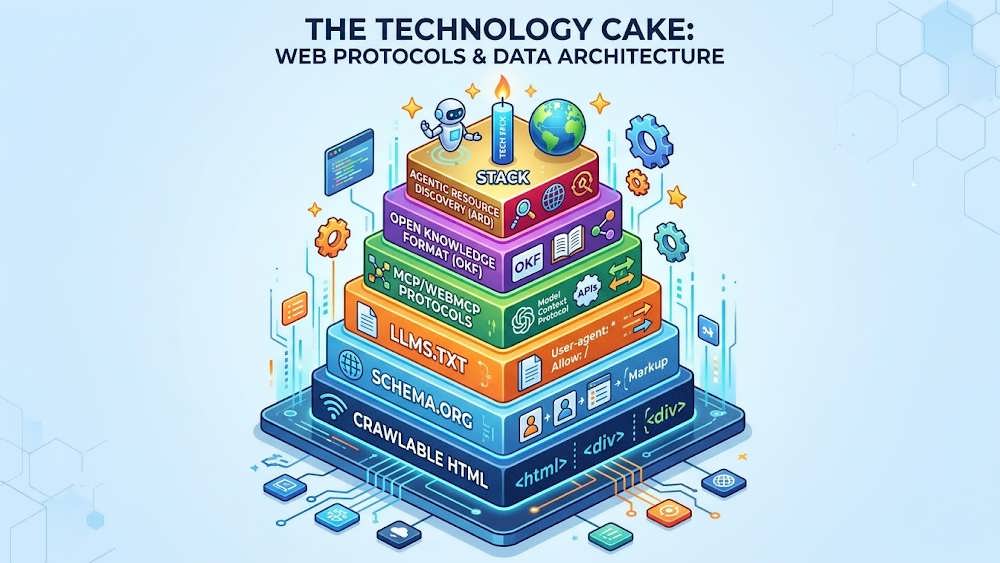
مقایسه تصویری میان غنای ساختاری HTML معناگرا برای ربات های جستجو در برابر ساده سازی مارک داون.
استاندارد ARD واقعاً چه کاری انجام می دهد
استاندارد «کشف منابع مبتنی بر عامل» (ARD) که توسط گوگل در ۱۷ ژوئن ۲۰۲۶ معرفی شد، کلاً موجود متفاوتی است. این استاندارد تنها با چند روز فاصله از OKF منتشر شد (که اصلاً تصادفی نیست) و در همین مدت کوتاه موج بزرگی ایجاد کرده است.
مشکلی که ARD حل می کند، یک مشکل هماهنگی است. در حال حاضر، یک عامل هوشمند باید قبل از اینکه بتواند با یک ابزار، سرور MCP یا API کار کند، به صورت دستی به آن متصل شود.
این روش زمانی جواب می دهد که بخواهید به تعداد معدودی از خدمات شناخته شده متصل شوید. اما به محض اینکه تعداد قابلیت های در دسترس فراتر از چیزی برود که یک تیم بتواند از پیش تنظیم کند، این مدل مقیاس پذیری خود را از دست می دهد.
ارد (ARD) این فرآیند کشف را از مرحله راه اندازی (Setup) به مرحله اجرا (Runtime) منتقل می کند. به این ترتیب، عامل هوشمند به جای اینکه فقط به چیزهایی که از قبل برایش تعریف شده متصل شود، هر زمان که به چیزی نیاز داشت آن را جستجو و پیدا می کند.
این استاندارد بر پایه دو عنصر اساسی بنا شده است:
- کاتالوگ ها (Catalogs): یک فایل
ai-catalog.jsonکه روی دامنه شما میزبانی می شود و قابلیت های موجود شما (مانند سرورهای MCP، عوامل A2A یا ابزارهای OpenAPI) را توصیف می کند. مالکیت دامنه به عنوان پایه رمزنگاری برای احراز هویت و اعتماد عمل می کند. - رجیستری ها (Registries): موتورهای جستجو برای وبِ مبتنی بر عامل. آن ها کاتالوگ ها را می خزند، ایندکس می کنند و توانمندی های منطبق را همراه با متادیتای لازم (برای تأیید هویت ناشر پیش از اتصال) برمی گردانند.
اگر رسالت OKF «بسته بندی دانش برای مصرف» است، رسالت ARD «تبلیغ قابلیت ها برای اتصال» است.
این ها تلاش های موازی در لایه های مختلف پشته (Stack) رو به رشد هوش مصنوعی هستند. هر دو با فاصله زمانی بسیار کم عرضه شدند و حالا با سرعت نور توسط بازیگران بزرگ این عرصه (مثل پلتفرم Hugging Face و ابزار Discover آن ها) در حال پذیرش هستند.
این احتمالاً شرط بندی واقع بینانه تری نسبت به لایه منطق فرمال (Formal logic) است که پیش از این آمد اما هرگز در مقیاس وب موفق نشد. زمان همه چیز را ثابت خواهد کرد.
یک شکاف که ارزش بررسی دارد
چند روز پس از انتشار این دو استاندارد، یکی از مشارکت کنندگان مسائلی را در مخازن (Repositories) گیت هابِ ARD و OKF باز کرد و به یک نقص اساسی اشاره نمود: هیچ نوع رسانه (Media Type) استانداردی برای بسته های OKF تعیین نشده است. بنابراین یک کاتالوگ می تواند وجود یک فایل OKF را لیست کند، اما تا زمانی که محتویات آن را استخراج و بو نکشد (Sniffing)، نمی تواند آن را به عنوان یک فایل OKF تشخیص دهد!
در همین حین، پابلیشرهای مختلف در حال تبلیغ بسته های خود در محیط پروداکشن با استفاده از تایپ های موقت خودشان هستند که به احتمال زیاد با یکدیگر همخوانی نخواهند داشت.
در نگاه اول، این یک درخواست کوچک به نظر می رسد؛ فقط یک درخواست برای تعیین یک برچسب (Label) مشترک. پس از کمی بررسی متوجه می شویم که این یک رویه کاملاً عادی در دنیای وب است. منتظر ماندن برای رسیدن به توافق کامل قبل از عرضه یک محصول، دقیقاً همان چیزی است که باعث مرگ یک استاندارد در جلسات کمیته ها می شود! انتشار سریع و سپس پچ کردن مشکلات همزمان با پذیرش عمومی، یک استراتژی قدیمی و اثبات شده است.
خود فرمت معروف application/json تا سال ۲۰۰۶ به طور رسمی ثبت نشده بود، یعنی حدود پنج سال پس از آنکه JSON به صورت غیررسمی و گسترده استفاده می شد. هیچ کس نگران این موضوع نبود، زیرا هزینه قطعی نبودن برچسب بسیار پایین بود.
اما OKF متفاوت است، زیرا اتفاقاتی که پس از دریافت (Fetch) فایل می افتد با کدهای معمولی متفاوت است. آرتیفکتی که پشت این برچسب قرار دارد، بسته ای است که قرار است توسط یک عامل خودمختار (Autonomous Agent) بلعیده، تأیید و احتمالاً بر اساس آن عمل شود؛ آن هم درون یک سیستم کشف که دقیقاً برای ارتباط عامل-به-عامل یا عامل-به-ابزار ساخته شده است. اگر در اینجا نوع فایل اشتباه تعریف شود، ریسک موجود فقط یک خطای تجزیه (Parse Error) نیست؛ بلکه ریسکِ عمل کردن یک سیستم بر اساس دیتایی است که نباید به آن اعتماد می کرد و هیچ کس هم برای بررسی نتیجه حضور ندارد!
باید دید ریسک حل این موضوع در آینده به جای حل سریع آن چقدر است. احتمالاً بستگی به این دارد که سرعت حل این نقص چقدر سریع تر از سرعت پذیرش و گسترش آن در وب باشد.
دیاگرام نحوه تعامل عامل های هوشمند با کاتالوگ های ai-catalog.json و ثبت خدمات در وب.
این تغییرات برای شما به عنوان متخصص سئو چه معنایی دارد؟
چند نتیجه گیری صادقانه و تفکرات فعلی من:
- برای اکثر سایت های بازاریابی و محتوایی، چیز زیادی تغییر نکرده است. HTML با ساختار خوب برای انسان ها، هنوز هم پایه و اساس درست کار است. یک فرم تماس با ما و یک معماری سایت تمیز، خیلی بهتر از هر بسته OKF به شما کمک خواهد کرد. دیسکاوری (کشف) سایت همچنان به بک لینک ها، آتوریتی، سیگنال های کاربر و البته ایندکس شدن بستگی دارد.
- فایل LLMs.txt یک تابلو راهنما است، نه یک ابزار سئو. این فایل به یک عامل هوش مصنوعی کمک می کند تا زمانی که از قبل وارد سایت شما شده، مسیر خود را پیدا کند. به احتمال زیاد این فایل تأثیر بزرگی در اینکه این عوامل در وهله اول چگونه شما را پیدا می کنند، نخواهد داشت. و احتمالاً هرگز هم نخواهد داشت.
- پروتکل های MCP/WebMCP. در حال حاضر هیچ کدام برای سایت های بازاریابی فوری و ضروری نیستند، اما اگر در حال ساخت سیستم هایی با رابط های برنامه نویسی یا جریان های تجارت الکترونیک هستید که می خواهید عوامل هوشمند به راحتی در آن ها حرکت کنند، این مسیری است که زیرساخت وب به سمت آن در حرکت است.
- استفاده از OKF در صورتی منطقی است که دانش داخلی ساختاریافته ای داشته باشید. (مثل مستندات، راهنمای APIها، مشخصات فنی محصولات) و بخواهید مصرف آن ها را برای عوامل هوش مصنوعی آسان تر کنید. ابزار رایگان سازنده OKF که سوگانثان توسعه داده است، می تواند علاوه بر تولید بسته OKF، یک نمای گرافیکی از ساختار لینک سازی داخلی سایت نیز به شما بدهد که از نظر حسابرسی ساختاری (Structural Audit) به تنهایی ارزش بالایی دارد. با این حال، من ابتدا آن را روی وب سایت خودم اجرا می کنم، نه وب سایت مشتریانم.
- استاندارد ARD ارزش پیگیری دارد اگر خدمات برنامه نویسی شده ارائه می دهید. اگر ابزارها، ایجنت ها یا APIهایی دارید که می خواهید توسط سایر عوامل کشف شوند، ARD استاندارد نوظهوری برای انجام این کار است. فقط به یاد داشته باشید که لایه هویتیِ زیرین آن (یعنی آنچه که ایجنت در هنگام یافتن کاتالوگ شما می بیند) هنوز در حال تثبیت است. بنابراین فعلاً آن را به چشم یک زیرساختِ نیازمند بررسی دقیق ببینید و مسیرهای حیاتی کسب وکارتان را روی آن بنا نکنید.
- چرخه پذیرش اسکیما ممکن است تکرار شود. این فرمت ها در حال حاضر به عنوان سیگنال های اولیه بیشترین ارزش را دارند. اگر می توانید به صورت کم هزینه آن ها را پیاده سازی کنید، این کار را انجام دهید. اما استراتژی خود را بر پایه این فرض که آن ها برای همیشه ارزش خود را حفظ می کنند، بنا نکنید و روی آن ها به عنوان یک معجزه حساب باز نکنید.
در نهایت، مراقب این اسباب بازی های براق و جدید باشید! اگر شرکت شما مشکلات بسیار بزرگتری برای حل کردن دارد (مثل داشتن یک وب سایت افتضاح، برندی که هیچ کس نمی شناسد یا به آن اهمیتی نمی دهد، یا مخاطبی که نیازهایش را نمی شناسید)، لطفاً پیش از اینکه درگیر این زرق و برق های جدید شوید، به مشکلات اساسی خود برسید.
تغییر بنیادین وب
تمام این موارد به این واقعیت اشاره دارد که وب در حال رشد یک لایه دوم یا شاید یک سر سوم است؛ لایه ای که به طور خاص برای ماشین ها نوشته شده و در کنار لایه ای که برای مرورگرها و انسان ها طراحی شده بود، قرار می گیرد.
فایل Sitemap.xml به خزنده ها می گفت کدام URLها وجود دارند. فایل Robots.txt به آن ها می گفت به کجا نروند. اکنون LLMs.txt، OKF و ARD به عنوان زیرساخت های مشابه برای سیستم های مبتنی بر عامل عمل می کنند: راهنماهای ناوبری، بسته بندی محتوا و کشف قابلیت ها.
هیچ کدام از این ها امروز اجباری نیستند. هیچ کدام جایگزین HTML اصولی، محتوای معتبر، ساختار منطقی و البته مهم ترین عامل یعنی «یک برند ارزشمند» نمی شوند.
اما متخصصان سئویی که به جای برخورد با این مفاهیم به عنوان یک دسته بندیِ مبهم به نام «AI SEO»، دقیقاً درک کنند که هر لایه چه کاری انجام می دهد، شرط بندی های بسیار بهتری روی زمان و سرمایه خود خواهند کرد.
شرطِ من روی «لایه دوم» است؛ یک زیرساخت موازی که برای ماشین ها نوشته شده، نه چیزی که قرار باشد جایگزینِ وبِ فعلیِ ما شود.
سناریوی «سر سوم» (جایی که سیستم های مبتنی بر عامل به طور کامل از وبِ انسانی جدا می شوند)، نیازمند نوع دیگری از شرط بندی است که هیچ کدام از ما در حال حاضر روی آن سرمایه گذاری نمی کنیم.
نتیجه گیری
با روی کار آمدن فناوری های مبتنی بر هوش مصنوعی مانند OKF و ARD، بدون شک لایه های جدیدی در حال اضافه شدن به ساختار وب هستند که ارتباط میان ماشین ها و وب سایت ها را تسهیل می کنند. با این حال، به عنوان صاحبان کسب وکار یا متخصصان دیجیتال مارکتینگ، نباید از اصول اولیه سئو و طراحی کاربرپسند (UI/UX) غافل شویم. در آژانس دانش وب، تجربه به ما ثابت کرده است که پایبندی به استانداردهای بنیادین مانند کدنویسی تمیز، تولید محتوای ارزشمند و برندسازی اصولی، همچنان قدرتمندترین ابزارهای شما برای تسخیر نتایج جستجو هستند. ترندهای تکنولوژی را هوشمندانه زیر نظر بگیرید، اما هرگز پایه های اصلی کسب وکار آنلاین خود را فدای تکنیک های زودگذر نکنید.