

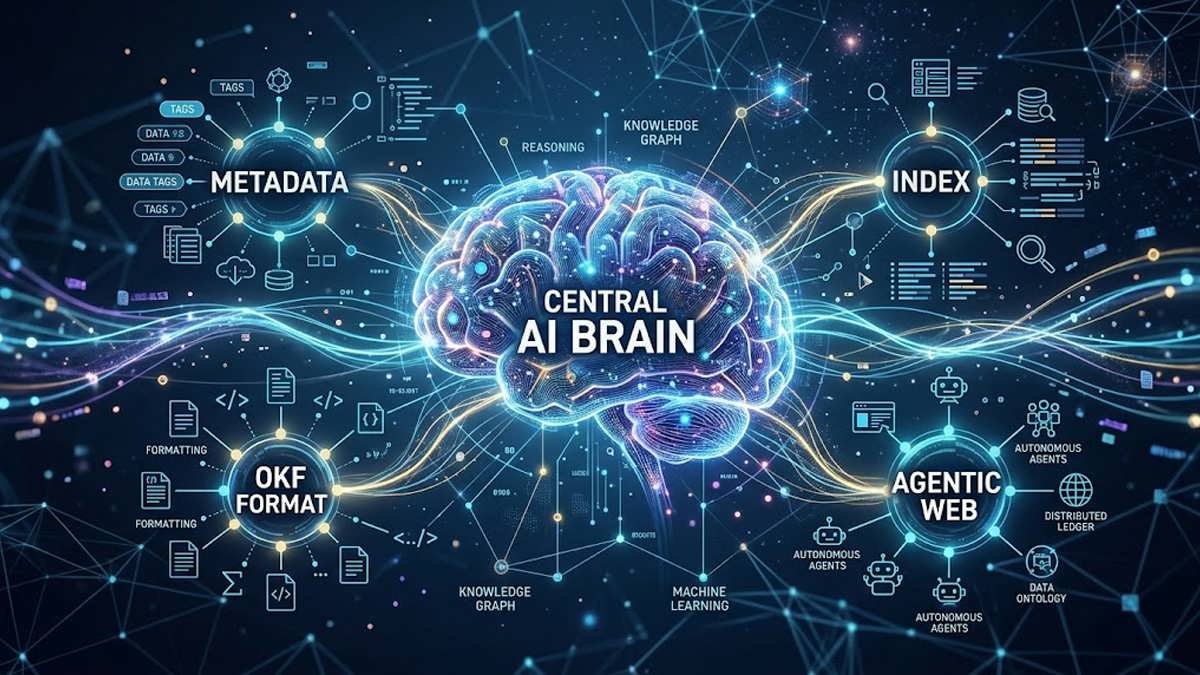
کشف کنید که چگونه مغز OKF خودم را ساختم و با تاثیر شگفت انگیز «فرمت دانش باز» (Open Knowledge Format) بر وب عامل محور (Agentic Web) آشنا شوید.
مقاله قبلی من درباره «فرمت دانش باز گوگل» یا همان OKF (Google’s Open Knowledge Format) یکی از محبوب ترین و پربازدیدترین مقالاتی بود که تا به حال منتشر کرده ام. از آن زمان تاکنون، تمام تمرکز و وقتم را صرف کار روی ساختار OKF اختصاصی خودم کرده ام. در واقع، من اساساً یک «مغز شخصی» برای خودم ساخته ام و امروز می خواهم به شما نشان دهم که این سیستم چگونه کار می کند و چرا این استاندارد برای حرکت به سمت «وب عامل محور» (وب مبتنی بر ایجنت های هوش مصنوعی که مستقلاً عمل می کنند) تا این حد حیاتی و مهم است.
زیبایی چشمگیر فرمت OKF در این است که از یک ساختار بسیار ساده و کاملاً استاندارد پیروی می کند. با وجود اینکه بسیاری از افراد اشاره کرده اند که فایل های مارک داون (Markdown) پدیده جدیدی نیستند، اما شاهکاری که گوگل در اینجا انجام داده، خلق یک استاندارد جهانی است. این یعنی اگر من فایل های OKF خودم را به یک ایجنت (دستیار هوشمند) هوش مصنوعی بدهم، او دقیقاً می داند که چگونه باید آن ها را بخواند؛ بدون اینکه به هیچ نرم افزار سفارشی یا کدنویسی پیچیده ای نیاز داشته باشد. این یک زبان بین المللی و مشترک برای ایجنت های هوش مصنوعی است.
درک عمیق متادیتا (YAML Frontmatter)، فایل ایندکس و فایل های مارک داون
هر فایل OKF با چیزی به نام YAML frontmatter آغاز می شود. این در واقع یک بلوک کوچک از فراداده ها (Metadata) در بالاترین بخش فایل مارک داون شماست که به ایجنت هوش مصنوعی دقیقاً می گوید در حال تماشای چه چیزی است. در مغز شخصی خودم، من برای هر چیزی از انواع (Types) مشخصی استفاده می کنم. من در این سیستم مفاهیم (Concepts)، موجودیت ها (Entities)، کتابچه های راهنما (Playbooks)، منابع و سیستم هایی دارم.
اهمیت استفاده از ساختار داده های منظم، دقیقاً مشابه همان چیزی است که ما در دانش وب برای معماری و سئوی سایت های مشتریانمان پیاده سازی می کنیم. وقتی ساختار اطلاعات سایت شما (چه برای موتورهای جستجو و چه برای ایجنت های هوش مصنوعی) استاندارد و دسته بندی شده باشد، درک آن برای ربات ها بی نهایت سریع تر و دقیق تر خواهد شد.
هنگامی که یک ایجنت به فایل های OKF من نگاه می کند، اولین چیزی که می بیند فایل index.md است. این فایل اساساً یک فهرست جامع از بخش های مختلفی است که ایجنت می تواند در مغز من به آن ها دسترسی داشته باشد. با این روش هوشمندانه، به جای اینکه ایجنت من مجبور باشد تکنیک RAG (تولید افزوده شده با بازیابی) را روی کل پایگاه دانش من اجرا کند و زمان زیادی هدر رود، می تواند مستقیماً روی بخش هایی تمرکز کند که دقیقاً به درخواست کاربر مرتبط هستند.
سیستمی که ساخته ام همچنین وظیفه دارد تا مفاهیم مرتبط را به یکدیگر متصل کند. وقتی این سیستم یک محتوای جدید را دریافت می کند (چه یک پست وبلاگ باشد که خودم نوشته ام، چه یک اطلاعیه جدید از سمت گوگل یا یک مقاله پژوهشی)، بررسی می کند که چه مفاهیم دیگری در مغز ما ایجاد شده که باید به این محتوای جدید متصل شوند. نتیجه این کار، یک گراف (Graph) بسیار جذاب و قدرتمند از تمام دانشی است که در این مغز ذخیره کرده ایم. ایده اصلی استخراج مفاهیم و ایجاد ارتباط بین آن ها توسط ایجنت ها، در واقع از ایده LLM Wiki آندری کارپاتی (Andrej Karpathy) الهام گرفته شده است.
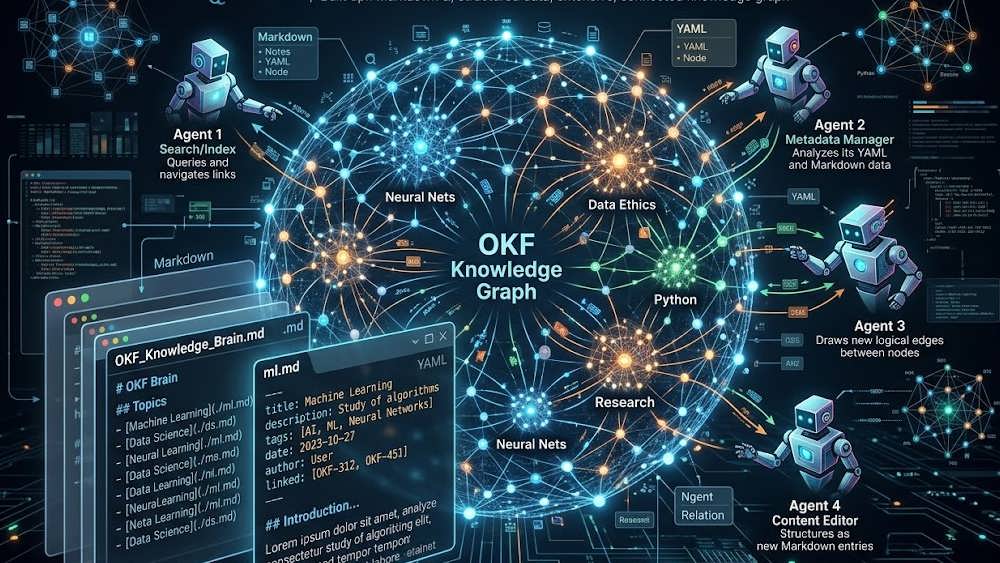
این تصویر به صورت بصری نمایش می دهد که چگونه فایل های مارک داون و فراداده های YAML به همراه فایل ایندکس، یک شبکه و گراف متصل از مفاهیم را برای ایجنت های هوش مصنوعی ایجاد می کنند.
تصویرسازی گراف دانش شما (Knowledge Graph)
زمانی که از فرمت OKF به درستی استفاده کنید، می توانید مغز خود را به شکل یک گراف متصل و یکپارچه به تصویر بکشید. هر نقطه (Dot) در سیستم من، نمایانگر یک فایل مارک داون است. شما می توانید ببینید که چگونه مفاهیم من در مورد «پاسخ های هوش مصنوعی» (AI Overviews) به منابعی از مستندات گوگل و از آنجا به کتابچه های راهنمای داخلی خودم متصل می شوند. این یک نقشه زنده، پویا و در حال تنفس از تمام چیزهایی است که من درباره سئو (SEO) و هوش مصنوعی می دانم.
در دیجیتال مارکتینگ و سئو، ما به این مفهوم «خوشه بندی محتوا» (Topic Clustering) می گوییم. در دانش وب، ما با ایجاد گراف های دانش مشابه برای سایت ها، اعتبار موضوعی (Topical Authority) آن ها را نزد گوگل به شدت افزایش می دهیم.
من همچنین فرایند دریافت اطلاعات را کاملاً خودکار کرده ام. من سیستمی دارم که مستندات گوگل را به صورت روزانه چک می کند. اگر آن ها چیزی را به روزرسانی کنند – مثلاً مستندات مربوط به AI Answers یا ویژگی های جدید سرچ کنسول – مغز من بلافاصله به من اطلاع می دهد و فایل های منبع مربوطه را به صورت خودکار آپدیت می کند. من دیگر مجبور نیستم برای به خاطر سپردن هر تغییر کوچکی، به سخت افزار بیولوژیکی (مغز خودم) تکیه کنم. مغز OKF من اکنون به حجم اطلاعاتی دسترسی دارد که بسیار فراتر از گنجایش حافظه کوتاه مدت من است.
سپس می توانم از مغزم سوال بپرسم (Query)، و او برای من متنی می نویسد که ترکیبی از یادداشت های خودم و سایر اطلاعاتی است که پیش تر برای ذخیره در مغزم انتخاب کرده ام. اگر حس کنم چیزی در متن خروجی درست نیست، به سادگی از ایجنتِ درون مغزم می خواهم که آن را اصلاح کند. به علاوه، ایجنت من همیشه به دنبال راه هایی برای بهبود و ایجاد ارتباط بهتر بین اطلاعات موجود در مغز است.
ساخت کتابچه های راهنما (Playbooks) برای صرفه جویی در روزها کار مداوم
یکی از هیجان انگیزترین چیزهایی که در مغز OKF خودم ساخته ام، مجموعه ای از کتابچه های راهنما (Playbooks) است. به عنوان مثال، من یک کتابچه راهنما برای تولید پروپوزال های مشتریان دارم. به طور معمول، این یک فرایند خسته کننده است که به کار دستی فراوانی نیاز دارد. اما اکنون، ایجنت من (Antigravity) مراحلی را که در کتابچه راهنمای پروپوزال تعریف کرده ام قدم به قدم دنبال می کند تا تمام موارد را دقیقاً با لحن، منطق و ادبیات خاص من پیش نویس کند.
من همچنین یک کتابچه راهنما برای تحلیل تاثیر آپدیت های گوگل بر روی سایت ها ساخته ام. من یک سری چک پوینت های رویه ای ایجاد کردم که ایجنتم هنگام تحلیل این نوسانات رتبه بندی، آن ها را دنبال می کند. کاری که در گذشته دو روز کامل از من زمان می گرفت تا آن را تحلیل کنم، اکنون تنها در عرض چند ساعت انجام می شود، و گزارشی که تولید می شود به قدری دقیق است که من از آن بی نهایت راضی هستم. این دقیقاً همان قدرت بی نظیر مستندسازیِ دانش و خرد شماست؛ آن هم به روشی که ایجنت ها بتوانند آن را به صورت اجرایی عملی کنند.
من واقعاً شما را تشویق می کنم که آزمایش با این سیستم را شروع کنید. برای شروع به هیچ وجه نیازی نیست که یک برنامه نویس باشید. شما می توانید بر اساس مستنداتی که گوگل ارائه کرده، به یک ایجنت بگویید که به شما در ساخت اولین بسته OKF خود کمک کند. این کار من را به شدت بهره ورتر کرده است، و معتقدم که این کلید طلایی برای بقا و حفظ جایگاه در زمانی است که جستجو (Search) با سرعت در حال تکامل است.
برای ساخت سیستمی مشابه، این لینک ها را به ایجنت خود (مثل Claude Code / Cowork، ChatGPT Codex یا ایجنت مورد علاقه من یعنی Google’s Antigravity) بدهید و این پرامپت (دستور) را امتحان کنید:
«من می خواهم یک سیستم OKF شبیه به ماری هینز بسازم. این لینک ها را بخوان و سپس به من چند ایده بده که این سیستم قرار است چه شکلی باشد. سپس، یکی یکی از من سوال بپرس تا با هم تصمیم بگیریم که دقیقاً می خواهیم چه چیزی بسازیم:»
- https://cloud.google.com/blog/products/data-analytics/how-the-open-knowledge-format-can-improve-data-sharing/
- https://github.com/GoogleCloudPlatform/knowledge-catalog/blob/main/okf/SPEC.md
- https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
- https://www.mariehaynes.com/okf/
- https://youtu.be/esYAIA6lU-s
نتیجه گیری
در دنیای پرشتاب دیجیتال امروز، تکیه بر حافظه انسانی برای مدیریت حجم انبوه داده ها، آپدیت های مداوم موتورهای جستجو و استراتژی های مارکتینگ دیگر پاسخگو نیست. ساخت یک «مغز دوم» با استفاده از استاندارد OKF گوگل، تنها یک ترند گذرا نیست، بلکه یک تغییر پارادایم اساسی در نحوه تعامل ما با اطلاعات است. با پیاده سازی چنین سیستمی، شما نه تنها زمان انجام کارهای تکراری مانند پروپوزال نویسی یا تحلیل رقبا را به شدت کاهش می دهید، بلکه به یک گراف دانش یکپارچه دست پیدا می کنید که به شما در تصمیم گیری های استراتژیک کمک می کند. همان طور که ما در دانش وب به مشتریان خود توصیه می کنیم، کسب وکارهایی که امروز زیرساخت های داده ای خود را برای تعامل با ایجنت های هوش مصنوعی (Agentic Web) بهینه سازی کنند، رهبران بلامنازع بازار فردا خواهند بود. همین امروز با ابزارهای ساده شروع کنید و ذهن خود را وسعت ببخشید!