

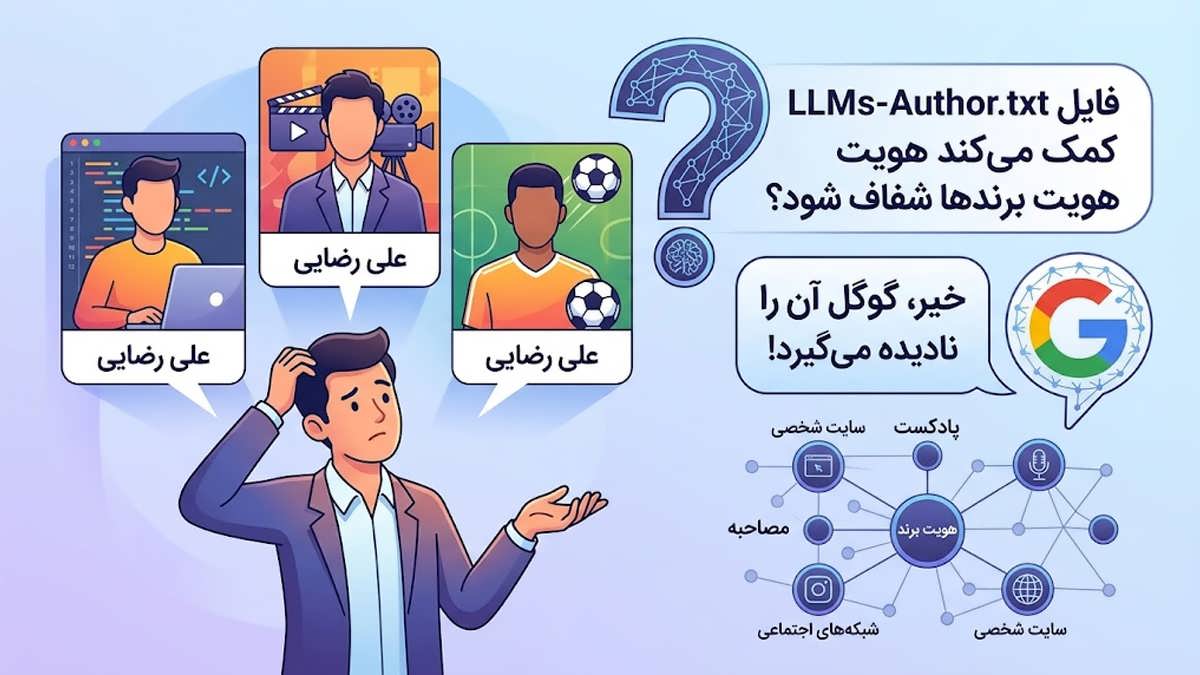
جان مولر (John Mueller) از مدیران ارشد گوگل، اخیراً به سوال مهمی درباره استفاده از فایل LLMs-Author.txt و اینکه آیا این فایل به شناسایی بهتر افراد و برندها در فضای آنلاین کمک می کند یا خیر، پاسخ داده است. در دنیای امروز که مدل های زبانی بزرگ (LLMs) و هوش مصنوعی نقش پررنگی در جستجوها دارند، این موضوع به یکی از دغدغه های جدید متخصصان سئو تبدیل شده است.
ماجرای فایل LLMs-Author.txt چیست؟
جان مولر از گوگل به سوالی پاسخ داد که توسط یکی از کاربران ردیت (Reddit) مطرح شده بود؛ کاربری که در تلاش بود با استفاده از فایلی به نام llms-author.txt حضور خود را در نتایج جستجو و پاسخ های هوش مصنوعی بهینه سازی کند.
برای درک بهتر، تصور کنید نام شما «علی رضایی» است و تخصص شما برنامه نویسی است، اما دو فرد مشهور دیگر (مثلاً یک بازیگر و یک ورزشکار) دقیقاً با همین نام وجود دارند. این کاربر نیز دقیقاً مشکل مشابهی داشت؛ نام او با دو موجودیت (Entity) یا فرد بسیار معروف تر یکسان بود. این تشابه اسمی باعث می شد تا مردم به سختی بتوانند او و خدماتش را در اینترنت پیدا کنند و مدل های هوش مصنوعی نیز در معرفی او دچار سردرگمی می شدند.
کاربر در سوال خود توضیح داده بود:
«سال هاست که این موضوع باعث شده بخش بزرگی از سیگنال های “این شخص کیست؟” در مورد من رقیق شود یا هر زمان که یک مدل هوش مصنوعی یا ویژگی جستجو سعی می کند من را خلاصه و معرفی کند، اطلاعات کاملاً اشتباهی ارائه دهد.»
این کاربر برای حل مشکل خود دو راهکار فنی (اما غیررسمی) را امتحان کرده بود:
گام اول: استفاده از فایل اختصاصی
او ابتدا یک فایل مشخص به نام llms-author.txt (جدا از فایل اصلی llms.txt) ایجاد کرده بود. او در این فایل، عنوان شغلی، نام آژانس، موقعیت مکانی و حوزه تخصصی خود را به صورت جملات ساده و واضح نوشته بود، تا به جای اینکه تمام بار شناسایی را صرفاً روی دوش کدهای اسکیما (Schema Markup) بیندازد، مستقیماً خود را به هوش مصنوعی معرفی کند.
گام دوم: اضافه کردن هدر Content-Signal
در قدم دوم، او هدر جدیدی با عنوان Content-Signal (با مقادیر ai-train=no, search=yes, ai-input=yes) را به فایل robots.txt سایت خود اضافه کرده بود. او اعتراف کرد که این کار را بیشتر از روی کنجکاوی انجام داده تا ببیند آیا اعلام صریح نیت و هدف در سطح هدرهای سایت، تغییر قابل اندازه گیری و ملموسی ایجاد می کند یا خیر.
سوال اصلی این کاربر آن بود که آیا کسی تا به حال تست های کنترل شده ای روی هدرهای Content-Signal انجام داده است تا ببیند آیا واقعاً کار می کنند؟
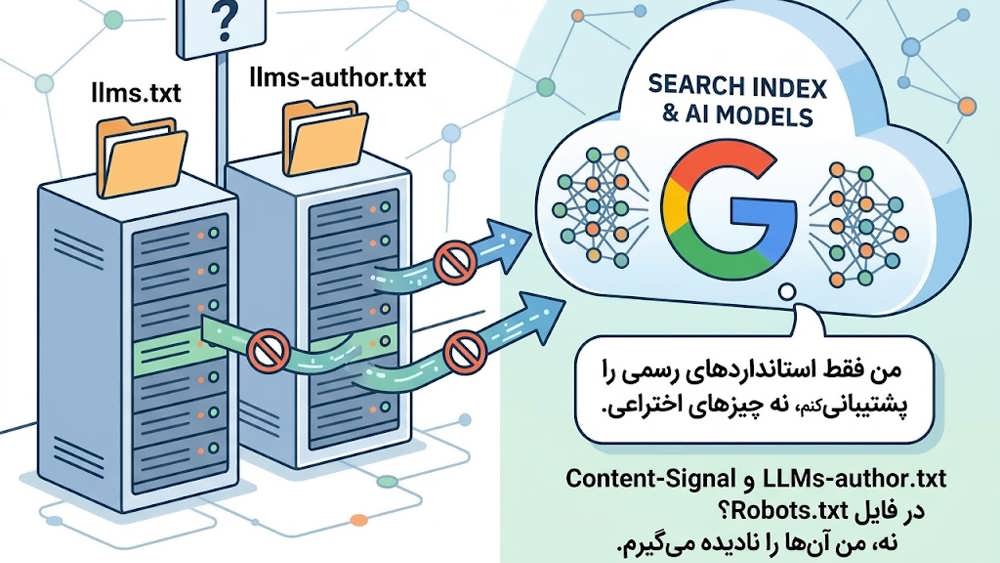
این تصویر گرافیکی تضاد بین تلاش های تکنیکالِ تایید نشده (مثل فایل LLMs-author.txt و هدر Content-Signal) و رویکرد واقعی گوگل و هوش مصنوعی را نشان می دهد. در حالی که کاربر با نام متشابه سعی در شناسایی خود دارد، گوگل صراحتاً اعلام می کند که این روش های غیررسمی را نادیده می گیرد و بر استانداردهای رسمی تمرکز دارد.
آیا LLMs-author.txt واقعیت دارد؟
ظاهراً چیزی به نام فایل LLMs-author.txt اصلاً به صورت رسمی وجود خارجی ندارد! به این معنا که هیچ پروپوزال رسمی یا استاندارد تایید شده ای برای آن در دنیای وب تعریف نشده است و صرفاً یک ایده ساخته ی ذهن برخی کاربران یا ابزارهای سئو است.
ابهام در مورد هدر Content-Signal
وضعیت این هدر حتی از مورد قبلی هم گیج کننده تر است. کلودفلر (Cloudflare) قبلاً یک دستورالعمل به نام Content-Signal را برای فایل robots.txt پیشنهاد داده بود. بعداً کلودفلر از همین سینتکس (نحو) Content-Signal به عنوان یک هدر پاسخ HTTP استفاده کرد که به صورت خودکار در ویژگی «Markdown for Agents» تولید می شد. (این ویژگی کلودفلر، هر زمان که یک کلاینت وب یا ربات درخواستی ارسال کند، به طور خودکار یک نسخه مارک داون – Markdown – از صفحه وب را به آن ارائه می دهد).
بنابراین، از بین دو روشی که این کاربر ردیت استفاده کرده است، به نظر می رسد هیچ کدام بخشی از یک پیشنهاد یا استاندارد واقعی و پذیرفته شده در سطح وب نیستند.
موضع رسمی گوگل درباره LLMs-Author.txt
جان مولر از گوگل به درستی به Content-Signal کلودفلر به عنوان یک دستورالعمل فایل روباتز (Robots Directive) اشاره کرد، چرا که این پروپوزال در اصل برای همین کار تعریف شده است.
او در پاسخ به این کاربر چنین گفت:
«فکر می کنم باید به چند نکته اشاره کنم…
- گوگل از llms.txt یا llms-author.txt استفاده نمی کند. من هیچ خزنده ی وب (Crawler) یا مدل هوش مصنوعی (LLM) دیگری را نمی شناسم که تایید کرده باشد از این فایل ها استفاده می کند (به جز برخی ابزارهای سئو).
- تا جایی که من می دانم، هیچ یک از خزنده ها یا هوش های مصنوعی از دستورالعمل های robots.txt مرتبط با “content-signal” استفاده نمی کنند. این دستورالعمل توسط یک شبکه توزیع محتوا (CDN) ابداع شده است و تا جایی که اطلاع دارم، مطلقاً هیچ تاثیری روی هیچ خزنده یا مدل زبانی ندارد. استفاده از آن فقط باعث ایجاد کدهای اضافه (Bloat) و دردسرهای نگهداری در آینده برای فایل
robots.txtشما می شود.شما می توانید هر چیز دلخواه دیگری را هم به فایل
robots.txtخود اضافه کنید؛ اما خزنده ها فقط از دستورالعمل هایی که پشتیبانی می کنند استفاده کرده و بقیه را نادیده می گیرند.»
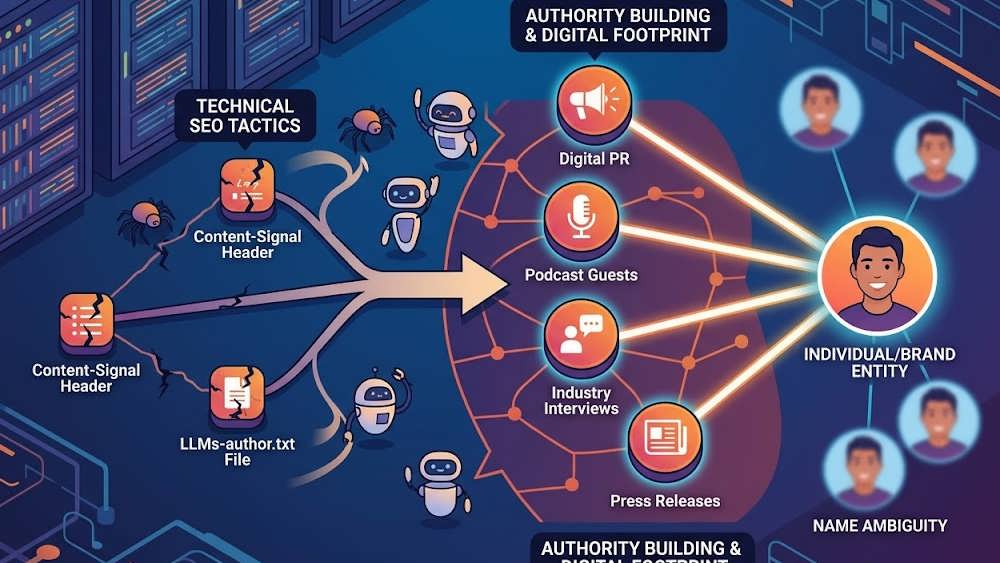
این تصویر نشان می دهد که برای حل مشکلاتِ عمیقی مانند تشابه اسمی و عدم شناسایی توسط هوش مصنوعی، ترفندهای کوچکِ تکنیکال (مانند اضافه کردن چند خط کد به robots.txt) کارساز نیستند. در عوض، باید روی تقویت پایه های حضور دیجیتال (مانند روابط عمومی دیجیتال، پادکست، و مصاحبه) سرمایه گذاری کرد تا یک هویت دیجیتالِ قدرتمند و معتبر ساخته شود.
نتیجه گیری
کاربر ردیت در حال پیگیری یک راه حل در حوزه سئوی تکنیکال است تا مشکلی را حل کند که اساساً فراتر از مرزهای سئو تکنیکال است.
مدل های زبانی هوش مصنوعی (LLMs)، چت بات ها و موتورهای جستجو برای درک ماهیت افراد و برندها، به سیگنال های مختلفی از سراسر وب متکی هستند که داده های ساختاریافته (Structured Data) تنها بخش کوچکی از آن است. مشکل این کاربر این است که در سطح وب، موجودیت های قوی تری با نام مشابه او وجود دارند. بنابراین، مشکل او در واقع با «اعتبار و حضور در سطح وب» است و با چند خط کد در فایل روباتز حل نمی شود.
اگر شما هم به عنوان یک برند یا متخصص با چالش های مشابهی در دیده شدن روبرو هستید، پیشنهاد ما این است که روی تقویت پایه های حضور دیجیتال خود سرمایه گذاری کنید. ما در آژانس دیجیتال مارکتینگ دانش وب، با ارائه خدمات جامع طراحی سایت اختصاصی و بهینه سازی شده، سئوی محتوایی و روابط عمومی دیجیتال (Digital PR)، به شما کمک می کنیم تا به جای تکیه بر ترفندهای تکنیکالِ تایید نشده، یک هویت دیجیتال (Entity) قدرتمند و معتبر برای خود بسازید.
این کاربر (و افرادی با شرایط مشابه) زمانی می توانند به یک راه حل رضایت بخش دست یابند که در سطح وب شناخته شده تر شوند؛ مثلاً از طریق مصاحبه های ویدیویی، حضور در پادکست ها، انتشار رپورتاژ آگهی در سایت های معتبر و انجام کارهای برجسته ای که ردپای دیجیتال (Digital Footprint) آن ها را در اینترنت گسترش دهد.