

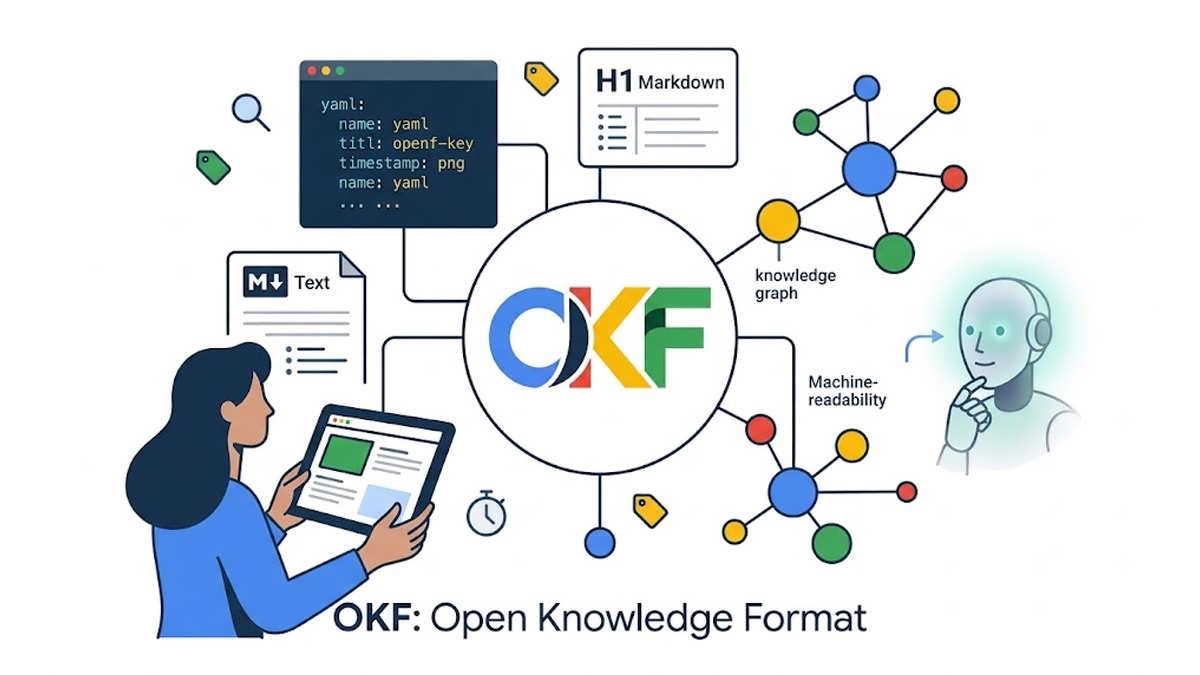
گوگل اخیراً فرمتی را برای تبدیل یک «پایگاه دانش» به پوشه ای از فایل های به هم پیوسته ی مارک داون منتشر کرده است. این فرمت در ابتدا برای سازماندهی داده های داخلی خود شرکت ساخته شده بود، اما کاملاً تصادفی، مشکلی را حل می کند که وب سایت های عمومی نیز با آن دست وپنجه نرم می کنند. در حال حاضر، بیشترین چیزی که یک ایجنت هوش مصنوعی (مثل ربات های خوانش گر یا دستیارهای هوشمند) از سایت شما دریافت می کند، یک خوانش «تخت» و یک بعدی از صفحات شماست؛ آن هم یکی پس از دیگری. اما این فرمت جدید، در عوض یک «گراف» از نحوه ارتباط ایده ها و مفاهیم شما می سازد. به همین دلیل تصمیم گرفتم آن را روی وب سایت خودم آزمایش کنم.
فرمت OKF گوگل: یک دایرکتوری از فایل های مارک داونِ لینک شده
در ۱۳ ژوئن ۲۰۲۶، تیم داده ی گوگل از «فرمت دانش باز» (Open Knowledge Format) یا به اختصار OKF رونمایی کرد. این فرمت روشی برای نمایش یک بدنه دانشی به صورت پوشه ای از فایل های مارک داون است که لایه ی نازکی از متادیتاهای YAML (در بخش Frontmatter) روی آن قرار گرفته است. (YAML یک زبان ساده برای خوانش داده هاست که در برنامه نویسی برای پیکربندی اطلاعات استفاده می شود).
در این سیستم، هر مفهوم، جدول، معیار، دستورالعمل یا API، یک سند مارک داون اختصاصی برای خود دارد. یک بلوک کوتاه از YAML در ابتدای فایل، فیلدهای قابل جستجو مانند نوع، عنوان، توضیحات، منبع، برچسب ها و مهر زمانی (Timestamp) را در بر می گیرد. بدنه مارک داون نیز توضیحات را شامل می شود و مفاهیم مختلف با استفاده از لینک های استاندارد مارک داون به یکدیگر متصل می شوند. گوگل می گوید همین پیوندها، این دایرکتوری را به یک «گراف روابط» (Graph of Relationships) تبدیل می کند. در این ساختار هیچ نیازی به محیط اجرا (Runtime)، کیت توسعه (SDK) یا مراحل پیچیده ساخت (Build Step) نیست. گوگل این پکیج را در سه عبارت خلاصه می کند: «فقط مارک داون»، «فقط فایل»، «فقط متادیتای YAML».
هدف اصلی گوگل، سازماندهی دانش داخلی شرکت بود؛ زمینه ای که به گفته گوگل «پشت هر پلتفرمی که آن را ایجاد کرده، قفل شده است». این استاندارد هنوز در مراحل اولیه (نسخه ۰.۱) است و گوگل آن را «یک نقطه شروع، و نه یک استاندارد نهایی» می نامد. در اطلاعیه گوگل هیچ اشاره ای به وب سایت های عمومی نشده است؛ و دقیقاً همین شکاف و پتانسیل پنهان، موضوع اصلی این مقاله است.
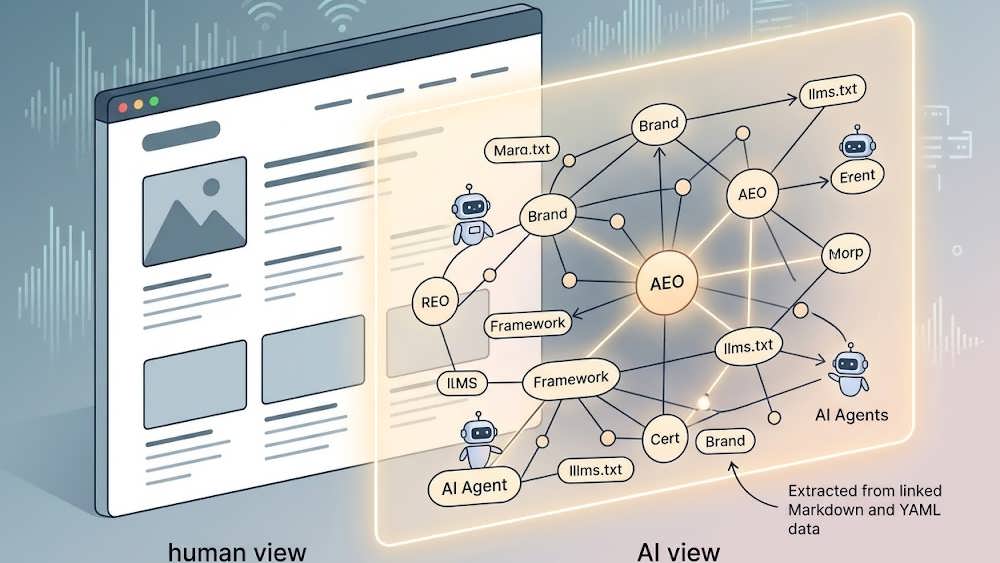
این گرافیک مفهومی، ساختار OKF را به تصویر می کشد: یک پوشه ساده از فایل های مارک داون (Markdown) که با متادیتاهای YAML (بخش Frontmatter) لایه بندی شده اند. این ترکیب، به جای خوانش تخت و پشت سر هم، یک «گراف روابط» (Graph of Relationships) از مفاهیم می سازد که ایجنت های هوشمند می توانند آن را درک کنند.
در یک وب سایت، گراف دانش بسیار فراتر از کپیِ تختِ صفحات عمل می کند
نسخه ای از وب سایت شما که برای ایجنت های هوشمند قابل خواندن است (همان نسخه ای که یک مدل زبانی یا مرورگر واقعاً مصرف می کند)، یک نسخه کاملاً «تخت» است. ارائه هر صفحه به صورت مارک داون (مانند کاری که کلادفلر – Cloudflare در لبه شبکه انجام می دهد) تقریباً شبیه به پروژه AMP برای مدل های زبانی بزرگ (LLMs) است: یعنی یک کپی ثانویه و ساده سازی شده از هر صفحه برای خواندن توسط ماشین. این روش دقیقاً همان چیزی را که دارید کپی می کند، اما بزرگترین نقطه ضعفش این است که نحوه ارتباط صفحات با یکدیگر را نادیده می گیرد.
اینجاست که ما در تیم خدمات طراحی سایت و سئو دانش وب، همیشه بر اهمیت «داده های ساختاریافته» تاکید می کنیم. یک گراف دانش، لایه ی ارتباطی بین مفاهیم را حفظ می کند. وقتی مفاهیم شما به یکدیگر لینک می شوند، ایجنت هوش مصنوعی نه تنها می فهمد که هر مفهوم چیست، بلکه درک می کند که این مفاهیم نسبت به هم چه جایگاهی دارند؛ و این دقیقاً همان معنای واقعیِ «درک یک وب سایت» است. در یک ساختار تخت، ممکن است دو صفحه از سایت شما به یک مفهوم اشاره کنند، اما هرگز به ماشین نگویند که یکی از آن ها فریم ورک اصلی است و دیگری صرفاً یک هدف فرعی. اما گراف دانش این رابطه را صراحتاً از طریق لینک هایی که ماشین دنبال می کند، بیان می کند. فرمت OKF یک روش آماده و در دسترس برای ساخت این گراف است: چون مبتنی بر مارک داون است، ارزان تمام می شود و چون ساختاریافته است، روابط معنایی را با خود حمل می کند.
من OKF را روی سایت No Hacks آزمایش کردم
من یک پکیج OKF برای وب سایت No Hacks نوشتم. برای هر یک از مفاهیم برند، میزبان، معماری ماشین-محور (Machine-First Architecture)، وبِ ایجنتیک (Agentic Web)، بهینه سازی تجربه ایجنت، بهینه سازی موتور پاسخ گو (AEO)، فایل llms.txt و WebMCP یک فایل مارک داون جداگانه ایجاد کردم. هر کدام از این فایل ها از قراردادهای گوگل پیروی می کنند: فیلدهای YAML در بالا و بدنه ساده مارک داون در زیر آن. بخش عمده ی کار، تصمیم گیری در مورد این بود که کدام مفاهیم اهمیت دارند و چگونه به هم متصل می شوند، نه صرفاً نوشتن خود فایل ها.
یکی از فایل ها (مربوط به مفهوم معماری ماشین-محور) به این شکل است:
---
type: framework
title: Machine-First Architecture
description: A framework for building websites whose full meaning is available to a machine reading them, with the human experience layered on top rather than the other way around.
resource: https://machinefirstarchitecture.com
tags: [Framework, Machine-First Architecture, Agentic Web]
timestamp: 2026-06-13
---
Machine-First Architecture is Sani’s framework for the agentic web. The core idea: build the content so a machine reading it gets the complete meaning, the facts, the structure, the relationships, and the human reading gets that same meaning with the design on top. This is why formats that strip a website to plain text, like markdown for agents and llms.txt, matter. Its capability side is WebMCP, and its measurement side is Agent Experience Optimization.
آن لینک های داخل براکت در انتهای متن، همان «گراف» هستند. یک ایجنت هوشمند با دنبال کردن آن ها متوجه می شود که WebMCP زیرمجموعه معماری ماشین-محور است و llms.txt نیز ماهیتی مشابه دارد؛ چیزی که یک کپی ساده و تخت از صفحات من هرگز آن را به این وضوح بیان نمی کند. در سراسر این هشت فایل، کل ساختار مشخص است: مفاهیم و روابط بین آن ها.
البته پکیجی شبیه به این، در واقع کپی دومی از محتوای فعلی سایت است و داشتن یک کپی دوم، یعنی باید همیشه آن را همگام سازی (Sync) کنید. به محض اینکه سایت تغییر کند، این پکیج قدیمی می شود مگر اینکه آن را هم آپدیت کنید. این زحمتِ اضافه فقط مختص OKF نیست؛ این هزینه ای است که برای هر لایه موازیِ ماشین خوان (مثل فایل llms.txt، آینه ی مارک داون صفحات یا چنین پکیجی) باید بپردازید. دقتی که یک ایجنت در خواندن سایت شما دارد، دقیقاً به اندازه نظم شما در به روز نگه داشتن این لایه است.
گوگل OKF را برای این منظور نساخته است. هدف آن دانش داخلی شرکت است و هیچ چیز در برنامه های گوگل به وب سایت های عمومی اشاره نمی کند. بنابراین استفاده از آن برای ایجنت های بازدیدکننده از سایت، یک استفاده غیررسمی (Off-label) محسوب می شود و شاید همین طور هم باقی بماند. اما حتی بدون پاداشِ خوانده شدن توسط هوش مصنوعی، این کار ارزشش را داشت: نوشتن این پکیج مرا مجبور کرد تا به وضوح بیان کنم که سایت No Hacks چه می داند و ایده هایش چطور به هم متصل اند؛ و این کار باعث شد تا شکاف هایی را پیدا کنم که در حالت عادی و با نوشتن یک صفحه معمولی هرگز پیدا نمی کردم. این دقیقاً همان نظم موجود در «معماری ماشین-محور» است: معنای خود را در قالبی بریزید که ماشین بتواند بخواند، آن گاه متوجه می شوید که کجا مبهم صحبت کرده اید.
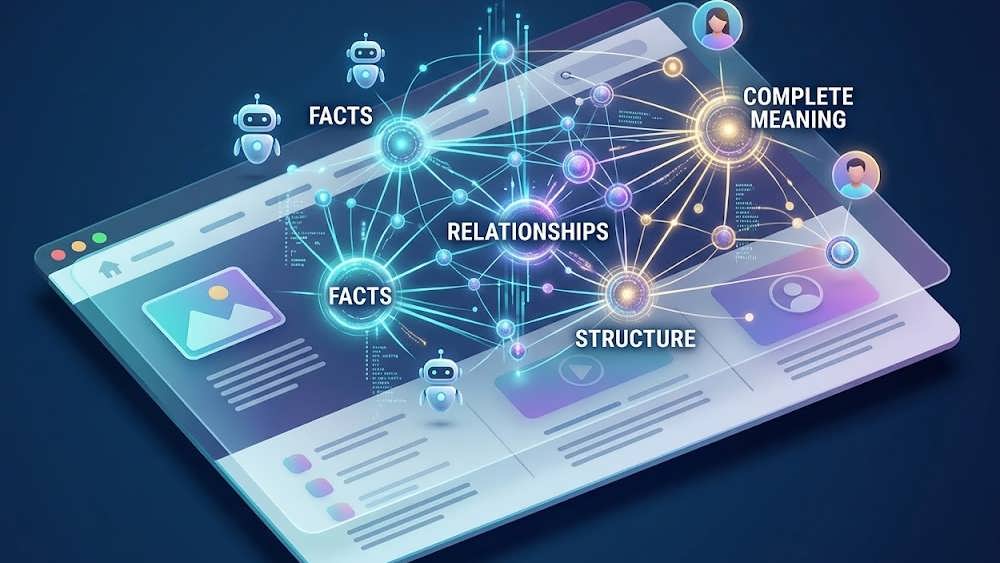
این تصویر سه بعدی، جوهر «معماری ماشین-محور» را نشان می دهد. ساختار دانش سایت به صورت یک شبکه گرافیکی عمیق (Complete Meaning) به عنوان منبع اصلی (Canonical Source) قرار دارد. بر روی این بستر، لایه طراحی و رندر گرافیکی (Human Experience) برای بازدیدکنندگان انسانی قرار گرفته است، دقیقاً همان طور که نویسنده مقاله تجربه کرد.
گراف دانش وب سایت ما را به کجا می برد؟
آنچه در ادامه می آید یک پیش بینی قطعی نیست، بلکه یک مسیر احتمالی است که کاملاً به این بستگی دارد که آیا ایجنت ها در آینده گراف دانش سایت ها را می خوانند یا خیر (که امروز هیچ کدام این کار را نمی کنند). اما دیدن این چشم انداز ارزشمند است:
- فایل هویتی می تواند به یک گراف دانش تبدیل شود: امروز، فایل
llms.txtتنها یک خط است که می گوید شما کیستید. یک پکیج منتشرشده ی OKF، نسخه کامل این ایده است: نقشه ای از تمام دانش سایت شما و نحوه اتصال بخش های مختلف آن. بنابراین، لایه نازک هویتی و لایه دانش ساختاریافته به یک موجودیت واحد تبدیل می شوند. - ایجنت ها می توانند به جای خزش (Scrape) صفحات، این نقشه را جستجو کنند: ایجنتی که پکیج شما را دریافت کرده و لینک هایش را دنبال می کند، درک بسیار تمیزتر و آگاهانه تری از روابط معنایی به دست می آورد تا ایجنتی که در حال تجزیه کدهای HTML شما صفحه به صفحه است. علاوه بر این، شما کنترل بیشتری روی نحوه بازنمایی مفاهیم خود توسط هوش مصنوعی خواهید داشت.
- این نقشه می تواند به لایه کانونیکال (Canonical) تبدیل شود: نسخه ای که ماشین می خواند، دیگر صرفاً یک کپی از سایت شما نخواهد بود، بلکه به «منبع اصلی» تبدیل می شود؛ و صفحاتی که انسان می بیند، تنها یک رندرِ گرافیکی از همان منبع خواهند بود. این دقیقاً همان وب سایتِ تماماً ماشین محوری است که رویای وبِ ایجنتیک (Agentic Web) به دنبال آن است. مسیری که از یک درِ فرعی که گوگل برای داده های داخلی اش باز کرده، قابل دسترس شده است.
مارک داون چیز جدیدی نیست
جان گروبر (John Gruber) در سال ۲۰۰۴ مارک داون را با کمک آرون سوارتز (Aaron Swartz) به عنوان تستر نسخه بتا خلق کرد. هدف اصلی طراحی آن «خوانایی» بود: متنی که بتوانید آن را همان طور که هست، بدون نیاز به رندر شدن بخوانید و در عین حال به تمیزی به HTML تبدیل شود. دو دهه بعد، مارک داون زیربنای گیت هاب (GitHub)، ردیت (Reddit)، بسیاری از مستندات نرم افزاری و حتی چت باکس های ابزارهای هوش مصنوعی را تشکیل می دهد. مارک داون به این دلیل پیروز شد که بدون نیاز به رندر شدن، خوانا بود؛ و این دقیقاً همان ویژگی است که خواندنش را برای یک ماشین (کامپیوتر) آسان می کند.
من طی ۱۵ سال گذشته (از زمانی که iA Writer در سپتامبر ۲۰۱۱ به اپلیکیشن اصلی نوشتن من تبدیل شد)، بیشتر متون خود را با مارک داون نوشته ام. بنابراین اینکه در یک هفته، وبِ ماشین خوان به سمت مارک داون همگرا شود، برای من یک ترفند جدید نیست، بلکه زمینی آشناست.
فرمت های ماشین محور دائماً به همین زمین بازی برمی گردند: فایل llms.txt، مارک داون کلادفلر و حالا OKF. خود گوگل هم در این باره یک صدا نیست. تیم جستجوی گوگل، نقش فایل llms.txt را در رتبه بندی «کاملاً گمانه زنی» خواند، اما تیم کروم آن را به عنوان یک چک لیست آمادگی برای ایجنت ها به ابزار Lighthouse اضافه کرد؛ و حالا تیم داده ی گوگل، OKF را منتشر کرده است.
اگر می خواهید بدانید وب سایت شما در چه وضعیتی قرار دارد، فقط سی ثانیه زمان می برد: مهم ترین صفحه سایت خود را باز کنید و محتوای آن را در یک ویرایشگر متن ساده (Plain-text) جای گذاری کنید؛ جایی که لینک ها به کلمات ساده تبدیل می شوند. حالا به آنچه باقی مانده نگاه کنید و ببینید آیا جمله ای وجود دارد که بگوید ایده های این صفحه چگونه به بقیه وب سایت شما مرتبط است؟ منظورم فقط لینک دادن یک صفحه به صفحه دیگر نیست، بلکه «ماهیتِ خود رابطه» است. معمولاً هیچ چیزی پیدا نمی کنید. این جای خالی، دقیقاً همان چیزی است که گراف دانش آن را پر می کند؛ چه سراغ OKF بروید و چه نه.
فرمت OKF خبر جدید این هفته است، اما بستر زیرین آن (یعنی متن ساده ای که ماشین بتواند آن را بخواند) از سال ۲۰۰۴ اینجا بوده است. چیزی که گوگل به آن اضافه کرد، فقط یک نام و یک استانداردِ مدون بود.
نتیجه گیری
ظهور فرمت هایی مانند OKF و توجه روزافزون به مارک داون نشان دهنده یک تغییر پارادایم اساسی در سئو است: گذار از وب سایت های صرفاً انسان خوان، به پلتفرم هایی که ذاتاً برای درک عمیقِ ماشین ها و هوش مصنوعی بهینه سازی شده اند. برای ماندن در عرصه رقابت دیجیتال، دیگر صرفاً تولید محتوای متنی کافی نیست؛ بلکه باید معماری اطلاعات سایت شما ساختاریافته و دارای روابط معنایی مشخص (گراف دانش) باشد. ما در آژانس دیجیتال مارکتینگ دانش وب، با بهره گیری از جدیدترین استانداردهای سئو تکنیکال و معماری داده، به شما کمک می کنیم تا وب سایت خود را نه تنها برای موتورهای جستجوی امروزی، بلکه برای ایجنت های هوش مصنوعی آینده (AEO) نیز بهینه سازی کنید و یک قدم از رقبای خود جلوتر باشید.