

بیش از دو دهه است که استراتژی دیجیتال حول یک هدف به ظاهر ساده می چرخد: کشاندن کاربران به صفحات وب. موتورهای جستجو به محتوای متنی پاداش می دادند، ابزارهای آنالیتیکس (Analytics) بازدید صفحات را معیار موفقیت می دانستند و بازاریابی دیجیتال بر پایه میزان تعامل (Engagement) می چرخید. با بالغ شدن سازمان ها، آن ها سرمایه گذاری های کلانی برای طراحی تجربه های دیجیتال پیچیده تر انجام دادند؛ تجربه هایی که مشتریان را در یک مسیر خرید با دقت تنظیم شده هدایت می کرد. در این رویکرد، اطلاعات به شکل کاملاً عمدی در ده ها و گاهی صدها صفحه به هم پیوسته توزیع می شد که هر کدام برای مرحله متفاوتی از سفر مشتری بهینه سازی شده بودند.
سفر مشتری یا بن بستِ هوش مصنوعی؟
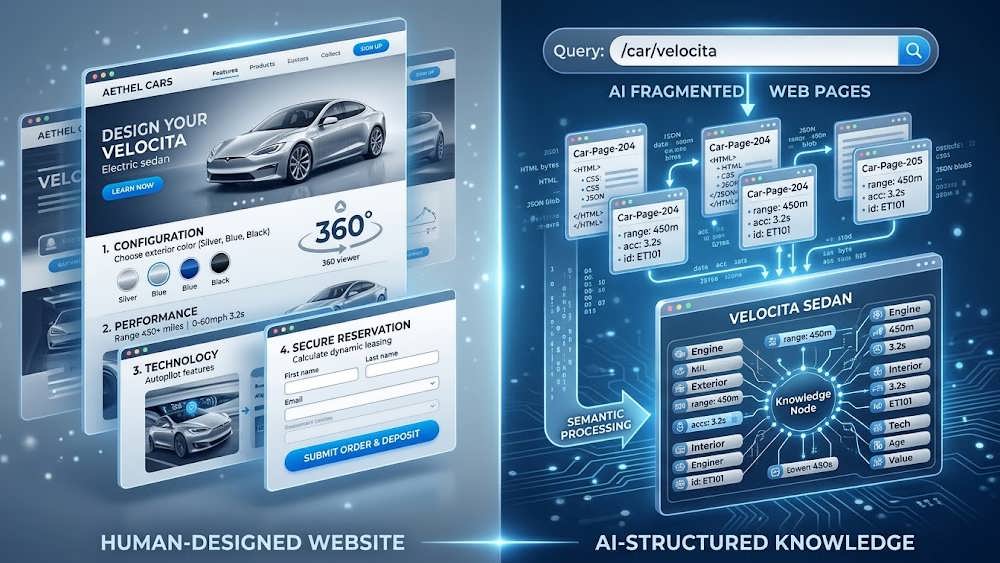
برای درک بهتر، در نظر بگیرید که شرکتی مانند فورد (Ford) چگونه مدل F-150 (یکی از پرفروش ترین خودروها در آمریکا) را به مخاطب معرفی می کند. فورد به جای ارائه یک صفحه جامع و طولانی از خودرو، خریداران احتمالی را با هوشمندی تمام در یک سفر احساسی که در هفت بخش (Viewport) متمایز پخش شده است، هدایت می کند. صفحه اصلی، سبک زندگی مرتبط با خودرو را تثبیت می کند. صفحات مدل، تیپ های مختلف را معرفی می کنند. پیکربندی های تعاملی (Configurators) به مشتریان اجازه می دهند مالکیت خودرو را در ذهنشان تجسم کنند. صفحات ویژگی ها، قدرت بکسل، عملکرد آفرود و پکیج های فناوری را توضیح می دهند. گالری های تصاویر، هویت برند را تقویت کرده و مشخصات فنی در لایه های عمیق تر سایت و در کنار پیشنهادهای منطقه ای و گزینه های تامین مالی قرار گرفته اند.
در ادبیات دیجیتال مارکتینگ به این ساختار، «قیف فروش» یا Funnel گفته می شود. ما در آژانس طراحی سایت و سئو دانش وب نیز بارها شاهد بوده ایم که این مدل طراحی برای کاربران انسانی معجزه می کند، زیرا مرحله به مرحله نیازها و احساسات کاربر را پاسخ می دهد.
برای انسان ها، این معماری به طرز چشمگیری عالی کار می کند. هر صفحه هدفی دارد، هر تعامل باعث ایجاد اعتماد می شود و هر کلیک، مشتری را به تصمیم گیری برای خرید نزدیک تر می کند. این یک تجربه انسانی بی نظیر است؛ اما برای «هوش مصنوعی»، همین معماری تبدیل به یک دست انداز و مانع (Friction) می شود.
تصویری از صفحه نتایج جستجوی گوگل (SERP) که پاسخ هوش مصنوعی (AI Overview) را نشان می دهد که به جای سایت اصلی برند، داده ها را از Reddit و مجلات خودرو ترکیب کرده است.
بحران خاموش حذف واسطه ها توسط هوش مصنوعی
آزمایشگاه های هوش مصنوعی مدام به مدیران سازمان ها می گویند که مدل های زبانی بزرگ آن ها (LLMs) آن قدر هوشمند هستند که می توانند هر معماری وب آشفته ای را خزش (Crawl) کنند، داده ها را ترکیب نمایند و فارغ از اینکه اطلاعات چگونه سازماندهی شده اند، پاسخ های دقیقی ارائه دهند. اما این پیام، واقعیت و نحوه کارکرد واقعی سیستم های بازیابی اطلاعات هوش مصنوعی را بیش از حد ساده انگاری می کند.
وقتی داده ها به صورت عمدی و برای درگیر کردن احساسات انسانی در چندین صفحه مختلف خرد و پراکنده می شوند، موتور ترکیبِ هوش مصنوعی از کار می افتد. از آنجا که ماشین پنجره ای برای درک بافت احساسی ندارد، صرفاً به دنبال یک «بسته معنایی با چگالی بالا و تأخیر کم» (High-density, low-latency semantic payload) می گردد؛ یعنی اطلاعاتی متمرکز، ساختاریافته و سریع. اگر هوش مصنوعی نتواند این بسته اطلاعاتی را به صورت بومی و یکپارچه در دامنه رسمی شرکت شما پیدا کند، به جای دیگری سرک می کشد. سپس، کامل ترین پاسخی را که می تواند، از منابعی که بازیابی، تطبیق و اعتماد به آن ها آسان تر است، مونتاژ می کند. پیامدهای این موضوع از همین حالا قابل مشاهده است.
یک جستجوی ساده مثل [میزان مصرف سوخت فورد F-150 رپتور]، نتیجه ای در قابلیت AI Overview گوگل تولید می کند که به جای خود سایت فورد، اطلاعات را از بحث های شبکه اجتماعی ردیت (Reddit)، سایت های مجلات خودرو و یک نمایندگی محلی استخراج کرده است.
فراتر از سئو: نبرد برای «حاکمیتِ محتوا»
فورد از قبل پاسخ تقریباً هر سؤال ممکنی را در سایت خود دارد. مسئله این نیست که اطلاعات وجود ندارد؛ مسئله این است که گوگل متوجه شده سرهم کردن پاسخ از سایت های Reddit، یک مجله خودرو و یک نمایندگی فروش، بسیار راحت تر از استخراج آن از سایت پیچیده خود فورد است. وقتی چنین اتفاقی می افتد، بحث دیگر بر سر رتبه بندی کلمات کلیدی (Rankings) یا بک لینک ها نیست. بحث بر سر این است که چه کسی کنترلِ تصویر معتبر برند شما را در دست دارد.
این دیگر صرفاً یک مشکل مربوط به سئو (SEO) نیست؛ بلکه یک مشکل «حاکمیت محتوا» است.
مشکل اینجاست که هوش مصنوعی صرفاً یک ضعف ساختاری را که سال ها وجود داشته، افشا کرده است. سازمان ها حضور دیجیتال خود را حول محور «صفحات وب» سازماندهی کردند، زیرا موتورهای جستجو به صفحات وب پاداش می دادند. به نوعی، جستجو تبدیل به یک مسیر انحرافی شد. سازمان ها به جای «سازماندهی دانشِ» خود، برای رتبه گرفتن اسناد متنی و ایجاد واکنش احساسی در کاربر بهینه سازی شدند. این رویکرد تا الان جواب می داد چون موتورهای جستجو، صفحات را برمی گرداندند. اما دستیارهای هوش مصنوعی تلاش می کنند تا یک تصویر منسجم از کل سازمان شما ترکیب و تولید کنند. در این مسیر، آن ها هر تناقض، هر رابطه گمشده و هر شکافی که در معماری زیربنایی سایت شما وجود دارد را برملا می کنند.
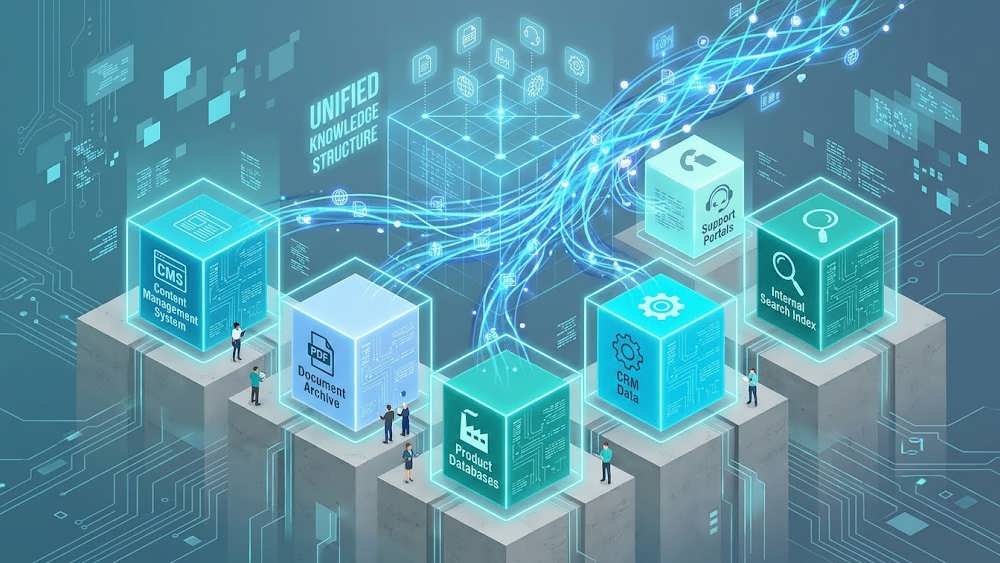
سازمان هایی که امروز در فضای دیجیتال دست وپا می زنند، معمولاً با کمبود اطلاعات مواجه نیستند. آن ها دانش عظیمی از محصولات، خدمات، سیاست ها و تخصص خود دارند. مشکل اینجاست که این دانش در میان صفحات وب، سیستم های مدیریت محتوا (CMS)، دیتابیس های محصول، کمپین های مارکتینگ، فایل های PDF، پورتال های پشتیبانی و مخازن دادهِ بی ارتباط به هم، تکه تکه شده است. انسان ها می توانند در این سیلوهای اطلاعاتی حرکت کنند، اما ماشین ها روزبه روز در انجام این کار ناتوان تر می شوند.
هوش مصنوعی این مشکل را به وجود نیاورده است؛ بلکه فقط نادیده گرفتن آن را غیرممکن کرده است.
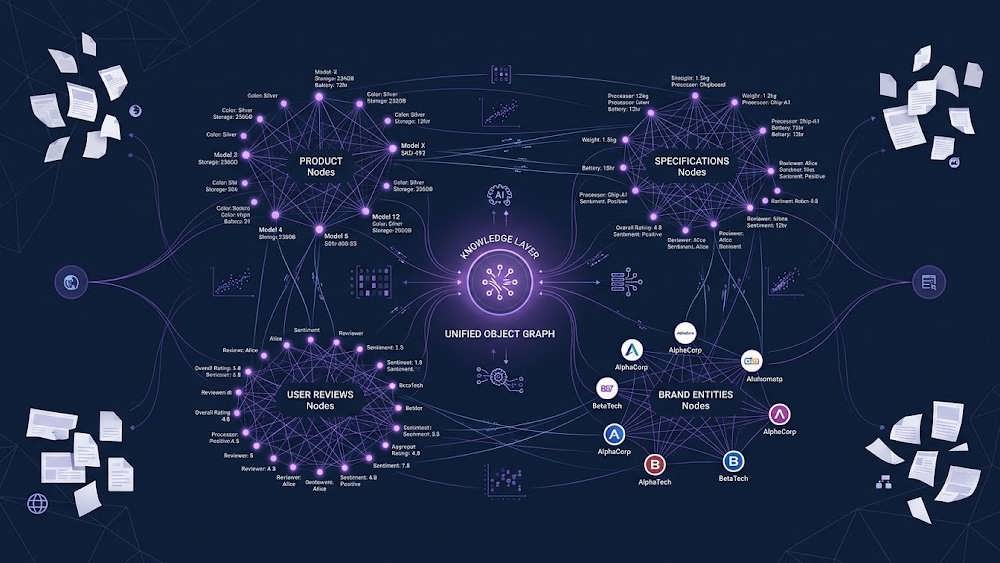
انیمیشن یا طرح برداری دایره ای که در آن یک محصول در مرکز قرار دارد و به دیتابیس های پشتیبانی، مشخصات فنی، نظرات، گارانتی و قیمت متصل شده و یک لایه دانشی خوانا برای ماشین ایجاد کرده است.
حاکمیت برند به یک مسئولیت کلان مدیریتی تبدیل می شود
سال ها پیش فرصتی داشتم تا به شرکت دِل (Dell) مشاوره دهم. در آنجا مایکل دِل (بنیان گذار شرکت) رویکردی از رهبری دیجیتال را به نمایش گذاشت که امروز حتی از آن زمان هم مرتبط تر و حیاتی تر به نظر می رسد. او به طور مرتب جستجوی گوگل و تجربه جستجوی داخلی سایت Dell را شخصاً آزمایش می کرد. نه به این خاطر که می خواست در کار تیم های مارکتینگ یا تکنولوژی دخالت خُرد (Micromanage) کند، بلکه چون چیزی را می فهمید که بسیاری از مدیران نادیده می گرفتند: «رابط کاربری که مشتریان از طریق آن محصولات شما را کشف می کنند، در نهایت نحوه درک آن ها از شرکت شما را شکل می دهد.»
بسیاری از مدیران کسب وکارها در ایران، بررسی جایگاه سایت را صرفاً وظیفه سئوکار می دانند؛ در حالی که حضور دقیق و درست برند در نتایج هوش مصنوعی و گوگل، مستقیماً به اعتبار و ارزش ویژه برند (Brand Equity) گره خورده است.
اگر مایکل دل یا یک مشتری محصولی را جستجو می کرد و نمی توانست پاسخ درست را پیدا کند، او این را یک مشکل فنی ساده و ایزوله نمی دید؛ بلکه آن را یک «شکست سازمانی» تلقی می کرد. این طرز فکر در عصر هوش مصنوعی بسیار مهم تر شده است.
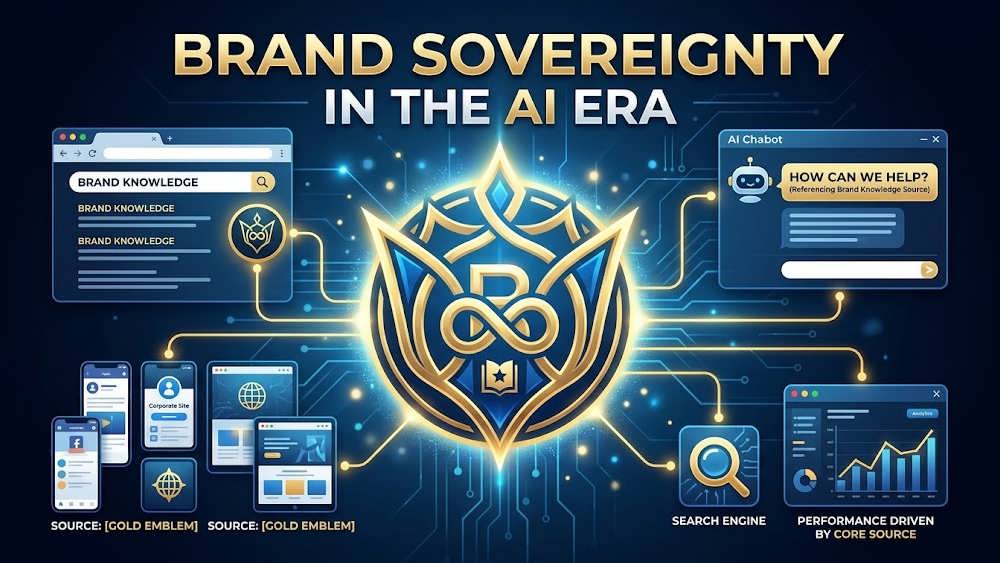
من به این مفهوم حاکمیت برند (Brand Sovereignty) می گویم: توانایی یک سازمان برای باقی ماندن به عنوان منبع معتبر و مرجع برای اطلاعات مربوط به محصولات، خدمات و تخصص خودش، فارغ از اینکه آن پاسخ ها در نهایت کجا و چگونه (توسط سرچ سنتی یا چت بات ها) به کاربر تحویل داده می شوند. سال ها موفقیت دیجیتال با این معیار سنجیده می شد که سازمان ها چقدر در جذب بازدیدکننده به سایتشان موفق بوده اند. اما از این پس، سؤال بسیار مهم تری مطرح خواهد شد: «آیا سیستم های هوش مصنوعی به طور پیوسته سازمان شما را به عنوان بهترین منبع برای آن اطلاعات به رسمیت می شناسند؟»
این چالشی نیست که تیم های بازاریابی، سئو یا فناوری بتوانند به تنهایی حل کنند؛ زیرا هیچ کدام از این تیم ها تصویر کامل را در اختیار ندارند. اطلاعات محصول، مستندات، پشتیبانی مشتری، سیاست های حقوقی و بخش فروش (Commerce)، همگی در نحوه نمایش دیجیتال یک سازمان نقش دارند. بنابراین، بازپس گیری حاکمیت برند دیگر به معنای «انتشار محتوای بیشتر» نیست، بلکه به معنای «سازماندهی دانش سازمانی» است تا این اجزا به جای رقابت با یکدیگر، هم افزایی داشته باشند و یکدیگر را تقویت کنند.
گذر از صفحات وب به سمت «پایگاه دانش»
اکثر سازمان ها از همان ابتدا قصد نداشتند دانش خود را پراکنده کنند. این اتفاق به تدریج رخ داد. هر پروژه جدید، یک صفحه جدید، یک میکروسایت، یک مخزن محتوای متفاوت یا سیستمی برای حل یک مشکل خاص تجاری به سیستم اضافه کرد. با گذشت زمان، اطلاعات محصول، محتوای بازاریابی، پشتیبانی مشتری، قوانین و فروش به صورت مستقل تکامل یافتند؛ در حالی که وب سایت شرکتی مسئول بود تا همه این ها را به یک تجربه منسجم برای مشتری پیوند بزند.
این رویکرد جواب می داد چون وبِ سنتی بر اساس «ناوبری و لینک دهی» کار می کرد. مشتریان می توانستند بین صفحات حرکت کنند و موتورهای جستجو می توانستند مرتبط ترین سند را بازیابی کنند. هیچ کدام از این دو، نیازی نداشتند که سازمان به طور صریح و ساختاریافته روابط بین محصولات، خدمات، قوانین و تخصص هایش را برای ماشین تعریف کند.
هوش مصنوعی محدودیت های این مدل را برملا می کند. مدل های زبانی بزرگ سعی نمی کنند مانند انسان ها در وب سایت ها بگردند. آن ها تلاش می کنند با بازسازی روابط بین محصولات، خدمات، مستندات، مکان ها، تخصص ها و شواهد پشتیبان، سازمان ها را درک کنند. هر پاسخی که توسط یک دستیار هوش مصنوعی تولید می شود، نمایانگر تلاشی برای جمع آوری این درک از اطلاعات موجود است. وقتی این روابط به صورت ضمنی (غیرشفاف) باقی می مانند و در صدها صفحه وب، پایگاه داده و مخازن جداگانه توزیع می شوند، تصویری که هوش مصنوعی می سازد ناقص یا متناقض خواهد بود.
راه حل، انتشار محتوای بیشتر نیست. راه حل، سازماندهی متفاوتِ دانش از طریق یک مدل معماری جدید است.
پایانِ عصرِ صفحاتِ جزیره ای
اینجاست که اهمیت خدمات نوین ما در دانش وب روشن می شود. ما به کسب وکارها کمک می کنیم تا ساختار داده های خود را تغییر دهند.) سازمان ها به جای اینکه محصولات، خدمات، نظرات، پیشنهادها و منابع پشتیبانی را به عنوان دارایی های محتواییِ مستقل در نظر بگیرند، باید مدیریت آن ها را به عنوان «موجودیت های تجاری به هم پیوسته» در یک گراف اشیای یکپارچه (Unified Object Graph) آغاز کنند. در این گراف، هر موجودیت هویت خود را حفظ می کند در حالی که به صورت واضح به تمام اشیای مرتبط در سراسر سازمان متصل است. یک محصول به مستندات فنی، لوازم جانبی سازگار، اطلاعات گارانتی، موجودی انبار، نظرات مشتریان، نمایندگی ها و مکان های خدمات پس از فروش خود متصل می شود. در این معماری، «صفحه وب» تنها به یکی از روش های نمایش این روابط تبدیل می شود، نه مکانی که این روابط تازه در آن خلق می شوند (در واقع سایت، خروجیِ این پایگاه دانش است.
یکی از سؤالاتی که مکرراً می شنوم این است که: «آیا این کار به معنای دور ریختن سیستم های فعلی سایت است؟» در بیشتر موارد، خیر! سازمان ها از قبل سرمایه گذاری سنگینی روی سیستم های مدیریت اطلاعات محصول، CMS (مثل وردپرس)، پلتفرم های فروشگاهی و ابزارهای پشتیبانی مشتری انجام داده اند. این سیستم ها باید به عنوان مرجع اطلاعاتی که به بهترین شکل مدیریت می کنند، باقی بمانند. چالش اینجاست که هیچ کدام از آن ها کل سازمان را به تنهایی نمایندگی نمی کنند.
سازمان ها به جای تلاش برای ادغام همه چیز در یک پلتفرم واحد، باید بر ایجاد یک «لایه دانشِ قابل خواندن برای ماشین» (Machine-readable Knowledge Layer) تمرکز کنند که این قطعات را گرد هم می آورد. به کمک داده های ساختاریافته (Structured Data) و تکنیک های پیشرفته سئو معنایی، اطلاعات سر جای خودشان می مانند، اما در یک تصویر یکپارچه تجمیع می شوند که روابط تجاری را برای هوش مصنوعی توصیف می کند.
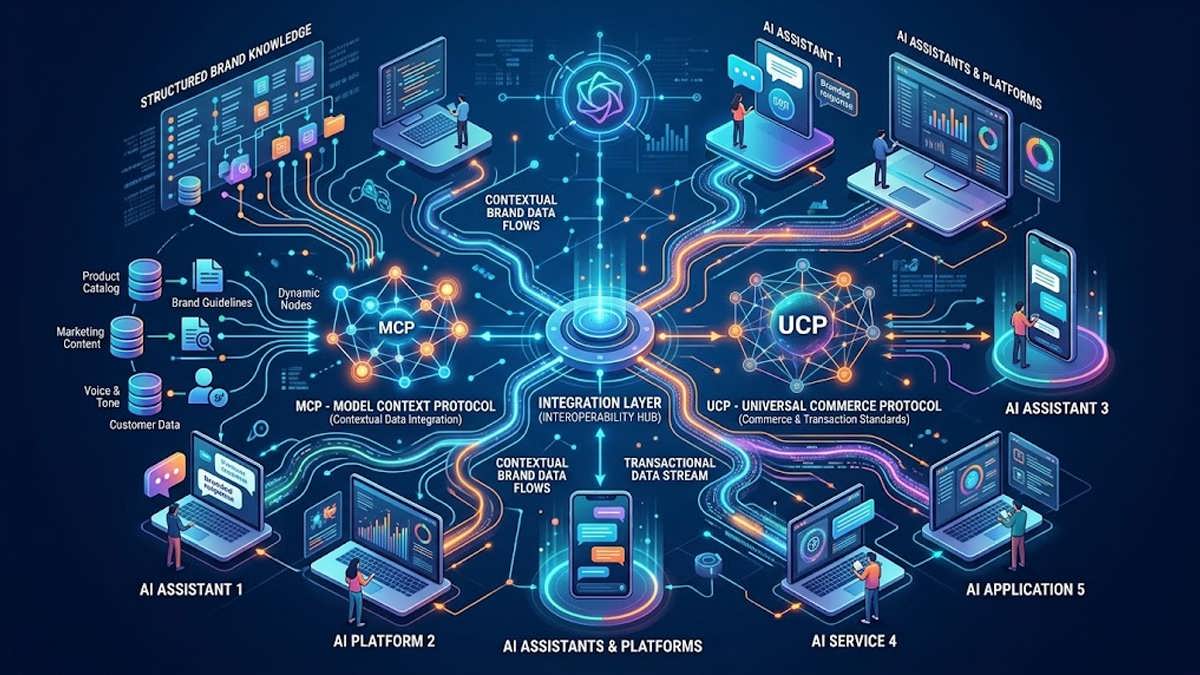
هنگامی که این لایه ایجاد شود، بازی عوض می شود. انتشار روی یک وب سایت، ارائه یک API خروجی، تولید داده های ساختاریافته، پشتیبانی از اتصال MCP (پروتکل ارتباط ماشین با مدل های زبانی) یا پذیرش هر پروتکل جدیدی که در آینده می آید، همگی به روش های متفاوتی برای بیانِ همان «دانش زیربنایی واحد» تبدیل می شوند، نه پروژه های پیاده سازی جداگانه.
این همان تغییر معماری بزرگی است که هوش مصنوعی به ما نشان داده است. سال ها ما کانال های دیجیتال را جداگانه مدیریت می کردیم و سایت را جایی می دانستیم که همه چیز در آن جمع می شود. اما از این پس، سازمان ها دانش خود را به صورت مرکزی مدیریت خواهند کرد و به هر رابط کاربری (چه وب سایت، چه پورتال پشتیبانی، چه دستیارهای هوشمند AI) اجازه می دهند از همان نماینده معتبر تغذیه کنند.
طرحی گرافیکی که نشان می دهد چطور یک مسیر خرید چند مرحله ای (مانند ۷ مرحله معرفی خودرو فورد F-150) برای انسان جذاب است اما برای الگوریتم های هوش مصنوعی ایجاد پیچیدگی می کند.
ایموتی فکت: ترکیب فکت فنی و زبان احساسی
این تغییر، شیوه تولید محتوا را نیز دگرگون می کند. امروزه بیشتر سازمان ها، دقت اطلاعات فنی را از زبان بازاریابی جدا می کنند؛ زیرا تیم های مختلفی مسئول بخش های مختلف داستان هستند. سیستم مدیریت محصول به مشخصات فنی می پردازد، تیم خلاقیت پیام های تبلیغاتی را می نویسد، تیم سئو کلمات کلیدی مشتریان را تحقیق می کند و پشتیبانی نیز سؤالات متداول را مستند می کند. هر گروه ارزش آفرینی می کند، اما به محض اینکه این محتوا از تیم سازنده اش خارج می شود، ارتباط و یکپارچگیِ آن دانش از بین می رود.
با این حال، مصرف کنندگان هنگام تصمیم گیری، فکت ها (حقایق) را از احساسات جدا نمی کنند. مشتری که عباراتی نظیر [ایمن ترین شاسی بلند خانوادگی]، [وانتی که در آفرود مهارنشدنی حس می شود] یا [هتلی دنج و آرام برای کار ریموت] را جستجو می کند، دقیقاً در حال ترکیب کردن نیازمندی های عینی (Objective) با انتظارات ذهنی و احساسی (Subjective) در یک پرسش واحد است. روزبه روز از سیستم های هوش مصنوعی نیز انتظار می رود که این عباراتِ ترکیبی از قصد کاربر (Intent) را به همین شکل تفسیر کنند.
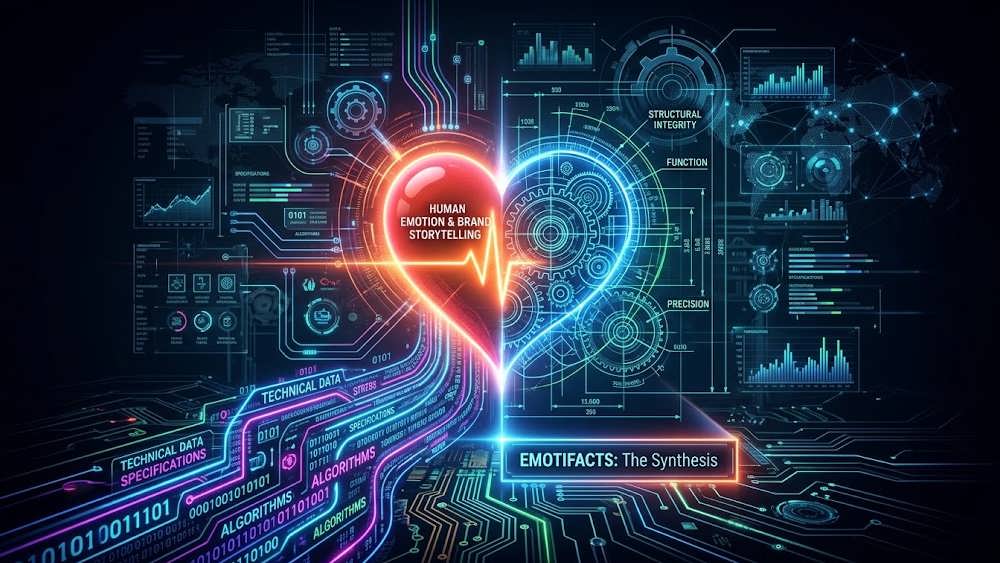
در مجموعه بیسان دیجیتال (Bisan Digital)، ما به این مفهوم Emotifacts (ترکیب Emotion به معنای احساس و Fact به معنای واقعیت) می گوییم. این مفهوم در این فرآیند بسیار ارزشمند می شود، زیرا ویژگی های واقعی محصول را با زبان احساسی که مشتریان به طور طبیعی برای توصیف، کشف و در نهایت انتخاب محصولات به کار می برند، ترکیب می کند. به جای اینکه پیام های احساسی را صرفاً یک کپی رایتینگ خلاقانه بدانیم که روی مشخصات فنی چسبانده شده است، هر دوی این ها باید به عنوان بخشی از یک «موجودیت دانشیِ قابل استفاده مجدد» در نظر گرفته شوند.
اگر بازاریابی، فورد رپتور را با مفاهیمی مثل آزادی، اعتمادبه نفس و استقلال خشن جایگاه سازی می کند، این ایده ها باید به طور صریح به شواهد مهندسی که از آن ها پشتیبانی می کنند (مانند سیستم تعلیق، قدرت موتور، ظرفیت بکسل و سیستم مدیریت زمین) متصل شوند. وعده احساسی و اثبات فنی، یکدیگر را تقویت می کنند زیرا از یک منبع مشترک سرچشمه می گیرند. همین اصل، فراتر از صنعت خودرو نیز صدق می کند. یک هتل لوکس باید وعده «آرامش» خود را به موقعیت مکانی اتاق، عایق صوتی، امکانات رفاهی و نظرات واقعی مهمانان گره بزند.
این به معنای گذر گسترده تر از «انتشار دیجیتال» به سمت «معماری دانش» است. ماشین ها می توانند بسیاری از چیزها را استنتاج کنند، اما نباید انتظار داشت که روابطی را که خود سازمان ها به عنوان حقایق می دانند، به تنهایی حدس بزنند. به طور فزاینده ای، مزیت رقابتی در اختیار سازمان هایی خواهد بود که این روابط را به طور صریح (Explicit) تعریف کرده، آن ها را با ثبات مدیریت می کنند و در دسترس هر سیستم هوشمند یا رابط کاربری قرار می دهند.
اینفوگرافیک جذابی که چگونگی اتصال مشخصات فنی محصول (مانند سیستم تعلیق آفرود) را به واژه های احساسی و قصد جستجوی کاربر (مانند حس حس آزادی و امنیت) نمایش می دهد.
ساختن برای انطباق پذیری به جای وابستگی به استانداردها
زمانی که «دانش» از «نحوه نمایش» مستقل شود، ارائه آن به انسان ها و ماشین ها بسیار آسان تر می گردد. دقیقاً در همین نقطه است که بسیاری از بحث های امروز پیرامون قابلیت همکاری (Interoperability) هوش مصنوعی متمرکز شده است. تقریباً هر ماه پروتکل ها، APIها و مکانیزم های کشفِ جدیدی ظهور می کنند، زیرا سازمان ها در حال رقابت برای تعیین این هستند که دستیارهای هوش مصنوعی چگونه باید به اطلاعات معتبر تجاری آن ها دسترسی پیدا کنند.
استانداردهای نوظهوری مانند MCP (پروتکل ارتباطی بستر مدل های هوش مصنوعی) نمایانگر یک تغییر مهم به سمت ایجاد رابط های صریح ماشینی هستند. امروز ممکن است استاندارد روی بورس MCP باشد و فردا استاندارد دیگری جایگزین شود. هدف این نیست که پیش بینی کنیم کدام پروتکل برنده خواهد شد؛ بلکه هدف این است که سازمانِ دانش خود را به گونه ای شکل دهیم که از طریق هر استانداردی که در نهایت غالب می شود، قابل ارائه باشد.
همین اصل برای فروش اینترنتی (Commerce) نیز صدق می کند. ابتکارات نوظهوری مانند UCP (پروتکل تجارت جهانی گوگل) نشان می دهند که چگونه دانشِ ساختاریافتهِ محصولات می تواند مستقیماً به جریان های خرید به کمک هوش مصنوعی وارد شود. اینکه آیا UCP به پروتکل غالب تبدیل می شود یا نه، اهمیت کمتری نسبت به این موضوع دارد که اطمینان حاصل کنیم دانش زیربنایی ما آن قدر خوب ساختار یافته است که در هر اکوسیستم معاملاتی جدیدی بتواند مشارکت کند.
این تمایز بین «معماری» و «پیاده سازی» همیشه مهم بوده، اما به ندرت به اندازه امروز آشکار بوده است. سازمان هایی که همچنان با سایت خود به عنوان تنها مخزن اصلی دانش تجاری رفتار می کنند، متوجه می شوند که باید مدام خود را با رابط ها، پروتکل ها و مدل های بازیابی جدید وفق دهند (و همیشه یک قدم عقب هستند). اما سازمان هایی که به جای آن، روی «دارایی های دانشی خوش ساختار و قابل استفاده مجدد» سرمایه گذاری می کنند، کشف خواهند کرد که پشتیبانی از مکانیزم های تحویل جدید، صرفاً یک کار مهندسی جزئی است، نه یک تحول و بحران بنیادین در سازمان.
بنابراین، بحث نباید با پشتیبانی از پروتکل های خاصی مثل MCP یا UCP آغاز شود. بلکه باید با یک سؤال اساسی تر شروع شود: «آیا سازمان ما نمایشی منسجم و معتبر از دانشِ خود دارد که کاملاً مستقل از رابط هایی (مثل مرورگر و سایت) باشد که آن دانش را ارائه می دهند؟» هر پروتکلی که در دهه آینده معرفی شود، صرفاً به یک پنجره جدید تبدیل خواهد شد که این دانش می تواند از طریق آن بیان شود.
تصویر متصل کننده ای که هسته اصلی دانش سازمان را در مرکز نشان می دهد که به صورت هوشمند به کانال های مختلف مانند وب سایت، پروتکل MCP، پروتکل فروشگاه UCP و چت بات ها خروجی می دهد.
معیار جدید برای سنجش موفقیت دیجیتال
در بیشتر تاریخ وب، موفقیت دیجیتال با مجموعه ای آشنا از معیارها سنجیده می شد: رتبه بندی کلمات (Rankings)، ترافیک وب سایت، بازدید صفحات، نرخ تعامل و نرخ تبدیل. این معیارها همچنان ارزشمند باقی می مانند، زیرا وب سایت ها همچنان نقش مهمی در نحوه ارتباط سازمان ها با مشتریان ایفا خواهند کرد. اما با این حال، آن ها دیگر تنها معیار اثربخشی دیجیتال نیستند.
همزمان که دستیارهای هوش مصنوعی به طور فزاینده ای به واسطه ای بین سازمان ها و مصرف کنندگان تبدیل می شوند، سؤال جدیدی مطرح می شود: وقتی یک سیستم هوشمند به سؤالی درباره شرکت، محصولات یا تخصص شما پاسخ می دهد، آیا آن پاسخ از دانش ساختاریافته خودِ سازمان شما سرچشمه می گیرد، یا از تفسیر شخص دیگری از آن؟ این همان تمایزی است که «حاکمیت برند» را تعریف می کند.
سازمان هایی که در طول دهه آینده موفق می شوند، لزوماً آن هایی نیستند که محتوای بیشتری نسبت به رقبایشان منتشر می کنند یا پیچیده ترین وب سایت ها را می سازند. بلکه آن هایی هستند که درک کرده اند استراتژی دیجیتال دیگر حول محور «اسناد و صفحات» نمی چرخد، بلکه روی خودِ «دانش» متمرکز است. صفحات وب، اپلیکیشن های موبایل، تجربیات پشتیبانی مشتری، دستیارهای هوش مصنوعی و فناوری هایی که هنوز اختراع نشده اند، همگی به جلوه های متفاوتی از یک پایه و اساسِ معتبر تبدیل خواهند شد.
عصر موتورهای جستجو به سازمان ها یاد داد که چگونه «صفحات وب» بهتری بسازند؛ اما عصر هوش مصنوعی دارد به آن ها می آموزد که چگونه «دانش» بهتری خلق کنند.
برندگان عصر هوش مصنوعی، آن هایی نیستند که بیشترین صفحات وب را دارند. بلکه سازمان هایی خواهند بود که ساختاریافته ترین دانش را در اختیار دارند. وب سایت شما دیگر دارایی اصلی دیجیتال شما نیست؛ دانش شماست. وب سایت صرفاً یکی از روش های ارائه این دانش است.
نتیجه گیری
با ورود قدرتمند هوش مصنوعی به عرصه جستجو و پردازش اطلاعات، قواعد بازی دیجیتال مارکتینگ و سئو برای همیشه تغییر کرده است. همان طور که در این مقاله اشاره شد، دیگر نمی توان صرفاً با تولید مقالات طولانی و پراکنده کردن اطلاعات در صفحات مختلف سایت، جایگاه برند را در ذهن کاربر و هوش مصنوعی تثبیت کرد. کسب وکارهای ایرانی برای بقا و پیشتازی در این اکوسیستم جدید، باید از تفکر سنتیِ «سایت محور» عبور کرده و به سمت تفکر «دانش محور» حرکت کنند. ایجاد پایگاه های داده ساختاریافته (Knowledge Graphs)، استفاده صحیح از اسکیماها (Schema Markups) و یکپارچه سازی محتوای فنی با ادبیات بازاریابی، کلید واکسینه کردن برند در برابر تغییرات الگوریتمی است. ما در تیم دانش وب در کنار شما هستیم تا این گذار حیاتی را به شکلی اصولی پیاده سازی کنیم؛ به طوری که سایت فعلی شما به یک موتور تولید و عرضه دانشِ قابل درک برای ماشین ها تبدیل شود و حاکمیت برند شما در تمامی موتورهای جستجو و چت بات های هوش مصنوعی با قدرت حفظ گردد.