

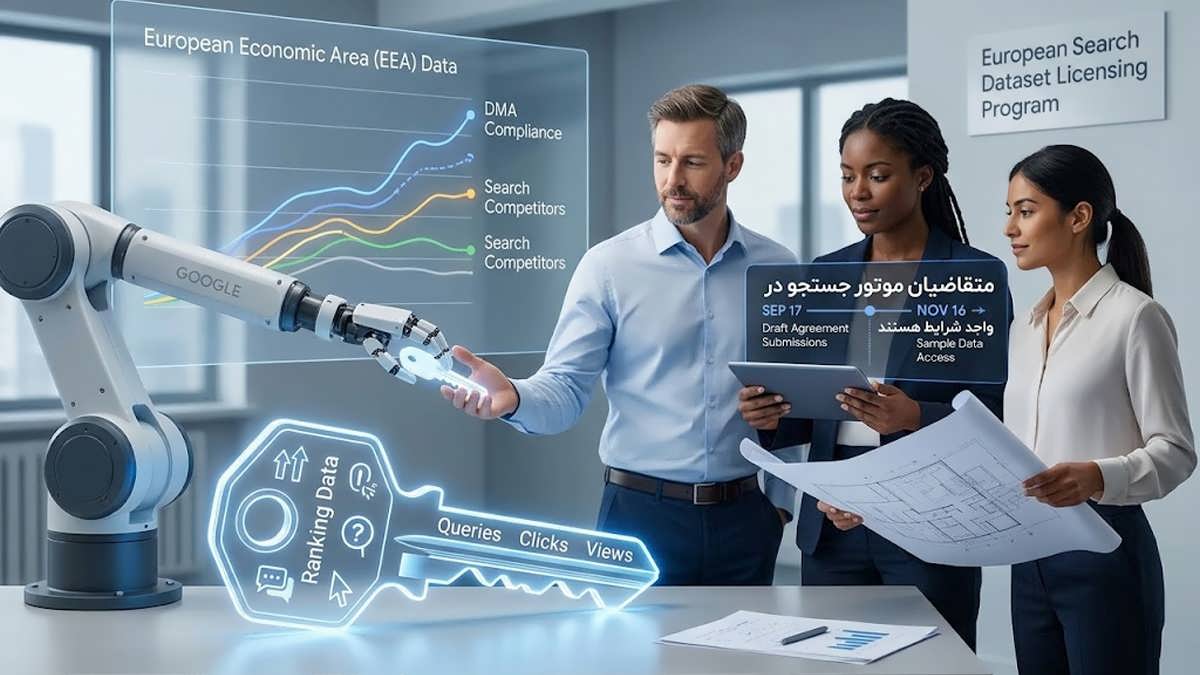
گوگل مستندات مربوط به «برنامه اعطای مجوز مجموعه داده های جستجوی اروپا» (European Search Dataset Licensing Program) را بازنگری کرده و اطلاعات دقیقی در این باره ارائه داده است که رقبای واجد شرایط چگونه می توانند به داده های رتبه بندی، پرس و جوها (کوئری ها)، کلیک ها و بازدیدهای حاصل از جستجو در «منطقه اقتصادی اروپا» (EEA) دسترسی پیدا کرده و مجوز آن را دریافت کنند.
این صفحه رسمی که در تاریخ ۳۱ آگوست به روزرسانی شده است، شامل الزامات احراز صلاحیت، مجموعه داده های نمونه، فرآیندهای ممیزی فنی و مهلت های زمانی کلیدی است. این اقدام گوگل در راستای اجرای تصمیم الزام آور کمیسیون اروپا است که در ماه جولای بر اساس «قانون بازارهای دیجیتال» (Digital Markets Act یا به اختصار DMA) تصویب شد؛ قانونی که گوگل را موظف می کند داده های ناشناس سازی شده (Anonymized) جستجوی خود را با رقبا—از جمله چت بات های هوش مصنوعی که بر اساس این قانون در دسته موتورهای جستجوی آنلاین قرار می گیرند—به اشتراک بگذارد.
بر اساس این جدول زمانی، ارسال پیش نویس توافق نامه های مجوز از تاریخ ۱۷ سپتامبر آغاز شده و نمونه داده ها نیز از ۱۶ نوامبر در دسترس متقاضیان قرار خواهد گرفت.
چه کسانی می توانند برای دریافت داده ها درخواست دهند؟
متقاضیان برای بهره مندی از این داده ها باید شرایط و معیارهای یک «موتور جستجوی آنلاین» را مطابق با قانون DMA دارا بوده و کاربران مستقر در منطقه اقتصادی اروپا را هدف قرار داده باشند. علاوه بر این، متقاضیان نباید تحت کنترل نهادهای دولتیِ خارج از منطقه اقتصادی اروپا باشند یا در فهرست تحریم های اتحادیه اروپا قرار داشته باشند.
معیارهای اصلی احراز صلاحیت:
- تعداد کاربران: تمامی متقاضیان باید در طول یک سال گذشته، به طور میانگین حداقل ۵۰ هزار کاربر فعال ماهانه در اتحادیه اروپا برای سرویس جستجوی خود داشته باشند.
- سابقه فعالیت یا سرمایه گذاری: متقاضیان باید حداقل به مدت دو سال متوالی خدمات جستجو در اتحادیه اروپا ارائه کرده باشند؛ یا در صورتی که به تازگی وارد این بازار شده اند (کسب وکارهای نوپا)، باید بیش از ۵۰ میلیون یورو سرمایه گذاری مالی جذب کرده باشند.
گوگل حق درخواست اسناد و مدارک پشتیبان را برای راستی آزمایی این معیارها محفوظ داشته و اعلام کرده است که ظرف مدت ۷ روز تقویمی به درخواست های اولیه متقاضیان پاسخ خواهد داد.
این تصویر به طور مفهومی نشان می دهد که چگونه طبق قانون DMA، رقبای واجد شرایط در اروپا می توانند از سپتامبر پیش نویس توافق نامه های دریافت مجوز داده های جستجو (Ranking, Queries, Clicks, Views) را ارسال کرده و در نوامبر به نمونه داده ها دسترسی پیدا کنند. جان مولر با استفاده از یک ذره بین بر روی یک لاگ بوک، این نکته فنی کلیدی را به عنوان بخشی از فرآیند حسابرسی (Audit) برای وب مسترها توضیح می دهد.
نمونه داده ها و تاریخ های کلیدی
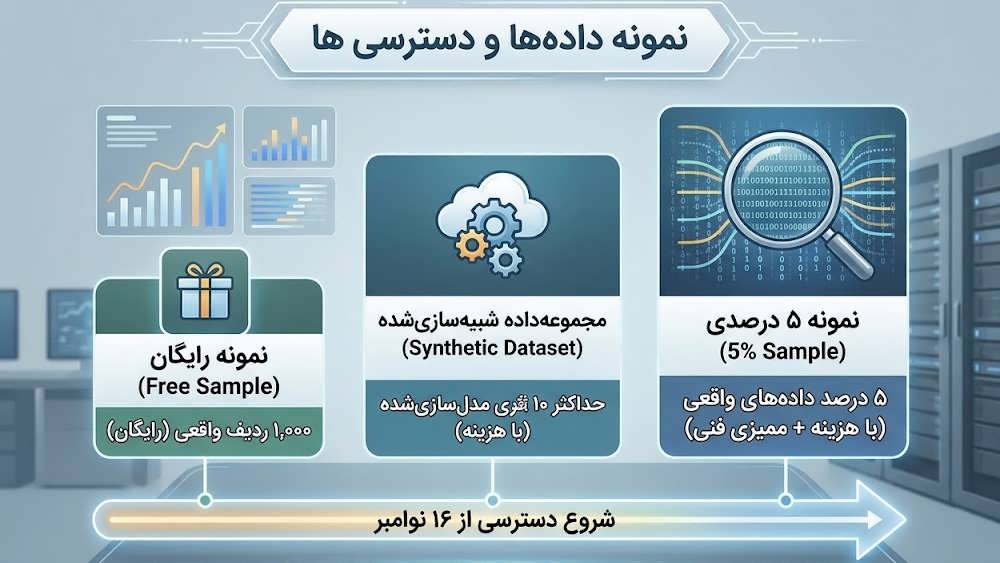
متقاضیان واجد شرایط می توانند پیش از خرید دسترسی کامل به کل مجموعه داده (Full Dataset)، نمونه هایی از آن را درخواست کنند:
- نمونه رایگان (Free Sample): شامل ۱,۰۰۰ ردیف داده واقعی به صورت رایگان.
- مجموعه داده شبیه سازی شده (Synthetic Dataset): شامل حداکثر ۱۰ میلیون کوئری به همراه داده های مدل سازی شده (با پرداخت هزینه).
- نمونه ۵ درصدی (5% Sample): دسترسی به ۵ درصد از کل داده های واقعی جستجو (با پرداخت هزینه).
دسترسی به هر سه نوع نمونه داده از تاریخ ۱۶ نوامبر امکان پذیر خواهد بود.
کارمزدها و هزینه های تعیین شده برای این مجموعه داده ها بر اساس اصول منصفانه، منطقی و غیرتبعیض آمیز (FRAND) تعیین می شوند. طبق دستورالعمل های کمیسیون اروپا، این هزینه ها تنها به هزینه های نهاییِ آماده سازی و انتقال داده ها به اضافه یک حاشیه سود مشخص محدود خواهد بود.
الزامات و فرآیند حسابرسی (Audit Requirements)
دسترسی به نمونه ۵ درصدی و همچنین مجموعه داده کامل، نیازمند انجام یک ارزیابی و حسابرسی مستقل فنی است. اگرچه نمونه های کوچک تر (نمونه رایگان و نمونه شبیه سازی شده) نیازی به ممیزی کامل ندارند، اما گوگل همچنان صلاحیت اولیه متقاضیان را به دقت بررسی می کند.
- گزارش سطح ۱ (Level 1 Report): یک حسابرس مستقل، زیرساخت های فنی متقاضی، محل ذخیره سازی داده ها و جریان های کاری (Workflows) را به دقت ارزیابی می کند. این گزارش تضمین می کند که متقاضی برنامه ای واقعی و قابل اعتماد برای استفاده از داده ها در محصول جستجوی خود دارد و تدابیر امنیتی آن برای حفاظت از داده ها به درستی طراحی شده است.
- گزارش های دوره ای سطح ۲ (Level 2 Reports): برای حفظ دسترسی مداوم، دریافت کنندگان داده باید با نظارت مستمر یک حسابرس مستقل موافقت کنند. این گزارش ها بررسی می کنند که آیا کنترل ها و پروتکل های امنیتی در عمل نیز به درستی کار می کنند یا خیر. اولین گزارش سطح ۲ باید ظرف مدت ۶ ماه پس از اعطای دسترسی ارائه شود و گزارش های بعدی به صورت سالانه ارسال خواهند شد.
این ممیزی ها از اهمیت فوق العاده ای برخوردارند زیرا داده های جستجو ماهیتی حساس دارند. با اینکه کمیسیون اروپا معتقد است نگهداری داده ها در سیستم های بسته و امن خودِ شرکت های متقاضی می تواند الزامات ناشناس سازی قانون DMA را برآورده کند، اما اثبات این موضوع بر عهده متقاضی است.
در دنیای مارکتینگ و سئو مدرن، دسترسی به رفتار جستجوی کاربران و الگوهای کلیک، کلید بهینه سازی الگوریتم ها و تدوین استراتژی های پیشرفته است. تحلیل دقیق همین کلان داده هاست که پایه و اساس خدمات سئو داده محور و طراحی وب سایت های هوشمند را در مجموعه های تخصصی نظیر دانش وب شکل می دهد تا کسب وکارها بتوانند بهترین بازدهی را از ترافیک ارگانیک به دست آورند.
چرا این موضوع اهمیت دارد؟
در ماه جولای، زمانی که معیارهای کلی و چارچوب زمانی مشخص شد، تصمیم الزام آور اتحادیه اروپا مورد بحث قرار گرفت. اما این مستندات جدید، آن چارچوب کلی را تبدیل به یک فرآیند اجرایی با تاریخ ها و مراحل مشخص کرده است.
نکته حائز اهمیت این است که ممیزی سخت گیرانه سطح ۱ تنها برای نمونه ۵ درصدی و کل مجموعه داده الزامی است و دو نمونه کوچک تر نیازی به آن ندارند. این تدبیر هوشمندانه به شرکت های متقاضی اجازه می دهد ابتدا داده های رایگان و شبیه سازی شده را به صورت عملی بررسی و آزمایش کنند و سپس در صورت تمایل، هزینه های سنگین حسابرسی فنی را برای دریافت داده های بزرگ تر بپردازند.
یک تصویر مفهومی که در آن وب مسترها با فایل های مارک دان قدیمی و ناکارآمد در یک سمت، و یک خزنده هوشمند و جان مولر (با ذره بین) در سمت دیگر، در حال بررسی یک جریان داده تمیز و ساختاریافته (HTML) هستند. این تصویر پایان دوران تلاش برای سئو با مارک دان را به تصویر می کشد، زیرا طبق قانون DMA، گوگل و سایر موتورهای جستجو کاملاً بر HTML مسلط هستند و از این پس داده های حساس جستجو (Queries, Clicks, Ranking) در یک سیستم بسته و امن (نماد گاوصندوق و قفل پولی) با رقبا به اشتراک گذاشته می شوند.
نتیجه گیری
در مرحله نخست، ارسال قراردادهای مجوز آغاز خواهد شد و پس از آن، جزئیات فنی و مشخصات ساختاری مجموعه داده ها منتشر می شود.
کمیسیون اروپا قصد دارد این تدابیر را هر دو سال یک بار بازبینی و ارزیابی کند. علاوه بر این، گوگل ملزم خواهد بود یک صفحه وب عمومی ایجاد کرده و نام تمامی موتورهای جستجو و ابزارهای هوش مصنوعی شخص ثالث را که به این داده ها دسترسی دارند، در آن فهرست کند.
این فهرست عمومی و شفاف، ابزاری مهم خواهد بود تا ببینیم آیا دسترسی به این داده های ارزشمند تنها محدود به موتورهای جستجوی بزرگ و شناخته شده باقی می ماند یا اینکه پای چت بات های هوش مصنوعی پیشرو و سایر استارتاپ های نوآور نیز به این حوزه باز خواهد شد.