

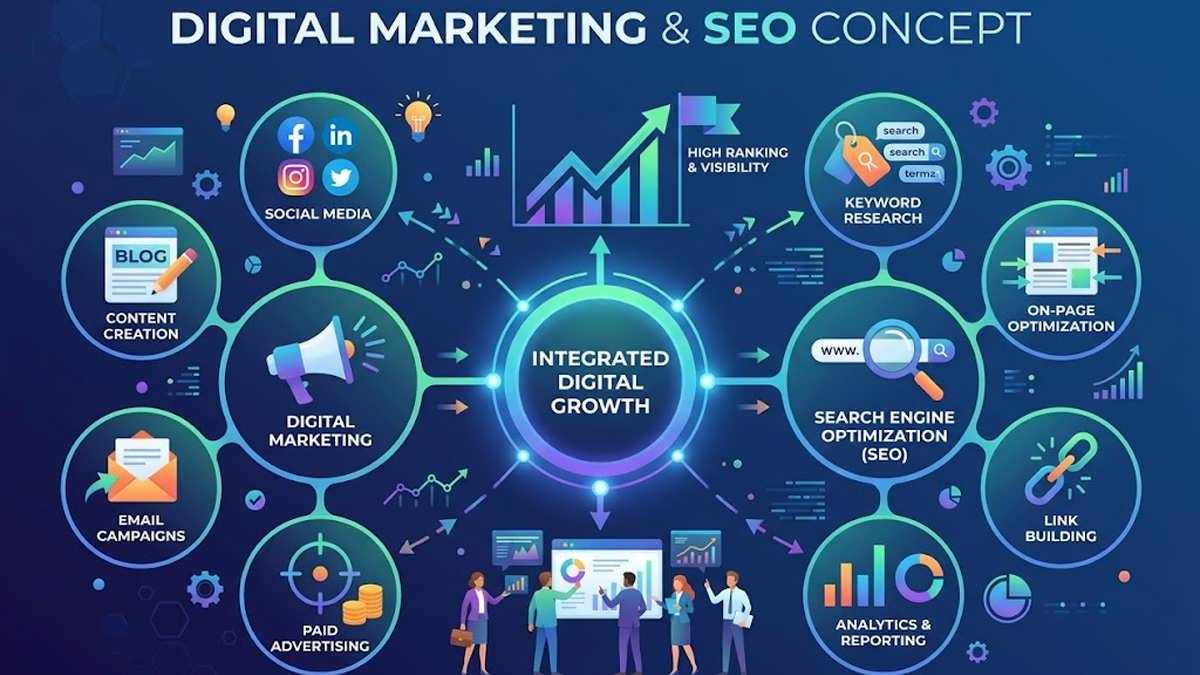
با تشکر از تحقیقات فوق العاده رند فیشکین (Rand Fishkin – بنیان گذار SparkToro) و انتقادات تند و تیز بری شوارتز (Barry Schwartz – از چهره های سرشناس اخبار سئو)، امروز می دانیم که گوگل سالانه بیش از ۵ تریلیون جستجو را پردازش می کند. بله، تریلیون! این یعنی روزانه ۱۳.۷ میلیارد و در هر ثانیه ۱۵۸,۰۰۰ جستجو در این موتور جستجو انجام می شود.
اما در اینجا چند نکته مهم و در حال رشد وجود دارد که باید به آن ها توجه کنیم:
- تنها ۳۲ درصد از این جستجوها به یک کلیک ختم می شوند (بقیه موارد به اصطلاح Zero-Click Search هستند).
- تنها ۶۶.۶۱ درصد از این ۳۲ درصدِ باقی مانده، وارد وبِ باز (Open Web – سایت های خارج از اکوسیستم خود گوگل) می شوند.
- این آمار و ارقام هر ساله در حال تغییر و افزایش است.
با این وجود، این اعداد هنوز هم نشان می دهند که گوگل روزانه ۲.۹۲ میلیارد کلیک را روانه سایت های مختلف می کند. این رقمی است که قطعا ارزش جنگیدن دارد؛ به ویژه برای وب سایت ها و ناشرانی که مدل کسب وکارشان به شدت به همین کلیک ها وابسته است. به همین دلیل است که ما در دانش وب، در طراحی سایت و تدوین استراتژی های دیجیتال مارکتینگِ مشتریانمان، همیشه روی خلق ارزش برای جذب این کلیک های هدفمند تاکید ویژه ای داریم.
بنابراین، بیایید هدف اصلی و آنچه را که در حال حاضر اهمیت دارد، فراموش نکنیم. و قطعا «محتوای منحصر به فرد (Unique Content)» کاملاً در این قالب جای می گیرد.
شواهد عملیاتی سازی: از تئوری پتنت تا واقعیت الگوریتم
من اخیراً چند پتنت (اختراع ثبت شده) قبلی گوگل را بررسی کرده ام (از جمله پتنت مربوط به مقالات عمیق گوگل و نحوه رتبه بندی سایت های خبری) و باید بگویم خواندن این اسناد فنی اصلاً کار لذت بخشی نیست! ثبت یک پتنت تنها از یک ایده محافظت می کند؛ اما لزوماً ثابت نمی کند که آن ایده در دنیای واقعی پیاده سازی شده باشد. از طرفی، اصلاً بعید نیست که غول های فناوری، مالکیت یک ایده را صرفاً برای جلوگیری از استفاده رقبا ثبت کنند.
اما به طور کلی، می توان اینطور استدلال کرد که اگر:
- یک پتنت به طور منظم و اخیراً مورد استناد قرار گیرد: پتنت مورد بحث ما با نام “تخمین مبتنی بر بسترِ کسب اطلاعات از لینک ها” (Contextual estimation of link information gain)، تاکنون ۲۴ بار و حتی تا همین سال گذشته مورد استناد قرار گرفته است.
- ثبت های بین المللی داشته باشد: بله، هرچند با کمی تبصره. این پتنت در آمریکا و چین ثبت شده، در اروپا و سطح جهانی متوقف شده، اما اعتبار آن در ایالات متحده به تازگی تا سال ۲۰۳۹ تمدید شده است.
- گوگل از این تکنولوژی رتبه بندی در سراسر جهان محافظت کرده باشد: بله، باز هم با برخی شرایط خاص.
- با درک شما از مفاهیم فعلی وب مطابقت داشته باشد: در این مورد (یعنی مبارزه با محتوای کپی و بی ارزش)، کاملاً مطابقت دارد. در شرایطی که نفس های به شماره افتاده ی محتواهای بی ارزش و صرفاً سئوشده (Commodity Content)، عرصه را بر کاربران تنگ کرده است، غیرقابل تصور است که گوگل راهی برای سنجش و ارزیابی میزان “منحصر به فرد بودن” محتوا نداشته باشد.
با این تفاسیر، احتمال اینکه این سیستم به شکلی در حال استفاده باشد بسیار بالاست.
خلاصه کلام (TL;DR)
- گوگل سیستم های عمومی و فاش شده ی متعددی دارد که به نظر می رسد میزان اصالت، تلاش انسانی و ارزش افزوده محتوا را ارزیابی می کنند (مانند شاخص های فاش شده OriginalContentScore و ContentEffort).
- این پتنت یک «امتیاز کسب اطلاعات» (Information Gain Score) را توصیف می کند (احتمالاً در بازه صفر تا یک). این امتیاز بر اساس میزان اطلاعات جدیدی که یک صفحه به اطلاعاتی که کاربر قبلاً در صفحات دیگر خوانده اضافه می کند، به آن صفحه داده می شود.
- به عقیده من و بسیاری از متخصصان دیگر، سیستم های گوگل به نوعی به اصالت و نوآوری پاداش می دهند. حال اینکه این پاداش مستقیماً از طریق امتیاز Information Gain اعمال می شود، یا از طریق مدل های پیش بینی بیزی (Bayesian)، و یا به صورت غیرمستقیم با تحلیل سیگنال های تعامل مثبت کاربران، دقیقاً مشخص نیست.
- «اصالت» به معنای نوشتن یک متن کاملاً متفاوت و عجیب و غریب نیست. گاهی تنها ۱۰ درصد تفاوت و ارزش افزوده می تواند مرز بین شکست یا موفقیت در بازاریابی محتوایی شما باشد.
متمایز بودن محتوا و درخشیدن در میان حجم انبوهی از اطلاعات تکراری و کپی شده.
این سیستم در عمل چگونه کار می کند؟
این پتنت درباره اعمال امتیاز کسب اطلاعات در همان لحظه جستجوی کاربر نیست؛ بلکه درباره نتایج جستجوهای بعدی است. یعنی گوگل نتایج جستجو را بر اساس رفتار جستجوی گسترده تر کاربران، شخصی سازی و ارزش افزوده اسناد، برای جستجوهای آینده رتبه بندی مجدد می کند.
این پتنت به صراحت تاکید می کند که صفحات وب ممکن است:
- دوباره رتبه بندی (Rerank) شوند.
- از نتایج حذف (Exclude) شوند.
- با افت رتبه شدید (Demote) مواجه شوند.
- یا دیگر هرگز در نتایج ظاهر نشوند.
بر چه اساسی؟ بر اساس میزان اطلاعات جدید و مرتبطی که در مقایسه با سایر صفحاتِ مشابه ارائه می دهند.
برای خوره های سئوی تکنیکال، مفهوم “Preloading” کاملاً آشناست. در دنیای برنامه نویسی، Preloading به مرورگر می گوید که کدام منابع باید برای بهبود سرعت لود و نمایش سریع تر بخش بالایی سایت (Above-the-fold) در اولویت قرار گیرند. (اگر در این زمینه سایت شما کند است، متخصصان فنی دانش وب می توانند با بهینه سازی سرعت سایت، این مشکلات را برطرف کنند).
به نظر من این پتنت نیز با منطقی مشابه کار می کند، اما با این تفاوت که به جای ماشین های قابل پیش بینی، با انسان های غیرقابل پیش بینی سروکار دارد. شاید مقایسه آن با قابلیت bfcache مرورگرها مثال بهتری باشد.
مراحل کار به زبان ساده
درک نحوه کارکرد موتورهای جستجو در ارزیابی محتوا، به ما کمک می کند تا بدانیم چرا برخی مقاله ها با وجود تلاش زیاد دیده نمی شوند و برخی دیگر به سرعت رشد می کنند.
- فرض کنید کاربری در حال خواندن مقاله ای درباره “کاشت نهال پسته” (یا هر موضوع دیگری) است.
- گوگل به خوبی درک می کند که اکثر کاربران با خواندن یک صفحه متوقف نمی شوند؛ چون این یک موضوع گسترده است. سوالاتی مانند: چه زمانی باید بکارم؟ در چه خاکی؟ به چه کودی نیاز دارد؟ برای کاربر پیش می آید.
- گوگل با در دست داشتن اطلاعاتِ ۱۳ ماهه از کلیک ها و تعاملات کاربران، با دقتی بی نظیر می داند که بر اساس هدف نهایی کاربر، چه محتوایی و در چه زمانی باید به او نمایش داده شود.
- اما هر روز محتواهای جدیدی نوشته و صفحات قدیمی آپدیت می شوند. پس گوگل با یک دیتابیس ثابت روبه رو نیست. شاید یک نفر روشی کاملاً نوین برای پرورش نهال پسته ابداع کرده باشد!
- بنابراین، صفحات با هم مقایسه می شوند. کاربر صفحه اول (d1) را می خواند. سپس گوگل یک مقاله جدید یا آپدیت شده (d2) را با مقاله اولیه مقایسه می کند.
- اگر صفحه d2 امتیاز اطلاعاتی (Information Gain) قابل قبولی کسب کند (یعنی حرف جدیدی برای گفتن داشته باشد)، احتمالاً در ادامه مسیر جستجو به کاربر نمایش داده می شود. اما اگر حرف جدیدی نداشته باشد، محکوم به نابودی در نتایج است.
در متن پتنت آمده است: “امتیاز کسب اطلاعات برای یک سند مشخص، نشان دهنده اطلاعات اضافه ای است که در آن سند وجود دارد، فراتر از اطلاعاتی که در اسنادِ از پیش نمایش داده شده به کاربر، وجود داشته است.”
بیایید فرض کنیم دو سند بر اساس تاریخچه جستجوی کاربر انتخاب شده اند (d1 و d2). کاربر قبلاً d1 را خوانده است و d2 یک محتوای کاملاً جدید است. این صفحات می توانند به صورت یک «بردار» (Vector) یا دیگر مدل های معنایی (Semantic) در سیستم گوگل مدل سازی شوند تا هوش مصنوعی جایگاه و تفاوت آن ها را نسبت به هم درک کند.
سیستم گوگل یک نمره کمی (عددی) تعیین می کند تا ارزیابی کند آیا کاربر پس از دیدن d1، باید d2 را هم ببیند یا خیر. اگر مدل یادگیری ماشین نمره اطلاعاتی بالاتری برای d2 نسبت به d1 محاسبه کند، صفحه d2 در آینده شانس بسیار بالایی برای نمایش خواهد داشت، حتی شاید به قیمت حذف صفحه d1 از نتایج!
این موضوع پیامدهای بسیار کاربردی و جدی دارد:
اگر موضوعی آنقدر در سطح وب نوشته شده که به اصطلاح “اشباع” شده است، شانس شما برای رتبه گرفتن محدودتر می شود؛ مگر اینکه چیز جدیدی اضافه کنید. در سناریویی که مقاله شما نمره ۰ بگیرد، سیستم تشخیص داده که محتوای شما هیچ ارزش افزوده ای ندارد، بنابراین کاربری که مقاله اول (d1) را خوانده، دیگر مقاله شما (d2) را نخواهد دید.
اگر هیچ کار دیگری نمی توانید بکنید، حداقل سعی کنید به طریقی از نزدیک ترین رقبای خود متمایز باشید.
بسیاری از این موارد، پایه ها و اصول تولید یک محتوای درخشان را توصیف می کنند: متفاوت بودن و متمایز ایستادن. ما در خدمات سئو و تولید محتوای دانش وب، همواره به کارفرمایان تاکید می کنیم که نوشتن محتوای کپی یا بازنویسی شده، دیگر جوابگو نیست.
مثل بسیاری از ایده های گوگل، این سیستم هم بی نقص نیست و نیازی نیست مو به مو از آن پیروی کنید. اما اصولی مانند E-E-A-T (تجربه، تخصص، اعتبار و اعتماد) و «Information Gain» مفاهیمی به شدت منطقی هستند. شما باید در ذهن کاربر (و گوگل) ماندگار شوید. هیچ جایگزین دیگری وجود ندارد.
نمایشی از پردازش داده ها، بهینه سازی شبکه و تمرکز گوگل بر کیفیت و کارایی سیستم.
این موضوع چقدر اهمیت دارد؟
به اعتقاد من، منحصر به فرد بودن و متمایز شدن، امروز بیش از هر زمان دیگری اهمیت دارد. اصلاً بیایید این پتنت را از بحث کنار بگذاریم؛ افراد یا برندهایی که محتوا تولید می کنند، اگر برای مردم (و به تبع آن برای موتورهای جستجو) خاطره انگیز و مفید نباشند، بقا نخواهند داشت.
شما باید کاری متفاوت انجام دهید.
در مورد گوگل، فکر می کنم این مسئله بیشتر به «بهینه سازی منابع و کارایی» مربوط می شود. اگر گوگل بداند که نمره اطلاعاتی دو مقاله تقریباً یکسان است، دلیلی ندارد که هر دو را به کاربر نشان دهد. مقاله دوم به نفع محتواهای غنی تر و یونیک تر کنار گذاشته می شود.
گوگل به اندازه ای داده های تعاملی کاربران را در اختیار دارد که بداند کدام صفحه باید در چه زمانی نمایش داده شود. آن ها با حذف صفحات به شدت تکراری از نتایج جستجو (SERP) یا پاسخ های هوش مصنوعی خود، کاربر را سریع تر به هدفش می رسانند.
این دقیقاً همان دلیلی است که گوگل در حال خلوت کردن و “سبک کردن” ایندکس (Index) خود است؛ یعنی حذف محتواهایی که هیچ ارزش افزوده ای ندارند (و البته حذف آن همه زباله های تولید شده توسط هوش مصنوعی های بی کیفیت).
این موضوع دو دلیل کاملاً منطقی دارد: الف) کاهش هزینه های پردازشی سرورهای گوگل و ب) رساندن سریع تر کاربر به جواب.
در دادگاه ضدانحصار وزارت دادگستری آمریکا (DOJ)، پاندو نایاک (معاون سرچ گوگل) در شهادت خود، سیستم Navboost را “یکی از مهم ترین سیگنال های ما” نامید:
“…یک نشستِ جستجوی کوتاه تر یا تعداد پرسش وپاسخ های کمتر با کاربر، می تواند باعث کاهش چشمگیر مصرف منابع سیستم (مانند حافظه و برق) شود.”
همچنین در دستورالعمل ارزیاب های کیفیت گوگل (Quality Rater Guidelines)، ارجاعات متعددی به میزان تلاش (Effort)، اصالت (Originality) و استعداد (Talent) شده است. چارچوب هایی مانند E-E-A-T به خوبی نشان می دهند که نمایش دادن تلاشی که برای تولید محتوا یا تست یک محصول کرده اید، چقدر مهم است. میزان “تلاشی” که شما روی محتوا می گذارید، به معنای واقعی کلمه توسط سیستم های گوگل اندازه گیری و کمی سازی می شود. هرچه کپی کردن صفحه شما سخت تر باشد، شانس موفقیت شما بیشتر است.
این ها اصول احمقانه ای نیستند؛ بلکه بسیار هوشمندانه اند. مشکل اینجاست که “تلاش کردن” هزینه و زمان می برد.
گوگل در حال ساخت یک اکوسیستم برای وفاداری مخاطبان است
حرف من را باور نمی کنید؟ حرف های بری شوارتز را بخوانید. گوگل سال هاست که می خواهد از شر روزنامه نگاری زرد (Churnalism) و محتواهای کلیک بیت (Click-bait) خلاص شود. حالا فناوری آن را در اختیار دارد و به نظر من، این یک اتفاق مثبت است.
گوگل تلاش می کند اکوسیستمی بر پایه “کاربران درگیر و وفادار” بسازد؛ درست مانند کاری که هر ناشر بزرگی انجام می دهد. وفادارترین کاربران شما، ارزشمندترین آن ها هستند. گوگل بی سروصدا در حال ساخت یک اکوسیستم اشتراکی است که شاید روزی با کسب وکار تبلیغاتی اش رقابت کند.
سایت هایی که بتوانند ثابت کنند فارغ از کانال سئو، مخاطبان خاص خودشان را دارند (مثلاً ورودی مستقیم یا از طریق شبکه های اجتماعی)، پاداش می گیرند. (هرچند شاید بهتر باشد به جای کلمه “پاداش”، بگوییم رقبایشان را کمی آرام تر له می کنند!).
اکنون ویژگی هایی مانند منابع ترجیحی (Preferred Sources) یا پروفایل های جستجو در فید دیسکاور (Discover – قابلیتی که در ایران نیز به شدت در حال رشد و جذب ترافیک است) وجود دارند. نشان هایی مثل “بسیار استناد شده (Highly Cited)” مدتی است که فعال شده اند. شاید هنوز خیلی عالی کار نکنند، اما نشان می دهند که گوگل در حال تلاش برای ترویج محتواهای دست اول و گزارش های منحصربه فرد است.
شما اکنون در صورت داشتن شرایط، می توانید نحوه عملکرد محتوای شبکه های اجتماعی و پلتفرم های ویدیویی خود را در نتایج جستجوی گوگل مشاهده کنید. ردپای دیجیتال (Digital Footprint) شما در صنعتی که در آن فعال هستید، بسیار مهم است.
فضای کاری حرفه ای همراه با داده های پژوهشی، تحلیل و ایده پردازی برای تولید محتوای یونیک.
آیا چگالی اطلاعات (Information Density) مهم است؟
هم بله و هم خیر. مقالات طولانی لزوماً در جلب رضایت کاربر موثرتر نیستند!
گوگل روش هایی برای “نرمال سازی طول یک مقاله” دارد تا از اینکه کلمات کلیدی اضافه و عبارات معنایی طولانی باعث رتبه گرفتن کاذب یک سند شوند، جلوگیری کند. الگوریتم هایی مانند TF-IDF (که میزان اهمیت یک کلمه را نسبت به کل کلمات سند و مجموعه اسناد می سنجد) از اینکه محتواهای طولانی و پرکلمه، فقط به خاطر ظاهر پر و پیمانشان امتیاز بالایی بگیرند، جلوگیری می کند.
شاید کلمه “جزئیات بیشتر” در اینجا گمراه کننده باشد. جزئیات و دقت معمولاً نکات مثبتی هستند، اما اهمیت آن ها بسیار کمتر از “پاسخ دادن دقیق به سوال کاربر و رساندن او به هدفش” است.
رضایت کاربر از طریق رسیدن به هدفش و داده های Navboost اندازه گیری می شود و این مهم تر از هر چیز دیگری است.
این موضوع چه تاثیری بر سیستم های هوش مصنوعی (AI) دارد؟
رتبه بندی جستجوی سنتی هنوز هم در سیستم های هوش مصنوعی بسیار حیاتی است. چه این که چقدر خوب برای عبارت اصلی رتبه می گیرید، چه اینکه در داده های آموزشی (Training Data)، سیستم های RAG (تولید افزوده شده با بازیابی) یا جستجوهای همزمان گنجانده شوید. علاوه بر این، جستجوهای هوش مصنوعی به شدت “شخصی سازی شده” هستند؛ چیزی که با گذشت زمان بیشتر هم خواهد شد.
طبق تحقیقات عالی اخیر کوین ایندیگ (Kevin Indig)، ارجاع به تحقیقات دست اول در هوش مصنوعی نادر است، اما وقتی اتفاق می افتد، ۳.۳ برابر بازدهی بیشتری دارد. همچنین داده های دست اول، قوی ترین پیش بینی کننده برای میزان اصالت یک صفحه هستند. به زبان ساده: داده های دست اول هم برای سئوی سنتی عالی هستند و هم برای سئوی مبتنی بر هوش مصنوعی (AIO)!
ایده های مطرح شده در این پتنت، دقیقاً با نحوه بازیابی اطلاعات در سیستم های مدرن جستجوی هوش مصنوعی (مانند بخش SGE گوگل) همخوانی دارد. این مدل به سیستم کمک می کند تا علاقه و نیاز بعدی کاربر را پیش بینی کند.
همانطور که راجر مونتی (Roger Montti) اشاره کرد، وظیفه هوش مصنوعی ترکیب پاسخ ها از منابع مختلف و ارائه یک نقطه شروع کامل به کاربر است. سیستم امتیازدهی Information Gain راهی عالی برای هوش مصنوعی است تا از پردازش های سنگین و غیرضروری روی اسناد تکراری جلوگیری کند.
پارامتر کشف شده ی contentEffort (که به عنوان یک ابزار تخمینِ مبتنی بر مدل های زبان بزرگ (LLM) برای بررسی میزان تلاش در نوشتن مقالات توصیف شده است)، میزان انرژی و زمان صرف شده برای ایجاد یک صفحه را تخمین می زند. از آنجا که بیش از ۵۰ درصد اینترنت را محتواهای کپی و بی ارزش پر کرده است، به نظر می رسد این راهکار گوگل برای مقابله با این معضل باشد.
چگونه می توانم از این اطلاعات به طور موثر استفاده کنم؟
پاسخ واقعاً ساده است: محتوای متمایز و غیرتکراری تولید کنید.
مفهوم “امتیاز کسب اطلاعات” را در استراتژی محتوای خود اعمال کنید. از خود بپرسید: اگر نمی توانم هیچ ارزش افزوده ای به اطلاعاتی که در حال حاضر در صفحه اول گوگل هست اضافه کنم، اصلاً چرا باید این مقاله را بنویسم؟
شما می توانید با استفاده از موارد زیر، محتوای خود را متمایز کنید:
- استفاده از داده های دست اول و اختصاصی سایت خودتان.
- بیان تجربه های شخصی واقعی.
- انجام مصاحبه با متخصصان (پادکست ها یا مصاحبه های متنی).
- گزارش نویسی واقعی (نه صرفا ترجمه اخبار).
- اولین نفر بودن در انتشار اخبار داغ و به روزرسانی مداوم آن.
- ارائه تحلیل های اختصاصی و کارشناسانه.
برای این کار نیازی به بودجه های کلان ندارید. با چند منبع داده رایگان، کمی خلاقیت و هوشمندی می توانید کارهای شگفت انگیزی انجام دهید. فقط مطمئن شوید که مقاله تان عنصری از نوآوری و “منحصر به فرد بودن” را در خود دارد. این رویکرد به شما کمک می کند تا تصمیم بگیرید آیا یک محتوا اصلاً ارزش تولید کردن دارد یا خیر. اگر محتوایی را فقط و فقط برای سئو می نویسید و هیچ حرف جدیدی برای گفتن ندارید، آن را متوقف کنید.
همانطور که قبلاً گفتم: «در مسیر و تخصص خودت بمان، اما سعی کن ماشین بهتری برانی» (کیفیت کارت را بالاتر ببر).
من احساس می کنم گزارش ایندکس در گوگل سرچ کنسول (GSC) اینجا بسیار حیاتی است. محتواهای بی روح و خسته کننده چنان عمر کوتاهی در نتایج دارند که خیلی زود از ایندکس محو می شوند. پس مراقب صفحاتی باشید که به صورت انبوه از ایندکس گوگل خارج می شوند، چرا که این زنگ خطری برای کیفیت پایین محتوای شماست.
نتیجه گیری
در دنیای پررقابت امروز، الگوریتم های گوگل روزبه روز هوشمندتر شده و تمرکز خود را از “کلمات کلیدی صِرف” به سمت “ارزش افزوده اطلاعاتی (Information Gain)” و اصالت محتوا تغییر داده اند. دیگر نمی توان با بازنویسی محتوای رقبا یا تولید انبوه مقالات توسط هوش مصنوعی، جایگاه پایداری در نتایج جستجو به دست آورد. گوگل اکنون صفحات را بر اساس میزان تلاش انسانی، تجربه واقعی (E-E-A-T) و زاویه دید جدیدی که به کاربر ارائه می دهند رتبه بندی می کند. بنابراین، استراتژی موفق سئو در سال های پیش رو، سرمایه گذاری روی کیفیت، داده های اختصاصی و جلب وفاداری مخاطب است؛ هدفی که ما در دانش وب با ارائه راهکارهای مبتنی بر داده و محتوای هدفمند، همواره برای رسیدن به آن در کنار شما هستیم.