

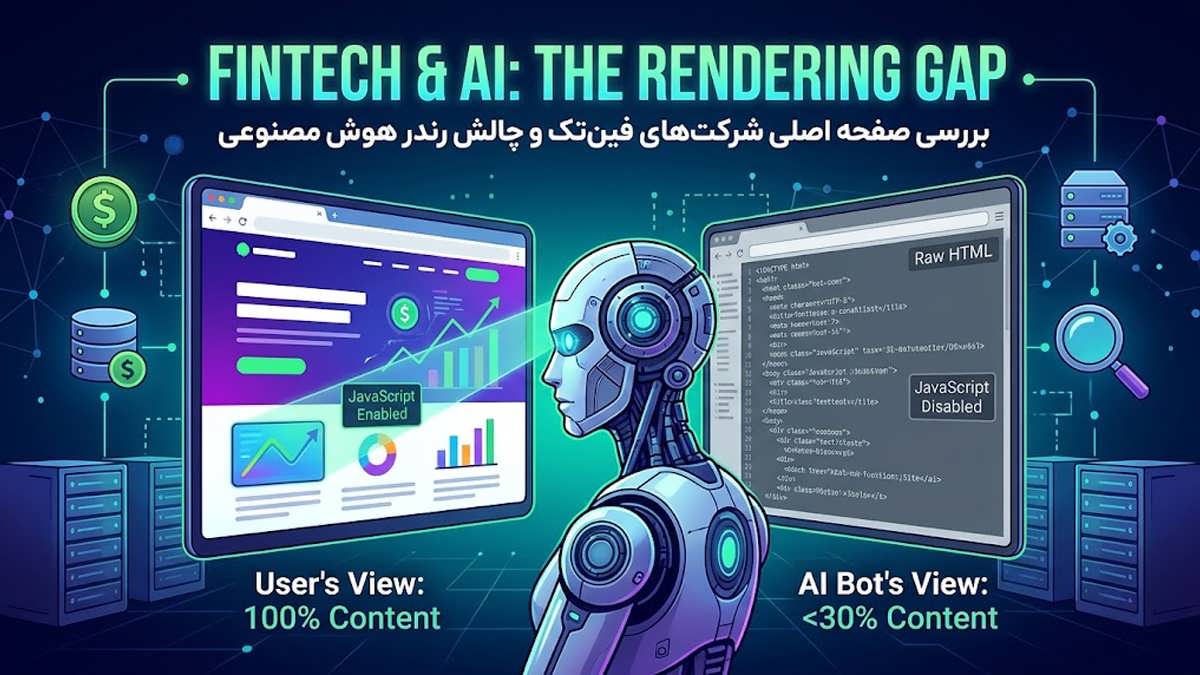
بررسی و تحلیل صفحه اصلی ۲۷۴ شرکت برتر حوزه فین تک نشان می دهد که ۳۶ درصد آن ها بدون اجرای جاوا اسکریپت، کمتر از ۸۰ درصد محتوای خود را ارائه می دهند. اما این موضوع برای دیده شدن در موتورهای جستجوی مبتنی بر هوش مصنوعی چه معنایی دارد؟
یک سوم از برترین وب سایت های فین تک جهان، کمتر از ۸۰ درصد محتوای صفحه اصلی (Homepage) خود را در قالب کد خام HTML در اختیار خزنده ها قرار می دهند. این کد خام، دقیقاً همان نسخه ای است که بات های هوش مصنوعی (AI Bots) هنگام ورود به سایت دریافت می کنند؛ درست پیش از آنکه تصمیم بگیرند آیا ارزش دارد منابع پردازشی گران قیمت سرورهای خود را برای رندر کامل صفحه در یک مرورگر واقعی صرف کنند یا خیر. واقعیت تلخ این است که بیشتر آن ها هرگز این کار را نمی کنند!
در مفهوم «معماری ماشین محور» (Machine-First Architecture)، ستونی تحت عنوان «ساختار» (Structure) وجود دارد که بر یک اصل بنیادین تأکید می کند: اطلاعات حیاتی سایت هرگز نباید به جاوا اسکریپت سمت کلاینت (Client-Side JavaScript) وابسته باشند. به این اصل، «استقلال از رندرینگ» (Rendering Independence) می گویند. تا پیش از این، استقلال از رندر تنها یک اصل تئوریک در طراحی وب بود؛ اما اکنون این اصل به یک عدد آماری دقیق و البته نگران کننده تبدیل شده است.
در تاریخ ۲۵ مه، وضعیت صفحه اصلی ۲۷۴ وب سایت فین تک از فهرست رسمی «برترین شرکت های فین تک جهان در سال ۲۰۲۵ به انتخاب CNBC» اندازه گیری شد. در این آزمایش، دو ارزیابی متوالی روی هر سایت انجام گرفت:
- واکشی خام HTTP (Raw HTTP Fetch): بدون اجرای هرگونه کد جاوا اسکریپت.
- رندر کامل در مرورگر: با استفاده از ابزار اتوماسیون Playwright.
فاصله ای که میان داده های این دو بررسی وجود دارد، دقیقاً همان شکافی است که یک بات هوش مصنوعی باید خودش با صرف هزینه پردازشی پر کند. متأسفانه ۳۶ درصد از این وب سایت ها، بات را مجبور می کنند برای مهم ترین صفحه دامنه خود، چنین پردازش سنگینی را انجام دهد. گزارش کامل این پژوهش در وب سایت Web Performance Tools منتشر شده است.
تمرکز مقالات حوزه سئوی هوش مصنوعی روی موضوعات اشتباه است!
بیشتر مطالبی که امروزه درباره بهینه سازی برای هوش مصنوعی (GEO یا Generative Engine Optimization) منتشر می شوند، روی مواردی مانند داده های ساختاریافته (Schema Markup)، محتوای ساختاریافته، سیگنال های اعتبار برند (Brand Authority) و بهینه سازی برای پاسخ های هوش مصنوعی گوگل (AI Overviews)، جستجوی چت جی پی تی (ChatGPT Search)، ارجاعات پرپلکسیتی (Perplexity) و پایپ لاین اعتبارسنجی جیمینای (Gemini Grounding) تمرکز دارند. توصیه ها پشت سر هم ردیف می شوند؛ اما یک فرض بزرگ و اساسی در همه آن ها پنهان است:
همه این تکنیک ها فرض را بر این می گذارند که بات هوش مصنوعی در همان قدم اول، اصلاً توانسته محتوای شما را ببیند و بخواند!
واقعیت فنی این است که اکثر خزنده های هوش مصنوعی، کدهای جاوا اسکریپت را رندر نمی کنند. بات هایی مثل GPTBot (متعلق به OpenAI)، ClaudeBot (متعلق به Anthropic)، PerplexityBot و ارتش خزنده هایی که وظیفه دارند مدل های زبانی را برای پاسخ دهی به کاربران تغذیه کنند، فقط یک درخواست ساده HTTP به سمت سرور می فرستند، پاسخ خام HTML را برمی دارند و می روند! آن ها مرورگر نیستند. باز کردن یک نمونه کامل از موتور مرورگر کرومیوم (Chromium Instance) برای هر صفحه، هزینه پردازشی سرسام آوری دارد که وقتی در مقیاس صدها میلیون صفحه وب ضرب شود، از نظر اقتصادی توجیه پذیر نیست. بنابراین، به صورت پیش فرض چنین کاری نمی کنند؛ کدهای خام HTML دریافتی را می خوانند و به سراغ صفحه بعدی می روند.
البته استثناهایی هم وجود دارد. برای نمونه، خزنده های سنتی گوگل از یک پایپ لاین رندر تاخیری (Deferred Rendering) برای برخی صفحات استفاده می کنند. همچنین برخی سیستم های هوش مصنوعی ممکن است برای صفحات یا دامنه های فوق العاده باارزش، رندر اختصاصی انجام دهند یا اگر پاسخ خام کاملاً خالی به نظر برسد، وارد حالت رندرینگ شوند. این الگو صددرصدی نیست؛ اما حالت پیش فرض در مقیاس صنعتی برای خزنده هایی که بزرگ ترین سیستم های هوش مصنوعی وب را تغذیه می کنند، همان واکشی خام HTTP، بدون اجرای جاوا اسکریپت، و بسنده کردن به داده های موجود در همان لایه اول است.
این فرآیند شکافی عمیق ایجاد می کند که کاربران عادی هرگز متوجه آن نمی شوند:
دیدگاه کاربر انسانی: یک کاربر واقعی سایت شما را در مرورگر باز می کند. کدهای جاوا اسکریپت اجرا می شوند. صفحه در مرورگر شکل می گیرد، محتوا بارگذاری می شود، چیدمان تثبیت شده و تصویر اصلی صفحه (Hero Image) به نمایش درمی آید. کاربر دقیقاً چیزی را می بیند که شما طراحی کرده اید.
دیدگاه بات هوش مصنوعی: بات هوش مصنوعی محتوا را بسیار پیش از رخ دادن این فرآیند دریافت می کند. هر کلمه ای که در همان فایل HTML اولیه تحویل داده نشود، از نظر بات هوش مصنوعی اصلاً وجود خارجی ندارد!
این دقیقاً همان چیزی است که ستون «ساختار» در معماری ماشین محور بر آن تأکید دارد: اطلاعات کلیدی نباید به جاوا اسکریپت سمت کاربر وابسته باشند. محتوای صفحه باید از روی پاسخ خام HTTP قابل پارس و خواندن باشد، نه از روی نمای رندرشده مرورگر ۵ ثانیه پس از بارگذاری. این موضوع صرفاً یک سلیقه فنی در پرفورمنس نیست؛ بلکه یک الزام حیاتی برای دیده شدن در چشم بات های هوش مصنوعی است که امروزه به نیابت از کاربران، وب را مطالعه می کنند.
تا همین اواخر، این استقلال رندرینگ تنها در حد یک بحث فنی میان مهندسان نرم افزار و متخصصان سئو بود. می شد اسناد فنی را خواند، رفتار خزنده ها را بررسی کرد، به این نتیجه رسید و باز هم بر سر میزان اهمیت آن در دنیای واقعی بحث کرد؛ چرا که داده و عدد مشخصی برای اثبات آن در دست نبود. اکنون داده های این جامعه آماری در فین تک، عدد دقیق را به ما نشان می دهند.
دو خوانش از یک صفحه: ابتدا HTML خام، سپس رندر کامل مرورگر
آزمایشی که روی تک تک این ۲۷۴ وب سایت برتر فین تک انجام شد، بسیار سرراست بود: دو اندازه گیری پشت سر هم در ۲۵ مه ۲۰۲۶ از کشور پرتغال.
اندازه گیری اول: واکشی خام HTTP از صفحه اصلی رسمی (Canonical Homepage) سایت؛ بدون اجرای کدهای جاوا اسکریپت و صرفاً بررسی بایت هایی که مستقیماً در پاسخ سرور برگشت داده شد.
اندازه گیری دوم: رندر کامل مرورگر با استفاده از Playwright 1.60.0 به همراه مرورگر Chromium (نسخه 148.0.7778.96) در حالت Non-Headless (شبیه سازی کامل محیط کاربری)، ثبت محتوای صفحه در ثانیه پنجم پس از TTFB (زمان تا اولین بایت) و سپس ثبت مجدد پس از رسیدن به وضعیت سکون کامل شبکه (Network Idle).
تمام این اندازه گیری ها روی خط اینترنت خانگی، با وضوح تصویر ۱۲۸۰ در ۸۰۰ پیکسل و بدون اعمال محدودیت ساختگی روی سرعت شبکه انجام شد.
برای هر وب سایت، متن های موجود در تگ های <main>، <article> یا <body> استخراج شده و برای حفظ المان های ساختاری، به فرمت Markdown تبدیل شدند. سپس متن واکشی خام به صورت درصدی از متن نسخه رندرشده در حالت سکون شبکه (Network Idle) محاسبه شد:
- دید کامل (Full Visibility): اگر واکشی خام ۸۰ درصد یا بیشتر از محتوای رندرشده نهایی را بازمی گرداند.
- دید نسبی (Partial Visibility): بین ۶۰ تا ۷۹ درصد.
- دید ضعیف (Low Visibility): بین ۳۰ تا ۵۹ درصد.
- دید نزدیک به صفر (Near-Zero): کمتر از ۳۰ درصد.
بنابراین، سه برداشت مختلف از یک صفحه در یک نشست اندازه گیری ثبت شد: واکشی خام، رندر در ثانیه پنجم، و سکون شبکه.
نکته جالب این نمودار، داده های ثبت شده در مرحله پایانی (Network Idle) نیست؛ زیرا تقریباً تمام وب سایت های این جامعه آماری تا زمان سکون شبکه به محتوای کامل خود می رسند. بخش جالب و تکان دهنده، همان داده های واکشی اولیه خام (Raw Fetch) است؛ زیرا این همان نسخه ای است که خزنده های هوش مصنوعی دریافت و بررسی می کنند.
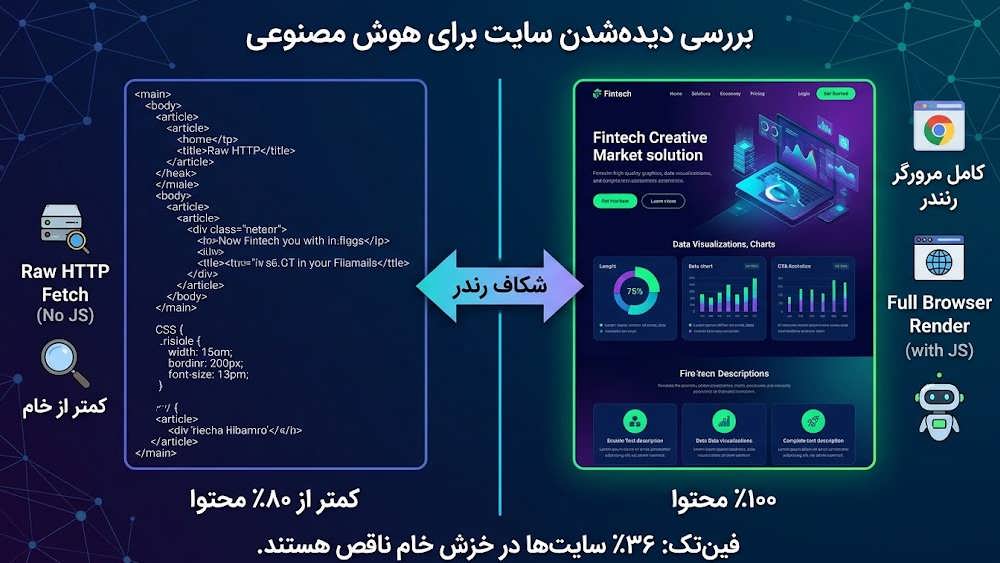
یک اینفوگرافیک تقسیم شده که تفاوت محتوای دریافتی در خزش خام HTTP (با کمتر از ۸۰٪ محتوا) و رندر کامل مرورگر (با ۱۰۰٪ محتوا) را برای یک سایت فین تک نشان می دهد.
۳۶ درصد سایت ها کمتر از ۸۰ درصد محتوای خود را بدون جاوا اسکریپت نشان می دهند!
از میان ۲۷۴ وب سایت فین تک مورد آزمایش، ۹۹ وب سایت در واکشی خام HTTP کمتر از ۸۰ درصد محتوای نهایی خود را برگرداندند. این همان تیتر اصلی ماجراست: ۳۶ درصد!
اما وقتی درون این ۹۹ وب سایت عمیق تر می شویم، وضعیت به مراتب نگران کننده تر است:
۵۵ وب سایت (۲۰ درصد از کل جامعه آماری): بدون اجرای جاوا اسکریپت، کمتر از ۳۰ درصد محتوای صفحه خود را تحویل دادند.
۴۷ وب سایت از این گروه: عملاً صفر درصد محتوا برگرداندند! پاسخ خام HTML این سایت ها تنها یک پوسته خالی (Shell)، ساختار اسکلتی اولیه صفحه و چند قطعه کد اسکریپت بدون هیچ گونه متن خواندنی بود. هر آنچه که قرار بود این صفحه منتقل کند، نیازمند یک موتور اجرای جاوا اسکریپت بود تا اصلاً قابل خواندن شود.
در میان این ۴۷ وب سایت با محتوای صفر، نام صرافی های مطرح ارز دیجیتال، نئوبانک های بسیار معروف، پلتفرم های وام دهی بزرگ و چندین شرکت سهامی عام دیده می شود؛ برندهایی که هر فعال حوزه مالی و بانکی آن ها را بدون نیاز به معرفی می شناسد. اشاره نکردن به نام تک تک آن ها برای این است که تمرکز از موضوع اصلی، یعنی خطای معماری، منحرف نشود. این موضوع که آیا صفحه اصلی سایت شما اصلاً به یک بات هوش مصنوعی نشان داده می شود یا خیر، حاصل تصمیمات فنی است که تیم توسعه در هنگام اتخاذ آن ها، اصلاً موضوعی به نام «سئو و هوش مصنوعی» را به عنوان یک متغیر در نظر نگرفته بود.
از سوی دیگر، ۲۴ وب سایتی که در بازه دید نسبی (۶۰ تا ۷۹ درصد) قرار دارند، با چالش دیگری روبه رو هستند. آن ها به بات هوش مصنوعی نشان داده می شوند، اما ناقص! بات ممکن است تیتر اصلی (Hero Headline)، منوی ناوبری و شعار اصلی را بخواند، اما توضیحات محصولات، سیگنال های اعتمادساز، فراخوان های اقدام (CTA) و لوگوی شرکا یا مجوزها را نبیند. هر بخشی که تصمیم گرفته شده بود در سمت کلاینت رندر شود تا حس تعاملی و پویاتری به صفحه بدهد، دقیقاً همان بخشی است که از دید بات هوش مصنوعی مخفی مانده است.
نمودار ریکاوری (Recovery Curve) این وضعیت را شفاف تر می کند: از میان ۲۷۴ وب سایت، ۲۷۳ سایت زمانی که یک مرورگر واقعی صفحه را به مدت ۵ ثانیه رندر می کند، به بالای ۸۰ درصد محتوا دست پیدا می کنند؛ یعنی ۹۹ درصد آن ها! بنابراین، محتوا وجود دارد و سایت ها خراب نیستند؛ بلکه این محتوا پشت یک محیط اجرای کد (Runtime) قفل شده است که خزنده های تجاری هوش مصنوعی هزینه ای برای باز کردن آن پرداخت نمی کنند.
وب سایت میانه (Median) در این جامعه آماری، برای رسیدن به وضعیت سکون کامل شبکه به زمانی ۲۱ برابر طولانی تر از زمان واکشی خام HTTP نیاز دارد. ۳۴ وب سایت (۱۲ درصد) حتی تا پایان مهلت ۳۰ ثانیه ای تست، به سکون شبکه نرسیدند. این مسئله ریشه اصلی را برجسته می کند: شکاف هزینه ای میان دریافت اولیه یک سایت و خواندن واقعی محتوای آن روزبه روز عمیق تر می شود و خزنده ها نمی توانند بار این هزینه را به دوش بکشند.
استرایپ، ادین و پلید ثابت کردند که مقصر، تکنولوژی نیست!
در نقطه مقابل، ۱۰۱ وب سایت از این نمونه آماری، ۱۰۰ درصد محتوای صفحه اصلی خود را در همان پاسخ خام HTTP بازگرداندند؛ یعنی دید کامل و بی نقص پیش از اجرای حتی یک خط جاوا اسکریپت. این فهرست شامل غول هایی همچون Stripe، Plaid، Adyen، Marqeta، Remitly، Starling Bank، Neo Financial، Backbase، Thought Machine و ۹۲ شرکت دیگر است.
شرکت Fiserv صفحه اصلی کامل خود را تنها در ۵۸ میلی ثانیه تحویل داد.
- Acorns در ۷۶ میلی ثانیه.
- Trustly در ۸۹ میلی ثانیه.
- Ledger در ۱۰۰ میلی ثانیه.
نگاهی به ماهیت این کسب وکارها بیندازید: Fiserv یک شرکت زیرساخت پرداخت و بانکداری در مقیاس ۶۰ میلیارد دلار است. Acorns یک اپلیکیشن مالی مصرفی پرمخاطب است. Ledger ارائه دهنده کیف پول های سخت افزاری با کاتالوگ گسترده ای از محصولات است. آن ها از مدرن ترین استک های فنی، سیستم های مدیریت محتوای پیشرفته، شبکه های توزیع محتوای (CDN) لبه ای و ابزارهای روز استفاده می کنند. وجه اشتراک آن ها این است: تصمیم گرفته اند محتوایی که صفحه اصلی برای انتقال آن ساخته شده، باید در همان پاسخ اولیه سرور وجود داشته باشد و اجازه نداده اند انتخاب فریم ورک های برنامه نویسی این اصل را زیر پا بگذارد.
این بهترین پاسخ به یک بهانه رایج مهندسی است؛ بهانه ای که ادعا می کند توسعه سایت های مدرن لزوماً نیازمند رندرینگ سمت کاربر (CSR) است و ساخت برنامه های تک صفحه ای (SPA) استاندارد فعلی وب است و درخواست HTML رندرشده در سمت سرور، بازگشت به ۵ سال قبل محسوب می شود. داده های صنعت فین تک به تنهایی این توجیه را باطل می کنند. سایت هایی که سریع ترین پاسخ های خام را ارائه داده اند، یا از همان ابتدا در طراحی معماری وب خود الزام استقلال از رندرینگ را رعایت کرده اند یا بعدها با اصلاح معماری، این مشکل را ریشه ای برطرف ساخته اند.
در این زمینه، متخصصان طراحی سایت و سئو در آژانس هایی مثل دانش وب همواره تأکید دارند که انتخاب فریم ورک های مدرن نباید به قیمت از دست رفتن دیده شدن سایت تمام شود. استفاده هوشمندانه از معماری های ترکیبی مانند SSR یا SSG، سرعت بالای کاربری و خوانایی صددرصدی برای موتورهای جستجو را هم زمان فراهم می کند.
البته استثناهایی هم در داده ها دیده شد. سه وب سایت در بازه زمانی ۵ ثانیه عملکرد ضعیفی داشتند، هرچند در نهایت کامل شدند. هر سه متعلق به شرکت های آسیایی بودند که تست آن ها از پرتغال انجام شده بود؛ بنابراین تأخیر شبکه ناشی از فاصله جغرافیایی نقش اصلی را در این افت بازی کرده است، نه الزاماً معماری سایت.
این مطالعه صفحات داخلی، مناطق جغرافیایی گوناگون یا محتواهای مخفی شده پشت اسکرول و کلیک را بررسی نکرده است. تصویری که این داده ها به ما می دهند، برشی از صفحات اصلی بزرگ ترین فین تک های جهان در یک روز مشخص است؛ برشی بسیار دقیق برای پاسخ به این پرسش کلیدی: آیا الزام استقلال از رندر، در مقیاس تجاری بزرگ و مدرن رعایت شده است یا خیر؟
پاسخ این است: اکثریت آن را درست اجرا می کنند، اما یک سوم در این آزمون مردود می شوند؛ یک سومی که شرکت های بزرگی را شامل می شود که تصمیمات معماری آن ها از زیر دست چندین لایه مدیران ارشد فنی عبور کرده، بدون اینکه کسی «دیده شدن توسط هوش مصنوعی» را به عنوان یک فاکتور ارزیابی کرده باشد!
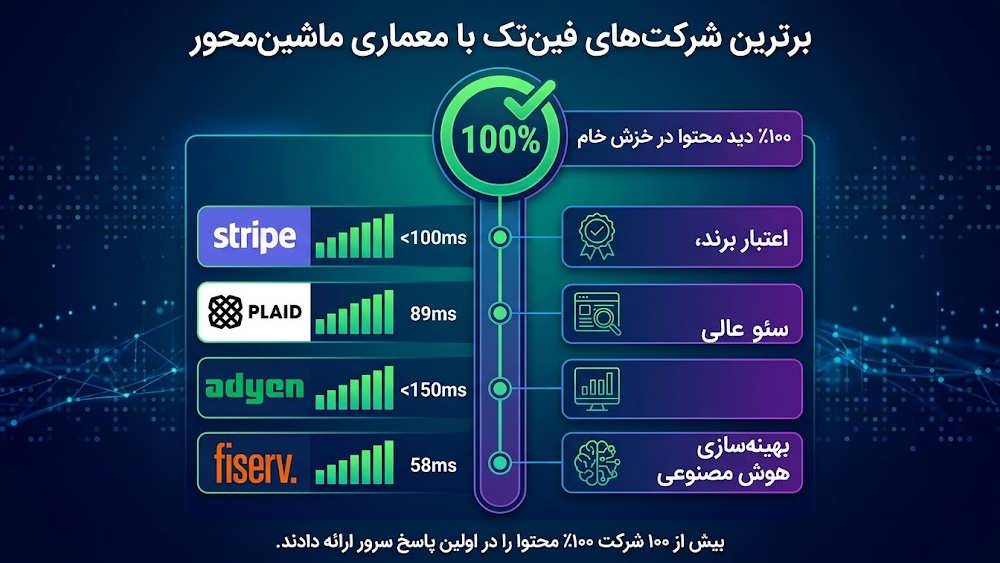
یک اینفوگرافیک که نشان می دهد شرکت های بزرگی مثل Stripe و Adyen چگونه با ۱۰۰٪ محتوای خام، عملکرد عالی در سئو و هوش مصنوعی دارند.
در فین تک، صفحه اصلی خودِ «سیگنال اعتماد» است!
بسیاری از حوزه ها می توانند نادیده گرفته شدن بخشی از صفحه اصلی خود را تاب بیاورند. اگر در یک سایت نرم افزاری شرکتی (SaaS)، زیرعنوان بخش اصلی صفحه لود نشود، کاربر احساس کمبود نمی کند. یک سایت خبری و رسانه ای می تواند با اسکیما سرتیتر خود را معرفی کند و با بدنه مقالاتش در گوگل رتبه بگیرد. اما فین تک داستان کاملاً متفاوتی دارد.
در صنعت فین تک، صفحه اصلی محل قرارگیری اطلاعات حیاتی، شفاف سازی های قانونی و رگولاتوری است:
- شماره مجوزها و لایسنس های مالی،
- تعهدات بیمه سپرده،
- نام بانک های همکار و ارائه دهندگان تسویه،
- گواهینامه های امنیتی و رمزنگاری،
- جدول کشورهای تحت پوشش،
- هشدارهای قانونی ریسک سرمایه گذاری.
این المان ها دقیقاً همان فاکتورهایی هستند که یک برند را از یک «محصول جالب» به «جایی که کاربر واقعاً حاضر است پولش را در آن بگذارد» تبدیل می کنند. همان طور که یک کاربر با بررسی این موارد اعتماد می کند، یک بات هوش مصنوعی نیز دقیقاً به همین داده ها تکیه می کند تا تصمیم بگیرد برای یک نیاز مالی، چه سرویسی را به کاربر پیشنهاد دهد.
وقتی ۱۷ درصد از این جامعه آماری در پاسخ اولیه HTML خود عملاً محتوای صفر برمی گردانند، کل این لایه اعتمادساز و قانونی ناپدید می شود. بات هوش مصنوعی نه نام بانک شریک را می بیند، نه بیمه را، و نه گواهینامه های امنیتی را؛ بلکه فقط یک پوسته توخالی را ثبت می کند.
پیچیدگی ماجرا زمانی بیشتر می شود که بدانیم تصمیم گیری برای خرید خدمات فین تک بسیار نیازمند تحقیق و بررسی است. فردی که قصد افتتاح حساب پس انداز دارد، درگاه پرداخت انتخاب می کند، بروکر مالی خود را تعیین می کند یا به دنبال کیف پول رمزارزی است، قبل از هر اقدامی چندین مقایسه دقیق انجام می دهد. این چرخه مقایسه دقیقاً همان بخشی از قیف فروش است که سریع تر از هر حوزه دیگری به محیط های چت بات های هوش مصنوعی منتقل شده است. پژوهش کلیک استریم اریک ون باسکرک (Eric van Buskirk) روی ۸۴۶ هزار نشست کاربری گوگل نشان داد که کاربران در قابلیت Search with AI، در ۶۴ درصد مواقع جستجوی خود را مستقیماً داخل خودِ هوش مصنوعی به پایان می رسانند و هرگز روی هیچ لینکی کلیک نمی کنند!
بنابراین، حلقه تحقیق و انتخاب سرویس های فین تک به درون موتورهای پاسخ هوش مصنوعی منتقل شده است؛ و باتی که به جای کاربر تحقیق می کند، گزینه های خود را تنها از میان محتواهایی انتخاب می کند که توانسته در HTML خام بخواند. اگر صفحه اصلی یک شرکت فین تک هیچ متنی در پاسخ خام سرور نداشته باشد، آن برند اصلاً وارد سبد مقایسه بات نخواهد شد؛ یعنی پیش از شروع بازی حذف شده است!
اینجاست که اهمیت ستون «ساختار» در معماری ماشین محور خود را نشان می دهد. این ستون، پیش نیاز هر استراتژی بهینه سازی دیگری برای هوش مصنوعی است:
- وقتی بات نمی تواند محتوای صفحه را بخواند، پیاده سازی اسکیما هیچ کمکی نمی کند.
- وقتی مدل هوش مصنوعی کلمات شما را ندیده است، استراتژی جذب نقل قول (Citation Strategy) کاملاً بی اثر است.
- سیگنال های اعتبار برند وقتی صفحه اصلی پاسخی خالی به GPTBot تحویل می دهد، هیچ ارزشی ندارند.
ساختار، کفِ این ساختمان است و هر فاکتور دیگری روی آن بنا می شود. بررسی این شرکت های فین تک نشان داد که این کف، برای یک برند از هر سه برند بزرگ تخریب شده است.
بررسی صفحه اصلی سایت در ۳۰ ثانیه (تست شخصی)
برای اینکه بدانید سایت شما در چه وضعیتی قرار دارد، نیازی به تحلیل فایل های لاگ، خرید ابزارهای گران قیمت یا جلسات طولانی با تیم فنی نیست. کافی است این مراحل را طی کنید:
- مرورگر گوگل کروم را باز کنید و وارد سایت خود شوید.
- کلید F12 را فشار دهید تا ابزار DevTools باز شود.
- کلیدهای ترکیبی
Ctrl+Shift+P(در ویندوز) یاCmd+Shift+P(در مک) را بزنید. - عبارت Disable JavaScript را تایپ کرده و Enter بزنید.
- صفحه اصلی سایت را مجدداً بارگذاری (Reload) کنید.
آنچه اکنون روی صفحه می بینید، دقیقاً همان چیزی است که بات هوش مصنوعی می بیند!
- اگر تیترها، ارزش های پیشنهادی، توضیحات محصولات، سیگنال های اعتماد، دکمه های اقدام و مجوزهای شما همچنان دیده می شوند، سایت شما در آزمون ستون ساختار موفق شده است.
- اگر تیتر وجود دارد اما بدنه، کارت های محصول یا توضیحات ناپدید شده اند، سایت شما در محدوده دید ناقص (۶۰ تا ۷۹ درصد) است.
- اگر صفحه ای کاملاً سفید، خالی یا اسکلتی مشاهده می کنید، شما دقیقاً در رده همان ۴۷ سایت فین تکی هستید که برای بات های هوش مصنوعی هیچ محتوایی ندارند!
اگر سایت شما در این آزمون شکست خورد، راه حل های فنی آن مشخص است:
- در Next.js، باید از قابلیت های SSR (رندر سمت سرور) یا SSG (تولید استاتیک) استفاده کرد که محتوا را مستقیماً در پاسخ خام بازمی گردانند.
- فریم ورک هایی مانند Astro و SvelteKit به صورت پیش فرض خروجی رندرشده سمت سرور تولید می کنند.
- اپلیکیشن های بر پایه React سنتی را می توان با ابزارهایی نظیر Prerender.io یا لایه پیش رندر Cloudflare Pages مسیربه مسیر بازسازی کرد تا بدون تغییر در تجربه کاربری، یک نسخه آماده از پیش رندرشده را به خزنده ها تحویل دهند.
- فریم ورک های Vue (مثلاً از طریق Nuxt) و Angular نیز الگوهای کاملاً مشابهی دارند.
این تصمیم یک تصمیم گیری مربوط به معماری توسعه نرم افزار است، نه محتوا. بیشتر تیم ها حتی نیازی به بازنویسی کل پروژه از صفر ندارند؛ کافی است یک لایه رندر سمت سرور برای مسیرهای استراتژیک (صفحه اصلی، قیمت گذاری، صفحات محصول، لندینگ های اصلی و آرشیو وبلاگ) اضافه کنند تا هویت و ارزش های برند حفظ شود.
شرکت هایی مانند Stripe و Adyen از ابزارهای ساده یا قدیمی استفاده نکرده اند؛ آن ها صرفاً معماری درستی را انتخاب کرده اند که اصل استقلال رندرینگ را پاس می دارد. این ادعا که احترام به ستون ساختار یعنی بازگشت به کدهای PHP سال ۲۰۰۹، یک مغالطه فنی است. این اصل فقط می گوید محتوا باید در لایه پاسخ HTTP حضور داشته باشد؛ اینکه چگونه این کار را با فریم ورک های مدرن انجام می دهید، به مهارت مهندسی تیم شما بستگی دارد.
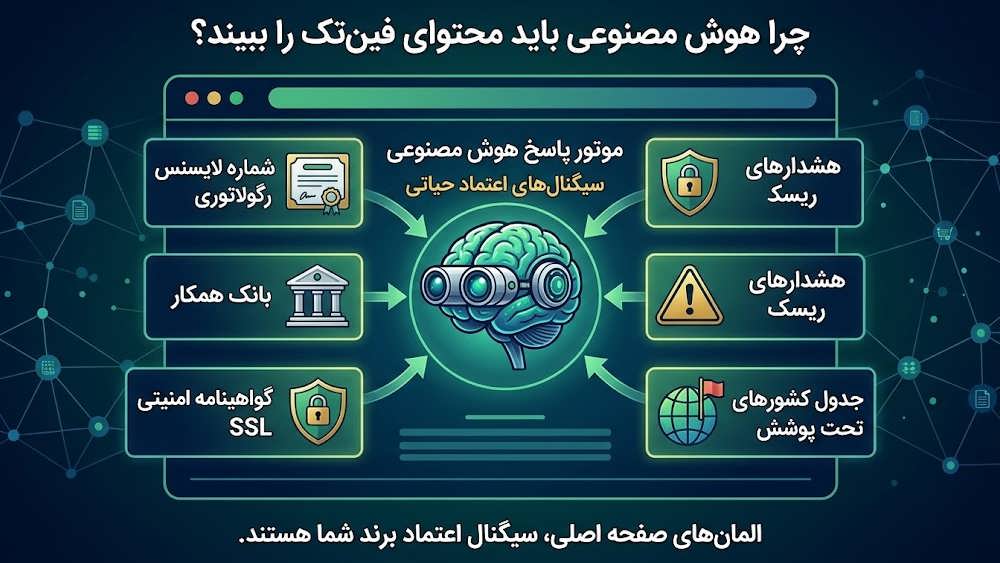
این تصویر نشان می دهد که چرا هوش مصنوعی باید المان های کلیدی صفحه اصلی فین تک (مثل لایسنس ها، گواهینامه های امنیتی و بانک های همکار) را به عنوان سیگنال اعتماد بخواند.
آنچه این پژوهش به ما نمی گوید
این مطالعه بر صفحه اصلی تمرکز داشت. صفحاتی مانند لندینگ های داخلی، متغیرهای جغرافیایی و محتواهای وابسته به اسکرول یا کلیک سنجیده نشدند؛ در حالی که محتوای قفل شده پشت کلیک و تب ها، خود یکی از دلایل رایج عدم خوانایی برای خزنده ها است.
سوالی که فعلاً پاسخی برای آن در دست نیست، این است که آیا با ارزان تر شدن هزینه های پردازشی در آینده، خزنده های هوش مصنوعی اجرای جاوا اسکریپت را به روال عادی خود تبدیل خواهند کرد؟ ممکن است این اتفاق بیفتد؛ اما با توجه به رشد نمایی حجم وب، بعید به نظر می رسد در کوتاه مدت چنین تغییری در مقیاس وسیع رخ دهد.
نتیجه گیری
امروز یک سوم از برترین شرکت های فین تک دنیا برای بات های هوش مصنوعی نامرئی یا نیمه نامرئی هستند. استقلال از رندر دیگر صرفاً یک بحث سلیقه ای میان توسعه دهندگان نیست؛ بلکه به یک الزام حیاتی برای بقا در فضای وب جدید تبدیل شده است.
فردا بات هوش مصنوعی بازخواهد گشت، کراول دوباره تکرار خواهد شد و کدهای HTML بررسی خواهند شد. اگر سایت شما محتوای خود را در پاسخ اولیه تحویل ندهد، پاسخی که هوش مصنوعی به کاربران می دهد از سایت رقبایی استخراج خواهد شد که صفحات خود را در لایه اول در اختیار بات ها گذاشته اند.
همین حالا ابزار DevTools مرورگر را باز کنید، جاوا اسکریپت را غیرفعال کرده و سایت خود را بررسی کنید. آنچه روی صفحه می بینید، دقیقاً تصویری است که هوش مصنوعی از کسب وکار شما در حافظه خود ثبت می کند.