

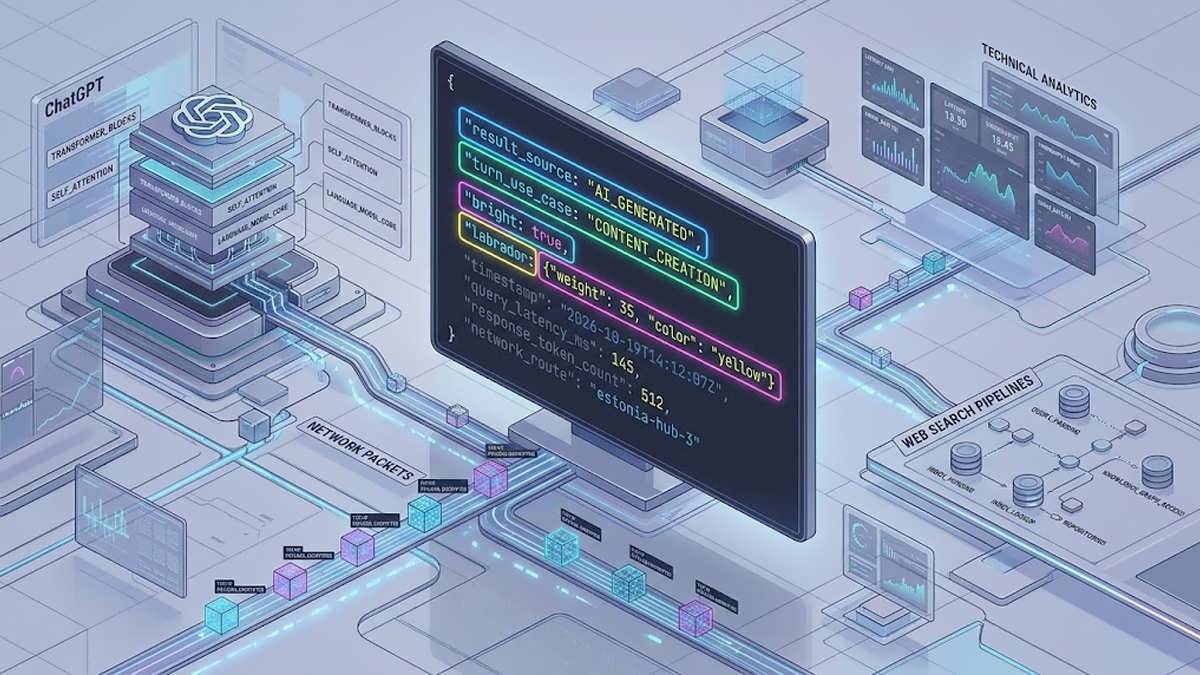
من مدام با یک سوال تکراری از طرف کارفرمایان، متخصصان سئو و حتی فعالان حوزه بهینه سازی برای موتورهای هوش مصنوعی (GEO) مواجه می شوم:
«چگونه وب سایت خود را در پاسخ های چت جی پی تی (ChatGPT) بالا بیاوریم و در آن دیده شویم؟»
پاسخی که معمولاً همه تحویل می دهند هم همیشه یکسان است: «محتوای خوب بنویسید، مقالات فهرستی و مقایسه ای (Listicle) منتشر کنید و در ردیت (Reddit) یا فروم ها فعال باشید.» بله، همان توصیه های کلیشه ای و همیشگی.
اما واقعاً از کجا مطمئنیم که این روش ها جواب می دهند؟ واقعیت این است که بیشتر این حرف ها صرفاً بر پایه باورها و حدسیات تکرار می شوند؛ متخصصی همان حرف متخصص قبلی را بازگو می کند، بدون اینکه مدرک فنی برای آن داشته باشد.
بنابراین، به جای اعتماد کورکورانه به این فرضیات، چند روز وقت گذاشتم و دقیقاً ترافیکی را که ChatGPT به مرورگرم می فرستاد بررسی کردم؛ ترافیک خام شبکه در قالب فایل های خوانای JSON.
این مقاله، روایتی گام به گام از یافته های من است، تقریباً به همان ترتیبی که در جریان بررسی داده ها کشفشان کردم.
قبل از اینکه اعدادی را از این مقاله نقل قول کنید، این نکته را بخوانید!
این بررسی صرفاً توسط یک نفر، روی یک اکانت پولی (ChatGPT Pro) و حاصل ثبت ترافیک شبکه در طول چند روز است؛ نه یک تحقیق آماری جامع روی میلیون ها کاربر. من حدود ۱,۲۴۰ رکورد منبع را در میان ده ها جست وجوی مختلف ثبت و بررسی کردم.
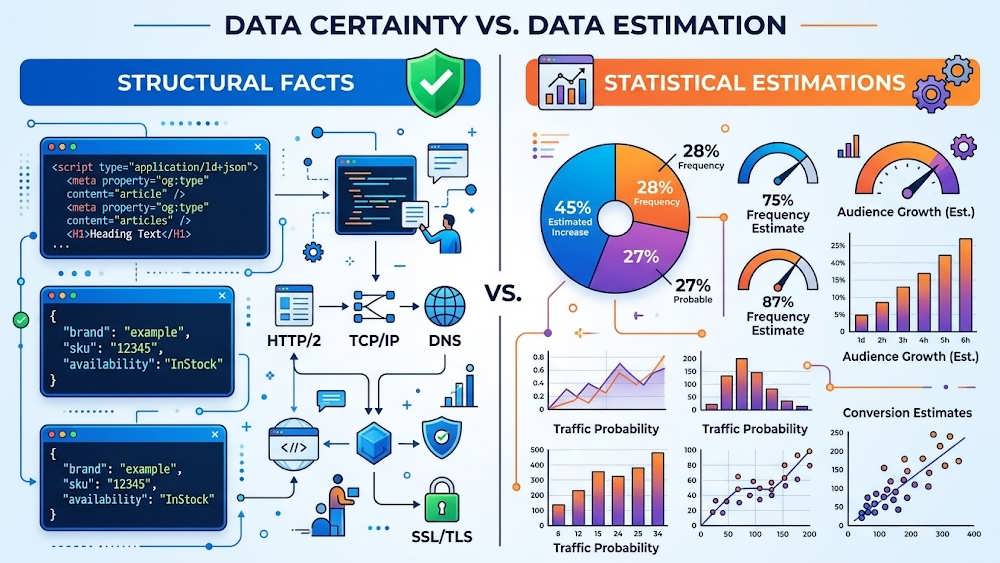
یافته های ساختاری (یعنی فیلدهایی که ChatGPT برای طبقه بندی استفاده می کند و رفتار فنی آن ها) کاملاً قطعی و غیرقابل انکار هستند؛ زیرا در تحلیل شبکه کافی است یک پارامتر را یک بار ببینید تا بدانید واقعاً در معماری سیستم وجود دارد و من آن ها را بارها و بارها مشاهده کردم.
اعداد، ارقام و درصدها داستان متفاوتی دارند. این داده ها از تعداد محدودی کوئری به دست آمده اند که اغلب در حوزه SaaS و فناوری بودند؛ بنابراین آن ها را نه به عنوان یک متر و معیار دقیق، بلکه به عنوان یک «قطب نما و جهت گیری کلی» در نظر بگیرید. در سراسر مقاله مشخص کرده ام که کدام یافته از نوع ساختاری و کدام از نوع فراوانی آماری است.
تفاوت این تحلیل با گزارش های بزرگ سئو در چیست؟ و به چه چیزی می توانید تکیه کنید؟
برای بررسی نحوه کارکرد موتورهای هوش مصنوعی دو رویکرد وجود دارد که کاملاً در دو جهت متضاد حرکت می کنند:
1- رویکرد مرسوم پلتفرم ها و ابزارهای سئو: ابزارهای بزرگ با بودجه های کلان هزاران پرامپت می فرستند، بررسی می کنند که نام کدام برندها در متن نهایی آمده است و گزارش هایی مثل «سهم صدا» (Share of Voice) منتشر می کنند. این روش نمونه های آماری بزرگی دارد، اما ساختارش یک «جعبه سیاه» (Black Box) است. آن ها فقط پاسخ نهایی را می بینند، بنابراین مجبورند سازوکار داخلی موتور را از روی خروجی نهایی حدس بزنند.
2- رویکرد این تحقیق (بررسی مهندسی معکوس ترافیک): این روش دقیقاً نقطه مقابل است. من ترافیک شبکه و داده های JSON را که موتور مستقیماً به مرورگرم می فرستاد خواندم و برچسب های داخلی خود سیستم را بیرون کشیدم: مقداری که تحت عنوان result_source به هر نتیجه می زند، برچسبی که با turn_use_case برای قصد جستجو مشخص می کند، نام سرویس های واسط استخراج داده، جست وجوهای فرعی که خود ربات در وب انجام داده و مدلی که واقعاً در پشت صحنه ران شده است. من فرکانس رخدادها در یک جمعیت میلیونی را نمی سنجم؛ بلکه دارم مستند می کنم که این سیستم دقیقاً چه ماژول ها و متغیرهایی دارد و آن ها را چه می نامد.
این تفاوت مرز میان داده های قابل اتکا و فرضیات را مشخص می کند؛ پس بیایید شفاف صحبت کنیم.
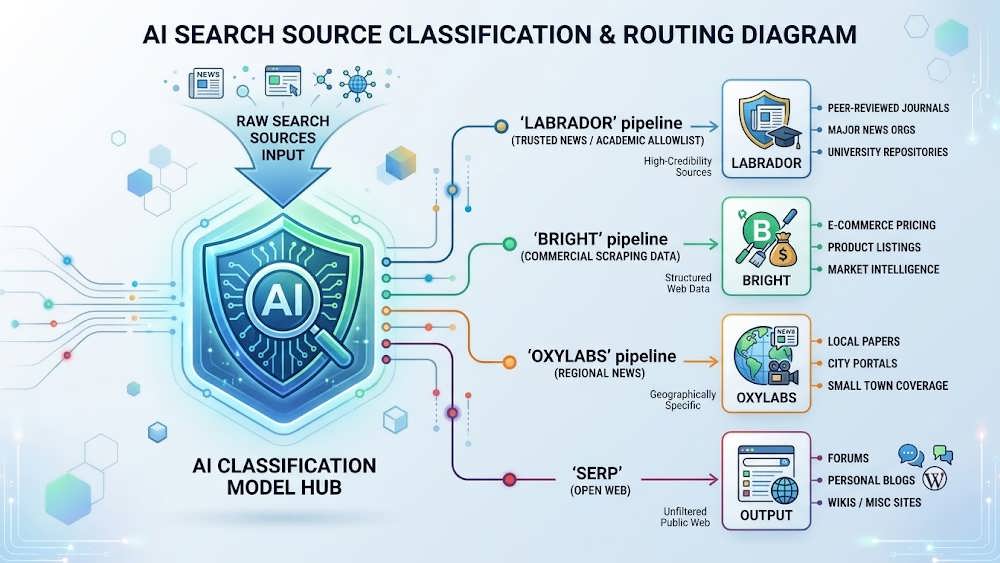
اینفوگرافیک تحلیل فیلد result_source و چهار متغیر SERP، Labrador، Bright Data و Oxylabs در خط لوله جمع آوری اطلاعات.
دو سطح اطمینان: این دو را با هم اشتباه نگیرید
برای درک درست این یافته ها، باید میان واقعیت های معماری سیستم و آمارهای متغیرِ ناشی از نمونه آماری فرق بگذارید.
۱. حقایق ساختاری (سطح اطمینان بسیار بالا)
وجود فیلد result_source که مقادیر serp ،labrador ،bright و oxylabs را می پذیرد قطعی است؛ اینکه bright همان غول اسکرپینگ داده یعنی Bright Data است و oxylabs همان شرکت معروف Oxylabs؛ اینکه فیلد turn_use_case شش مقدار مختلف می گیرد؛ اینکه کوئری های متنی خالص (text) اصلاً به وب دسترسی پیدا نمی کنند و پروسه جستجو را نادیده می گیرند؛ و اینکه مدل استدلالی (Thinking) ده ها زیرکوئری با اپراتور :site و جستجوهای اعتبارسنجی قیمت ارسال می کند. همه این موارد مستقیماً از روی سیم و پروتکل شبکه استخراج شده اند. ثبت یک رکورد معتبر ثابت می کند فیلدی با این نام وجود دارد، در حالی که حتی بزرگ ترین آزمایش های مبتنی بر پرامپت خروجی هرگز قادر به دیدن چنین ساختاری نیستند.
۲. مشاهدات بسامدی و درصدی (صرفاً جهت دهنده و تخمینی)
هر آماری که با درصد یا رتبه مشخص شده است (مانند «۷۰٪ منابع توسط Bright تامین شده اند»، «ردیت بیشترین ارجاع را دارد» یا «یوتیوب تقریباً هرگز سایتیشن دریافت نمی کند») از چند ده پرسش در یک اکانت شخصی به دست آمده و انتخاب دسته بندی جستجو روی آن تأثیرگذار بوده است. من کوئری های حوزه فناوری و نرم افزار را انتخاب کردم؛ دقیقاً به همین دلیل است که ردیت و وبلاگ های بررسی تکنولوژی صدرنشین شدند. اگر یک بسته از سوالات حوزه سلامت یا مد و فشن را بررسی می کردم، قطعاً دامنه های متفاوتی در صدر می نشستند. این آمارها را به چشم «شکل رفتار سیستم» ببینید نه «معیار قطعی اندازه گیری». البته جایی که یک دلیل فنی و مکانیکی پشت رفتار وجود دارد (مثلاً اینکه محتوای ردیت متن خام است و به راحتی نقل قول می شود، اما یوتیوب ویدیو با متادیتاست)، به دلیل فنی تکیه کنید و اصراری روی دقت اعداد نداشته باشید.
واقعیت خسته کننده درباره «آنالیز بسته ها» (Packet Analysis)
برداشت اولیه من اشتباه بود. شما نمی توانید صرفاً با شنود پکت ها (Packet Sniffing) کوئری ها را بخوانید؛ چون بار داده (Payload) تحت پروتکل امن TLS رمزنگاری شده است. در نتیجه یک ابزار شنود شبکه، تنها کدهای رمزشده تحویل شما می دهد. چیزی که ابزارها فاش می کنند صرفاً متادیتا است: نام هاست مقصد، آدرس های IP و این واقعیت که اپلیکیشن ChatGPT از پروتکل جدید QUIC (یعنی HTTP/3) به جای TCP سنتی استفاده می کند. به همین دلیل در ابزاری مانند Wireshark، نام سرور در فاز Handshake قابل مشاهده است؛ چراکه نام سرور رمزنگاری نمی شود، اما محتوای گفتگو کاملاً پنهان می ماند.
داده های درخواست و پاسخ های واقعی درون لایه های محافظت شده بعدی قرار دارند. بنابراین تنها لایه خوانا، خود مرورگر و تب Network در ابزار DevTools پس از رمزگشایی است. درست در آنجاست که پرسش ها، پاسخ ها و تمامی متادیتاها در قالب JSON به چشم می خورند.
این فرایند «بازرسی HTTP» است نه شنود سنتی پکت ها. گفتن این نکته ضروری بود؛ چراکه نیمی از افرادی که این کار را شروع می کنند اول سراغ Wireshark رفته و وقتی چیزی نمی فهمند، ناامید می شوند!
دو راهکاری که امتحان کردم و با شکست مواجه شد (تا شما وقتتان را تلف نکنید):
- اتوماسیون مرورگر با کروم بدون سر (Headless/Automated): کلودفلر (Cloudflare) ظرف چند جست وجو آن را بلاک کرد؛ صفحه «بررسی هویت انسانی» در مرورگرهای اتوماتیک در یک حلقه بی نهایت گیر می افتد. به همین دلیل تست ها را در مرورگر واقعی کروم خودم و نشست های کاربری واقعی انجام دادم.
- عدم مشاهده خروجی در ضبط های میانی: در ابتدا هیچ پاسخی در تب نتورک ثبت نمی شد؛ دلیلش این است که استریم پاسخ ها روی یک کانکشن بلندمدت (Long-lived connection) که در زمان بارگذاری اولیه صفحه باز شده است جریان می یابد. بنابراین، اسکریپتی که وسط کار متصل شود داده ای دریافت نمی کند.
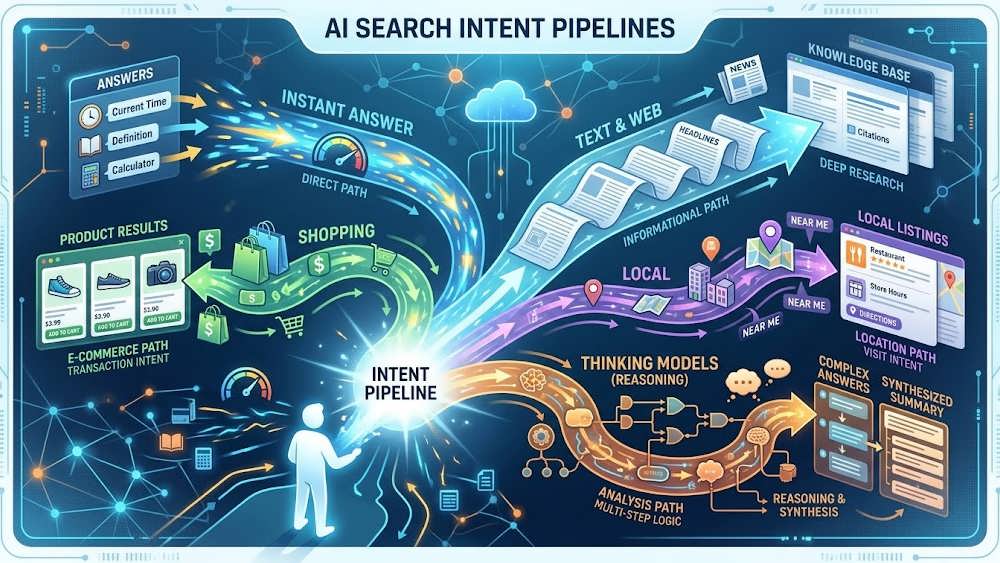
تصویر مفهومی نشان دهنده دسته بندی کوئری ها به حالت های مختلف از جمله text، shopping، local و thinking.
فیلدی که روی تمامی منابع برچسب می زند: result_source
من کنسول ابزارهای توسعه دهنده مرورگر (DevTools) را باز کردم، گزینه Preserve log را فعال کردم، یک کوئری معمولی اجرا کردم و پاسخ ها را برای پیدا کردن هر چیزی که شبیه یک برچسب باشد گشتم.
فیلدی که پیدا شد result_source بود. این فیلد پشت هر نتیجه وبی که ChatGPT واکشی می کند وجود دارد؛ شما هرگز این فیلد را در متن پاسخ هوش مصنوعی نمی بینید و سیستم همیشه یکی از ۴ مقدار زیر را به آن اختصاص می دهد.
مارک ویلیامز-کوک (Mark Williams-Cook) قبلاً اعلام کرده بود که سه مورد از این مقادیر را پیدا کرده است و من به چهارمین مورد دست یافتم. متهان (Metehan) نیز به نظر می رسد به این ساختار رسیده باشد. مهم نیست چه کسی اول آن را پیدا کرد؛ موضوع این است که مشاهداتمان را با هم به اشتراک بگذاریم و یاد بگیریم.
یک نمونه از این منبع در ترافیک شبکه (خلاصه شده به فیلدهای مهم):
json
{
 "attribution": "TechRadar",
 "url": "https://www.techradar.com/best/...",
 "snippet": "...",
 "pub_date": "2026-05-09",
 "result_source": "labrador"
}
چهار مقداری که ChatGPT برای دسته بندی منابع استفاده می کند
مقدار result_source |
ماهیت و کاربرد فیلد |
|---|---|
serp |
پایه وب باز (Open Web)؛ عمدتاً در سایت های خبری عمومی (مانند Yahoo و StreetInsider) دیده می شود. |
labrador |
لیست سفید (Allowlist) رسانه ها و ناشران معتبر قراردادبسته؛ مانند رویترز، گاردین، وال استریت ژورنال، فایننشال تایمز، ویکی پدیا و حتی arXiv. قطعه متن های استخراج شده در این بخش گاهی تا حدود ۱,۰۸۰ کاراکتر (تقریباً یک خلاصه جامع از مقاله) هستند. |
bright |
مربوط به شرکت تجاری بزرگ وب اسکرپینگ یعنی Bright Data. بسیار پرکاربرد و دست بالا در حوزه های خرید آنلاین (Shopping)، مالی، پیش بینی هواشناسی و جستجوهای محلی. |
oxylabs |
مربوط به شرکت رقیب یعنی Oxylabs. بیشتر برای رسانه های منطقه ای، محلی و بخشی از وب باز دیده می شود. |
به نظر می رسد دسته بندی labrador یک لایه دارای لایسنس انحصاری است؛ چندین ناشر این بخش قراردادهای رسمی انتقال محتوا با OpenAI امضا کرده اند و ورود به این سطح برای کسب وکارهای معمولی و سایت های معمولی غیرممکن است، مگر اینکه صاحب یک روزنامه ملی یا دایره المعارف جهانی باشید!
اما بخش جذاب ماجرا دو متغیر bright و oxylabs هستند. نام ها صراحتاً به شرکت های scraping معروفی اشاره دارند که رقبای مستقیم یکدیگرند. از داخل ترافیک نمی توان متن قرارداد آن ها را دید، بنابراین ادعا نمی کنم ChatGPT مستقیماً به آن ها پول می دهد، اما محرز است که بخش استخراج وب باز آن از این دو مجرا رد می شود و این فیلد دقیقاً مشخص می کند هر نتیجه توسط کدام یک استخراج شده است.
در تمام داده هایی که ثبت کردم، بخش عمده فراخوانی ها بر دوش Bright Data بود، به ویژه در کوئری های تجاری، خرید اینترنتی، مالی و هواشناسی. در مقابل، Oxylabs بیشتر به سمت نتایج منطقه ای میل می کرد؛ Labrador صرفاً در اخبار معتبر و منابع مرجع فعال بود و SERP هم گهگاه در اخبار متفرقه ظاهر می شد. به عنوان مثال، Labrador منابعی چون رویترز، وال استریت ژورنال، ویکی پدیا و تک رادار را آورد؛ Bright به سراغ Reddit ،Forbes و rtings رفت و Oxylabs نشریات محلی حوزه خلیج فارس مثل Khaleej Times و Gulf News را جمع آوری کرد.
جالب اینکه حتی در یک کوئری هواشناسی مربوط به دبی، تفکیک داده ها به این شکل درآمد: سایت های داده های جهانی مثل اداره هواشناسی بریتانیا (Met Office) با Bright فراخوانی شدند و روزنامه های منطقه ای با Oxylabs:
- metoffice.gov.uk →\rightarrow→ bright
- accuweather.com →\rightarrow→ bright
- timeanddate.com →\rightarrow→ bright
- khaleejtimes.com →\rightarrow→ oxylabs
- gulfnews.com →\rightarrow→ oxylabs
- whatson.ae →\rightarrow→ oxylabs
شما به عنوان یک کسب وکار یا وبلاگ برای حضور در پایگاه داده لایسنس شده (labrador) شانسی ندارید. میدان نبرد اصلی شما لایه اسکرپ شده (Scraped Tier) است. بنابراین ساختار وب سایت شما باید کاملاً تمیز و با بالاترین استانداردها قابل اسکرپ و خزش باشد. اطلاعات حیاتی، ویژگی ها و داده های مهم عددی خود را در متن های ساختاریافته HTML قرار دهید؛ هرگز آن ها را پشت کدهای جاوا اسکریپت پیچیده، فایل های PDF یا تصاویر مخفی نکنید. ابزار شما برای پیروزی در این لایه، حضور در سایت های شخص ثالث، روابط عمومی دیجیتال (PR)، منشن های برند، بک لینک های قدرتمند و بحث های فروم هایی مانند ردیت است تا اسکرپرها هنگام جمع آوری اطلاعات ناخودآگاه با برند شما مواجه شوند.
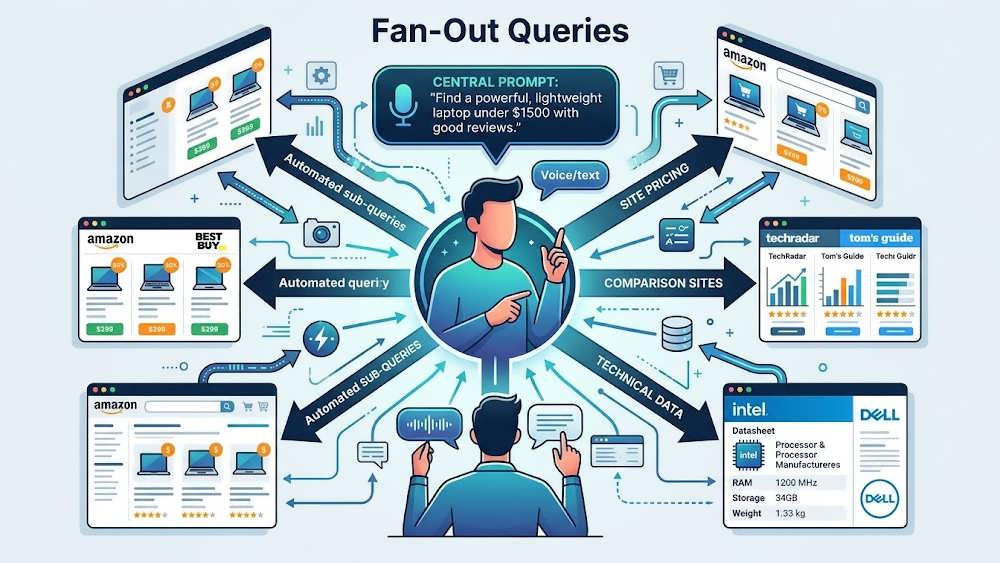
طرح گرافیکی نشان دهنده چگونگی تبدیل یک سوال ساده به ده ها زیرکوئری تخصصی برای بررسی قیمت ها و مشخصات فنی.
کوئری هایی که هرگز به وب نمی رسند!
نکته مهم دیگری که در ثبت ترافیک مشاهده کردم این بود که دسته ای از کوئری ها اصلاً هیچ جست وجویی در شبکه انجام نمی دهند! پیش از اینکه ChatGPT جستجو کند، ابتدا پرسش شما را در فیلدی به نام turn_use_case دسته بندی می کند. من در پرسش هایم ۶ مقدار را مشاهده کردم:
instant search(جستجوی آنی)shopping(خرید)text(متن خالص)local(محلی)thinking(استدلالی/تفکر عمیق)image generation(ساخت تصویر)
فیلدی که باید بسیار مراقب آن باشید، text است. وقتی چت جی پی تی سوال شما را به عنوان text نشانه گذاری می کند، اصلاً سراغ اینترنت نمی رود. بلکه پاسخ را مستقیماً از حافظه داخلی و وزن های آموزش دیده خود (Training Corpus) بیرون می کشد و تمام!
کوئری های واضح مثل: «چگونه پنچری لاستیک را بگیرم؟»، «یک تابع پایتون برای ادغام دو لیست مرتب بنویس» یا «این را به ۴ زبان ترجمه کن» همگی با مقدار text برچسب خوردند و تب نتورک آن ها کاملاً خالی بود.
اما بخشی که به شدت نگران کننده است: حتی پرسشی مانند «جدیدترین دستورالعمل های درمانی دیابت نوع ۲» (که یک موضوع حساس، جاری و پزشکی با سطح استاندارد بالای YMYL است) نیز در کمال تعجب به عنوان text علامت گذاری شد! در حالی که فکر می کنید هوش مصنوعی باید درباره این موضوع جست وجوی دقیقی انجام دهد، اصلاً به وب متصل نشد و از داده های قدیمی خود پاسخ داد؛ بدون هیچ گونه بررسی فاکتورهای E-E-A-T!
از ۱۰ سوالی که عمداً انتخاب کردم و نیاز به اطلاعات به روز داشتند، ۳ مورد کاملاً بدون جستجو و به صورت متنی پاسخ داده شدند.
جالب است بدانید نحوه نگارش عبارت (Wording) تعیین کننده دسته بندی است، نه صرفاً موضوع:
- عبارت «بهترین قهوه نزدیک من» مسیر را به خط لوله
localمی برد. - عبارت «بهترین تلویزیون های 4K برای خرید» خط لوله
shoppingرا فعال می کند. - اما عبارت «بهترین تلویزیون های 4K همراه با نقد و بررسی» در حالت جستجوی وب معمولی باقی ماند!
- یک سوال ریاضی بی سر و صدا وارد مدل استدلالی تحت
thinkingشد، در حالی که «قیمت سهام تسلا در این هفته» رویinstant searchباقی ماند.
قبل از اینکه ریالی خرج تولید محتوا و سئو کنید، مطمئن شوید کلمه کلیدی مد نظرتان اصلاً باعث فراخوانی وب می شود یا خیر. اگر کوئری مربوط به یک راهنمای ساده، تعریف واژگان یا آموزش عمومی باشد، احتمالاً هوش مصنوعی آن را از حافظه پایه خود می دهد و هیچ صفحه ای، هر چقدر هم عالی باشد، در آن دیده نمی شود. اگر می خواهید در چنین عبارت هایی ذکر شوید، چاره ای جز برندسازی مستمر و طولانی مدت برای ورود به داده های پیش آموزش آینده (مانند حضور پررنگ در خزش های Common Crawl) نخواهید داشت.
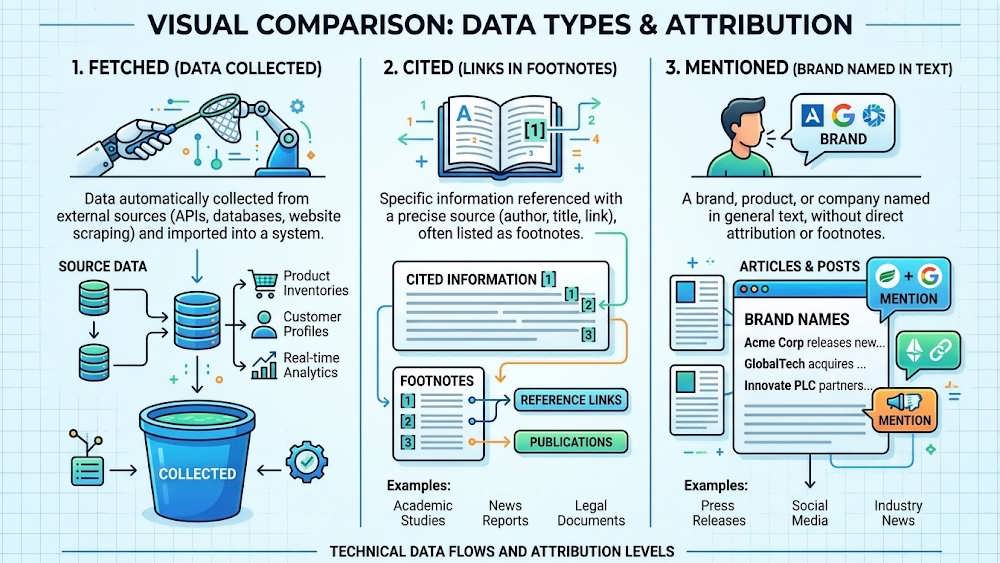
نمودار مقایسه ای سه مرحله دریافت اطلاعات (فراخوانی)، لینک دهی رسمی (ارجاع) و ذکر نام برند (نام برده شده).
چگونه یک سوال به ده ها جستجوی هم زمان تبدیل می شود؟ (Fan-Out Queries)
اگر مکالمه کامل را از API دریافت کنید، متوجه می شوید ChatGPT چه جستجوهای فرعی متعددی را در پس زمینه برای پاسخ به شما انجام می دهد. در مدل های سریع، عملکرد حداقلی است؛ یک کوئری بازنویسی شده اجرا می شود تا سرعت فدای عمق نشود. اما در مدل های تفکری (Thinking)، وقتی خواستید چند محصول را مقایسه کند، بین ۱۵ تا ۴۰ زیرکوئری مختلف را تنها از دل یک سوال بیرون کشید!
نمونه ای از جست وجوهای داخلی که برای یک دستور مقایسه ای ابزارهای هوش مصنوعی توسط سیستم اجرا شد:
"Profound AI search visibility pricing AI engines tracked 2026""AthenaHQ pricing AI search visibility tool""site:peec.ai/pricing Peec AI Starter Pro Advanced 50 prompts 150 prompts""Peec AI pricing $95 $245 $495 official"(نکته عجیب: ابتدا قیمت را حدس می زند، سپس جستجو می کند تا تایید بگیرد!)"Scrunch AI pricing"(ابزاری که من حتی در پرامپت نام نبرده بودم، اما در اواسط تحقیق پیدایش کرد و به دنبال قیمتش رفت!)- (و حدود ۴۰ جست وجوی دیگر از این دست…)
سه نکته شگفت انگیز در این رفتار وجود دارد:
- دستورهای جستجوی مستقیمی با اپراتور
:siteبه صفحات قیمت گذاری سایت ها می زند. - قیمت را پیش بینی می کند و سپس برای تایید صحت آن، صفحات رسمی را شخم می زند.
- دایره جستجو را در حین کار گسترش می دهد؛ ابزارهایی را که حتی نام نبرده اید شناسایی کرده و قیمت آن ها را هم بررسی می کند.
علاوه بر این، خواندن صفحه کاملاً مکانیکی و عینی است. ابزار مرورگر داخلی هوش مصنوعی عباراتی مانند $، €، 99 یا حتی واژه هایی مثل «Agency» را روی صفحه پیدا (Find) می کند و سپس دستورات Open و Click را در سمت سرور اجرا می کند تا محتوا را بیرون بکشد.
دقیقاً همین اتفاق برای سایت شما هم می افتد. اگر از هوش مصنوعی قیمت ابزار را بپرسید، یک کاوش با ساختار site:yourdomain.com/pricing اجرا می کند، چیزی مثل «پلن پایه ۵۸ دلار، حرفه ای ۱۴۵ دلار» را حدس می زند، سپس صفحه را باز کرده و کد HTML را برای تایید نمادهای مالی و قیمت ها جستجو می کند.
اعداد و داده های کلیدی، مشخصات فنی و جداول قیمت گذاری خود را صرفاً در قالب متن خام و کدهای استاندارد HTML بنویسید. هرگز قیمت ها را در قالب تصاویر اینفوگرافیک یا بنر قرار ندهید؛ هوش مصنوعی هنگام بررسی صفحات به دنبال نمادهایی مثل $ یا تومان/ریال در متن سند می گردد و نمی تواند تصاویر پیچیده را در این خزش سریع بخواند. از قرار دادن قیمت ها پشت دکمه های جاوا اسکریپتی (Toggle) یا بارگذاری های تنبل (Lazy-load دیرهنگام) اکیداً خودداری کنید.
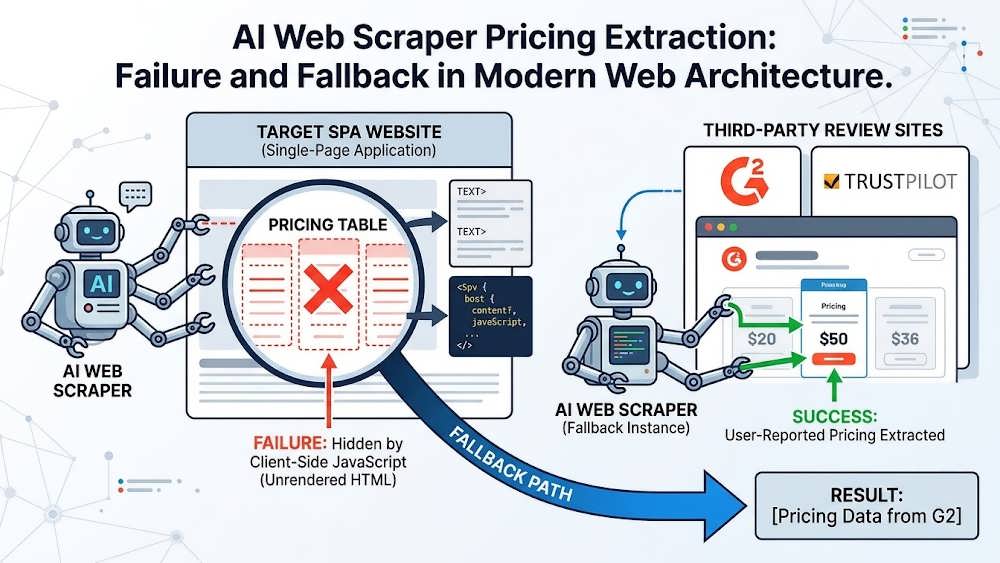
تصویر فنی نشان دهنده شکست اسکرپرها در استخراج داده های جاوا اسکریپت و ارجاع ناخواسته آن ها به سایت های واسط مانند G2.
سه اصطلاح حیاتی که نباید اشتباه بگیرید: فراخوانی شده (Fetched)، ارجاع شده (Cited) و نام برده شده (Mentioned)
اکثر متخصصان این سه مفهوم را یکی می دانند، در حالی که کاملاً مجزا هستند:
- فراخوانی شده (Fetched): زمانی که مدل صفحه شما را واکشی کرده و متن آن را وارد پنجره زمینه (Context) خود می کند. این داده همان آبجکت
result_sourceاست و کاربر هرگز آن را نمی بیند. - ارجاع شده (Cited): وقتی مدل آدرس وب سایت شما را به عنوان سند و پاورقی قابل کلیک زیر یک جمله یا ادعای مشخص درج می کند.
- نام برده شده (Mentioned): زمانی که نام برند شما در متن پاسخ می آید (گاهی اوقات با یک لینک کوچک به سایت شما)، اما وب سایت شما به عنوان منبع صحت آن ادعا انتخاب نشده است.
این ها سه فرآیند کاملاً مستقل هستند و شما در هر کدام می توانید برنده یا بازنده باشید.
برای درک بهتر این فاصله، در یک آزمایش برای کوئری های تجاری متوجه شدم که ردیت ۲۷۸ بار و یوتیوب ۲۰۱ بار فراخوانی (Fetch) شدند. اما در نتیجه نهایی، ردیت ۱۱ بار ارجاع (Cite) گرفت و یوتیوب حتی یک بار هم ارجاع نگرفت!
دلیل این موضوع کاملاً ساختاری و مکانیکی است: برای ارجاع دادن، هوش مصنوعی باید بر یک قطعه متن واضح تکیه کند. وقتی صفحه یوتیوب واکشی می شود، هوش مصنوعی در سرچ معمولی فقط عنوان و متادیتا را می گیرد نه متن کامل زیرنویس ویدیو را. در مقابل، یک تاپیک ردیت سراسر متن خوانا است. طبق تحقیق ابزار Ahrefs روی ۱.۴ میلیون پرامپت چت جی پی تی نیز ردیت ۱.۹۳٪ ارجاع داشته، در حالی که سهم یوتیوب فقط ۰.۵۱٪ بوده است.
چند الگوی مهم دیگر:
- ردیت با اختلاف اندک بیشترین دامنه ارجاع داده شده بود.
- بعد از ردیت، ارجاعات به صورت پراکنده بین سایت های بررسی تخصص مثل rtings و TechRadar و البته صفحات رسمی خود شرکت ها (برای ارجاع مشخصات و قیمت) تقسیم شده بود.
- صفحات رسمی برندها (Vendor Pages) ارجاع می گیرند، اما فقط برای مشخصات فنی و قیمت خودشان! (مثلاً سایت های زوهو یا سمراش برای قیمت پلن های خودشان ارجاع داده شدند). اما قضاوت نهایی در مورد اینکه «کدام نرم افزار بهتر است؟» به نقل از یک سایت شخص ثالث ارجاع داده می شود!
- نتایج بر اساس نام دامنه یکپارچه (Deduplicate) می شوند؛ یعنی اگر از سایت شما ۲۰ صفحه با محتوای ضعیف استخراج شود، سیستم همه آن ها را ادغام کرده و نهایتاً به چشم یک لینک به آن نگاه می کند.
شما نمی توانید در پاسخ های هوش مصنوعی «سند برتریِ خودتان» باشید! ادعای خوب یا بد بودن شما همیشه از صفحات شخص ثالث (Third-party) نقل می شود. بنابراین روی دریافت نقد و بررسی در سایت های واسط، تالارهای گفتگو و ساخت صفحات نقد صادقانه تمرکز کنید. روی یک صفحه قدرتمند و متمرکز برای هر ادعا یا ویژگی کار کنید، نه ساخت ده ها صفحه لاغر (Thin Content) و بی کیفیت.
مدل زبان بزرگ، استراتژی خودش را توضیح می دهد!
من ابتدا به دنبال یک امتیاز رتبه بندی پنهان (چیزی شبیه به فرمول اتوریتی یا وزن اعتبار سایت) در کدهای دریافتی بودم، اما هیچ فرمولی به مرورگر ارسال نمی شود؛ این محاسبات تماماً در سرورهای OpenAI انجام می گیرد. بنابراین هر کسی که ادعا می کند «فاکتورهای رسمی الگوریتم رتبه بندی ChatGPT» را می فروشد، فقط ادعایی بی اساس تحویل شما می دهد.
اما در عوض، در داده های مدل های Thinking بخشی وجود دارد که زنجیره تفکر (Chain of Thought) هوش مصنوعی را به زبان ساده توضیح می دهد.
برای درک حقایق مثل قیمت ها و مشخصات، هوش مصنوعی می گوید که اول به سراغ صفحات رسمی برندها می رود.
مثلاً در مقایسه ابزار Ahrefs، ابتدا صفحه قیمت آن را می خواند و در لاگ داخلی اش می نویسد:
«پلن لایت ۱۲۹ دلار، استاندارد ۲۴۹ دلار و ادونسد ۴۴۹ دلار ذکر شده است؛ این صفحه رسمی جدیدتر به نظر می رسد، پس باید به همین ارجاع دهم.»
اما درست بعد از این مرحله، به همان مانع بزرگی می رسد که اساس این مقاله است:
وقتی سراغ بررسی ابزار Profound می رود، مدل در زنجیره افکار خود چنین استدلال می کند:
«قیمت ها مستقیماً در نتایج جستجو دیده نمی شوند؛ احتمالاً به این دلیل که با جاوااسکریپت بارگذاری می شوند (loaded with JavaScript).»
همین اتفاق برای ابزار Peec هم رخ می دهد:
«قیمت ها مستقیماً نشان داده نمی شوند، احتمالاً پشت جاوااسکریپت پنهان هستند.»
و نتیجه چیست؟ مدل زبان از خواندن صفحه رسمی ناامید شده و عقب نشینی می کند:
«از آنجا که پارس کردن (تجزیه) صفحه رسمی دشوار است و قیمت ها را نشان نمی دهد، می توانم از منابع شخص ثالث نقل قول کنم… و در صورت لزوم به نقد سایت G2 ارجاع دهم.»
این تمام بازی در یک سناریوی واقعی است! مدل می خواست قیمت را از سایت اصلی شرکت نقل کند، اما به دلیل ساختار سنگین جاوااسکریپت نتوانست آن را بخواند؛ بنابراین به سراغ سایت واسط G2 رفت! قیمت مال شماست، محصول مال شماست، اما ارجاع و ترافیک به سایت دیگری می رسد!
مالکیت داده هایتان را با HTML تمیز و استاندارد پس بگیرید! ارقام قیمت و امکانات شما باید به عنوان متن ساده و خوانا در کد صفحه وجود داشته باشند. جدول قیمت جاوااسکریپتی نه تنها سئوی بدی دارد، بلکه اعتبار و ورودی شما را دو دستی تقدیم مراجع نقد و بررسی مثل G2 می کند. در خدمات بهینه سازی فنی، یکی از ماموریت های ما در «دانش وب» سبک سازی کدهای فرانت اند و تضمین دسترس پذیری دیتای مهم برای ربات های هوش مصنوعی بدون اتکای صرف به رندرهای سمت کلاینت است.
آنچه نتوانستم در داده های شبکه ببینم
- الگوریتم قطعی رتبه بندی: همان طور که گفته شد، چرایی برتری یک لینک به دیگری در سمت سرور تعیین می شود و در ترافیک کلاینت ثبت نمی گردد.
- شخصی سازی (Personalization): چت جی پی تی در مواردی مکالمات قبلی من را تحت فیلد
personal_sources: ["convo_search", "gmail", "files"]وارد پاسخ کرد؛ به این معنی که بخشی از پاسخ ها بر پایه دیتای خصوصی هر کاربر شکل می گیرد و بهینه سازی عمومی برای آن ها ناممکن است. - محدودیت سئو محلی (Local SEO): یک متغیر پیکربندی به نام
local_results_limitبا مقدار عدد ۲ وجود دارد. یعنی وقتی می پرسید «بهترین کافه های نزدیک من»، چت جی پی تی فقط ۲ گزینه معرفی می کند نه فهرستی از ۱۰ مورد! پس در سئو محلی هوش مصنوعی، یا باید جزو دو مورد اول باشید، یا عملاً غایبید.
چطور خودتان این موارد را در مرورگر بررسی کنید؟
شما برای مشاهده این لاگ ها به هیچ نرم افزار عجیب و دسترسی خاصی نیاز ندارید؛ تنها به مرورگر معمولی خودتان نیاز دارید:
- چت جی پی تی را باز کنید.
- کلیدهای
Cmd + Option + I(در مک) یاCtrl + Shift + I(در ویندوز) را بزنید تا DevTools باز شود. - به تب Network بروید و تیک گزینه Preserve log را بزنید.
- سوال خود را از چت جی پی تی بپرسید.
- کلیدهای
Cmd + Option + F(یاCtrl + Shift + F) را بزنید و در بخش سرچ عبارتresult_sourceرا جستجو کنید تا نحوه تامین لینک ها را ببینید.
اگر به دنبال جزئیات بیشتر مثل جستجوهای زنجیره ای (Fan-out) و دلایل مدل استدلالی هستید، تب Console را باز کرده و کد جاوا اسکریپت زیر را در صفحه ای که جستجوی وب انجام داده اجرا کنید:
javascript
const t = (await (await fetch('/api/auth/session')).json()).accessToken;
const c = await (await fetch('/backend-api/conversation/' + location.pathname.split('/c/')[1], {headers: {Authorization: 'Bearer ' + t}})).json();
const rows = [];
JSON.stringify(c, (k, v) => {
 if (v && v.result_source) {
 const d = (v.attribution || v.url || '?').toString();
 rows.push({source: d.replace('https://', '').replace('www.', '').split('/')[0], pipeline: v.result_source});
 }
 return v;
});
console.table(rows);
این اسکریپت ساده یک جدول مرتب از منابع و پایپ لاین های استخراج آن (Labrador، Bright، Oxylabs یا SERP) را بدون خروج اطلاعات از رایانه تان برای شما چاپ می کند.
همچنین اولیویه دو سگونزا (Olivier de Segonzac) یک افزونه رایگان کروم توسعه داده که تمامی این شاخص ها شامل دسته بندی turn_use_case، سهم انواع رفرنس ها و نوع اسکرپرها را بدون نیاز به کنسول استخراج کرده و به صورت خروجی اکسل تحویل می دهد.
نتیجه گیری
آیا توصیه های سنتی سئو برای هوش مصنوعی درست کار می کنند؟ تا حد زیادی بله؛ ردیت هنوز قدرتمند است، مقالات بررسی و تحلیلی بخش اعظم داده ها را پوشش می دهند و محتوای باکیفیت حیاتی است. اما تنها محتوایی که ربات واقعاً بتواند آن را بدون دردسر بخواند! بقیه محتواها به نفع رقبای شخص ثالث کنار گذاشته می شوند.
درس بزرگ این است: چت جی پی تی یک موتور جستجو نیست؛ پس دست از سئو کردن سایت به روش های منسوخ موتورهای جستجوی کلاسیک بردارید. هوش مصنوعی برای استخراج حقایق، آمار و قیمت ها مستقیماً به سایت شما می آید (به شرطی که ساختار کدنویسی شما شفاف و در قالب HTML خالص باشد)؛ اما برای ارزیابی اعتبار، شهرت و قضاوت درباره کیفیت شما، به سراغ نظرات دیگران و سایت های نقد و بررسی می رود. اگر این تفکیک وظایف و ساختار فنی را در توسعه وب سایت خود لحاظ کنید، برگ برنده در دستان شما خواهد بود.