

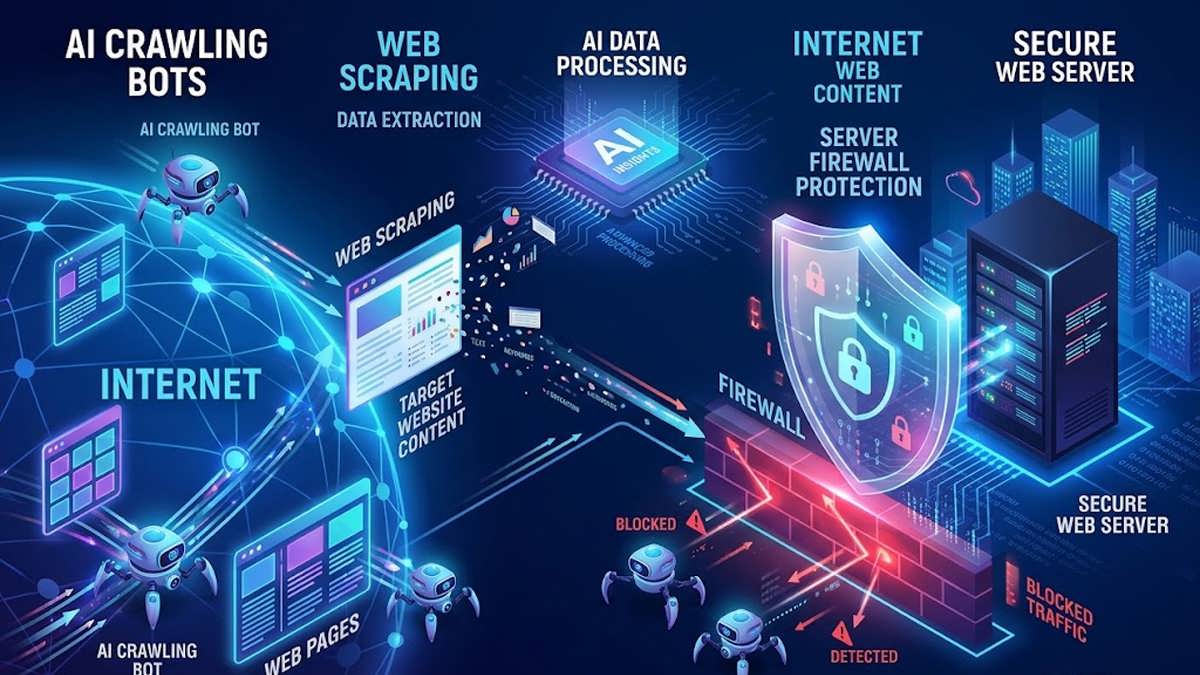
ربات های رایجی که به شکل مستمر به سایت ها سر می زنند، عموماً خزنده هایی هستند که ما مشتاق حضورشان هستیم؛ مانند خزنده های موتورهای جستجو (گوگل بات و بینگ بات). البته این ها تنها ربات های وب نیستند، هرچند بیشترین حجم پهنای باند را مصرف می کنند. در کنار ربات های جستجوگر، خزنده های ابزاری نیز حضور دارند؛ از جمله ربات های مانیتورینگ آپ تایم، خزنده های ابزارهای تحلیلی و ابزارهای اسکن آسیب پذیری و امنیت.
صاحبان سایت همواره باید سبک سنگین کنند که آیا اجازه ورود به یک خزنده، فایده بیشتری دارد یا آسیب زننده است. برای نمونه، مسدودسازی ربات هایی که به قصد اسکرپ (Scraping) کردن قیمت ها و دیتابیس محصولات می آیند یا ربات های مخربی که به دنبال نفوذ به بخش لاگین هستند، تصمیم ساده ای است؛ چرا که مالکیت معنوی و امنیت سایت را به خطر می اندازند.
اما خزنده های هوش مصنوعی جایی در این میانه اند؛ نه کاملاً مخرب هستند و نه همیشه مفید. به طور کلی، این خزنده ها به ۳ دسته تقسیم می شوند:
۱. ربات های آموزش هوش مصنوعی (AI Training Bots)
این خزنده ها (مانند GPTBot متعلق به OpenAI) وب را زیر و رو می کنند تا داده های آموزشی مدل ها را تأمین کنند. هدف آن ها ساخت پایگاه دانشی است که مدل های زبانی بزرگ (LLMها) از آن برای درک موجودیت ها (Entities) و روابط میان مفاهیم بهره می برند.
این گروه، مناقشه برانگیزترین خزنده ها هستند. هدف اولیه آن ها بازگرداندن ترافیک به سایت شما نیست؛ بلکه خواندن و بلعیدن محتوا برای ارتقای مدل هاست. در مواردی، همین محتوا بعداً برای پاسخ به کاربران بدون ارجاع به منبع اصلی استفاده می شود. بنابراین، پیدا کردن رابطه ای مستقیم میان هزینه خزش آن ها و ایجاد ارزش تجاری، کار بسیار دشواری است.
۲. ربات های نمایه سازی جستجو (Search Indexing Bots)
خزنده هایی نظیر OAI-SearchBot صفحه ها را بازبینی و داده ها را ذخیره می کنند تا سایت ها را در «نتایج جستجوی هوش مصنوعی» نمایش داده و لینک دهند؛ نه اینکه مستقیماً پایگاه مدل های پایه را آموزش دهند.
توجیه باز گذاشتن مسیر برای این دسته آسان تر است؛ زیرا رفتاری مشابه موتورهای جستجوی کلاسیک دارند. وقتی محتوای شما را ایندکس می کنند تا در پاسخ های هوش مصنوعی با استناد (Cite) به شما پیوند داده شود، مسیر واضح تری برای دستیابی به دیده شدن، ترافیک ورودی و آگاهی از برند ایجاد می شود.
۳. فراخوانی های ناشی از دستور کاربر (User-Triggered Fetches)
خزنده هایی مانند ChatGPT-User صفحه ها را در لحظه و بر اساس درخواست مستقیم کاربر فراخوانی می کنند. این ربات ها زمانی وارد سایت می شوند که کاربر در پرامپت خود بررسی سند یا آدرس مشخصی را بخواهد، نه اینکه صرفاً به ایندکس قبلی متکی باشد.
این نوع فراخوانی نشان دهنده علاقه واقعی و مستقیم مخاطب به سایت شماست. کاربر به طور مشخص به دنبال کسب اطلاعات بیشتر درباره کسب وکار، مقالات یا خدمات شماست؛ این اتفاق نشان می دهد کاربر در بخش های عمیق قیف فروش (Purchase Funnel) قرار دارد و حضور این ربات نویدبخش جذب مخاطب راغب است.
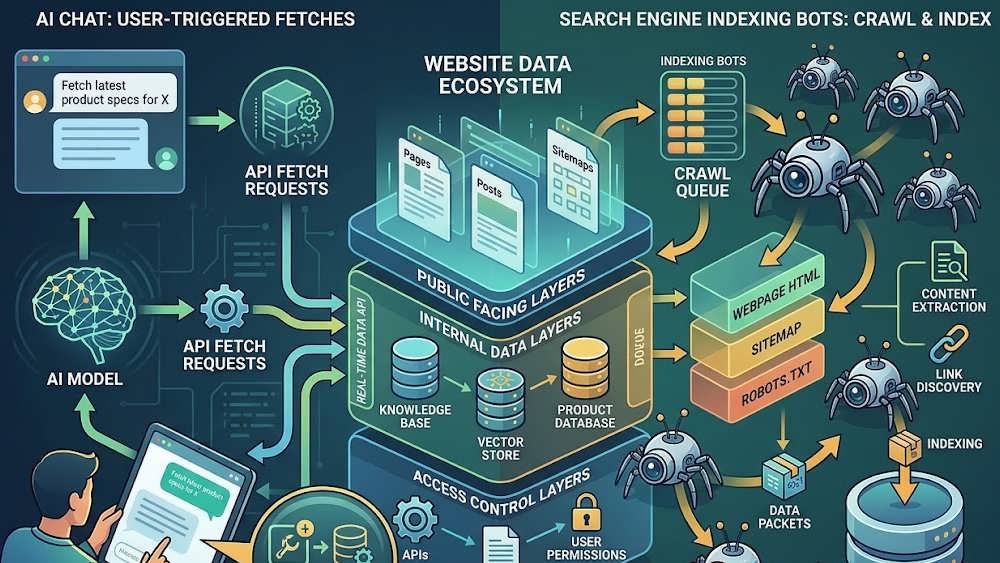
نمایشی از عملکرد ربات های مبتنی بر درخواست مستقیم کاربر و تعامل زنده با محتوای وب سایت.
نحوه مسدودسازی ربات های هوش مصنوعی
شرکت OpenAI مدتی پیش مستندات خود را به روزرسانی کرد و اعلام نمود خزنده ای مانند ChatGPT-User (که بر اثر درخواست مستقیم کاربر فعال می شود) الزامی به تبعیت کامل از فایل robots.txt سایت ندارد. خزنده های دیگری نظیر Perplexity-User نیز رویکردی مشابه در پیش گرفته اند.
بنابراین، فایل robots.txt که سئوکاران سال ها به عنوان ابزاری مطمئن به آن تکیه می کردند، اکنون تنها ربات های آموزشی و خزنده های مطیع را متوقف می کند. برای مهار کامل ربات های مستقل و رفتار های غیرپایبند به robots.txt، باید به سراغ مسدودسازی در سطح سرور یا فایروال وب (WAF) بروید.
مسدودسازی در سطح فایروال ابری (WAF-Level Blocking)
یک فایروال برنامه وب (WAF) پیش از سرور اصلی سایت قرار می گیرد و نقش یک گیت بازرسی قدرتمند را ایفا می کند. فایروال را می توان طوری تنظیم کرد که تنها ربات های مجاز امکان عبور داشته باشند، یا اینکه دسترسی گروهی از خزنده های مسدودشده به کل قطع شود. این شیوه، مطمئن ترین راهکار برای مهار خزنده های ناخواسته است.
اگرچه این موضوع در حوزه فنی وب مسترها و مهندسان زیرساخت قرار دارد، اما احتمالاً نام ارائه دهندگانی همچون Cloudflare یا AWS را شنیده اید. در وب سایت های ایرانی نیز برای تنظیم دقیق لایه های WAF و مهار هزینه های پهنای باند، هماهنگی میان تیم سئو و زیرساخت ضرورت دارد؛ امری که ما در پروژه های توسعه و سئوی تکنیکال دانش وب همواره آن را در اولویت پیکربندی سرور قرار می دهیم.
قوانین سطح سرور (Server Rules)
می توان دستوراتی را مستقیماً در فایل پیکربندی سرور (مانند .htaccess در آپاچی یا nginx.conf در انجین اکس) اعمال کرد تا ترافیک ورودی را ارزیابی کند. سرور بررسی می کند که آیا درخواست از منبعی خودکار ارسال شده یا هدرهای استاندارد (User-Agent Headers) مخدوش هستند یا خیر. در صورت عدم تطابق با الگوهای ایمن، مسیر اتصال ربات بی درنگ مسدود خواهد شد.
خطرات مسدودسازی کامل تمام ربات های هوش مصنوعی
اینجاست که تناقض اصلی آشکار می شود: برخی خزنده های هوش مصنوعی بدون اجازه، مالکیت فکری شما را کپی می کنند؛ اما اگر آن ها را یکسره مسدود کنید، برند، محصولات و خدمات شما از پاسخ های تولیدشده توسط ابزارهای هوش مصنوعی حذف شده و دست بالا را به رقبایتان می دهید.
- حذف از پاسخ های هوش مصنوعی: اصلی ترین ریسک این است که دیگر در استنادات چت بات ها جایی نخواهید داشت. هرچند شاید حجم ترافیک ارجاعی در حال حاضر چشمگیر نباشد، اما حذف شدن از این چرخه به معنی کاهش سهم ذهنی مخاطب است.
- رشد آگاهی از برند رقبا: حتی اگر موتورهای زبانی بزرگ ترافیک بالایی نفرستند، نام برندهایی که در پاسخ هایشان می آورند در خاطر کاربر ثبت می شود. اگر نام شما نباشد، قطعا رقیب شما معرفی خواهد شد.
- تحولات بنیادین در نحوه جستجو: دنیای هوش مصنوعی شتابان به پیش می رود. کم بودن ترافیک فعلی به معنای کم ماندن آن در آینده نیست. اگر هوش مصنوعی به شیوه اصلی کشف اطلاعات تبدیل شود، سایتی که دسترسی ربات ها را بسته، عملاً به یک سایت نامرئی بدل خواهد شد.
- از دست دادن فرصت یادگیری و آزمایش (Test and Learn): اگر تمامی ورودی ها را مسدود کنید، هیچ گاه امکان ارزیابی این را نخواهید داشت که کدام پلتفرم محتوای شما را به درستی درک می کند، کدامیک به شکلی منصفانه به شما لینک می دهد و کدام ابزار پتانسیل تبدیل شدن به کانال ورودی سودآور را دارد.
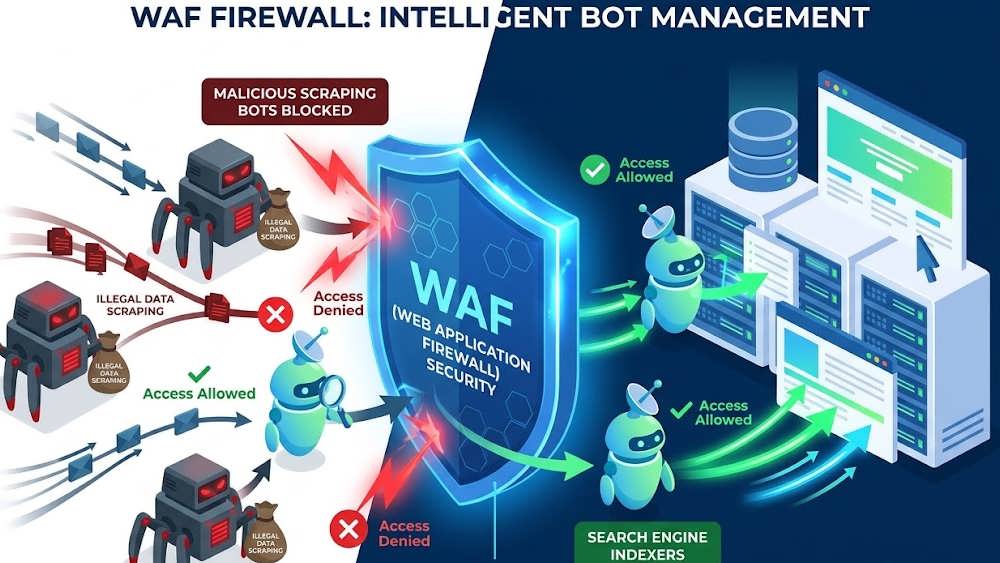
نمایشی از عملکرد فایروال در تفکیک خزنده های مفید از ربات های اسکرپر و مخرب.
خطرات باز گذاشتن کامل دسترسی همه ربات های هوش مصنوعی
در طرف مقابل، رها کردن سایت بدون هیچ کنترلی نیز خطرات مهلکی به همراه دارد که مهم ترین آن ها مصرف بی رویه منابع و سرقت داده است:
آموزش مدل ها بر بستر دارایی های فکری شما (Training On Intellectual Property)
بسیاری از مالکان سایت ها و تولیدکنندگان محتوا از اینکه مقالات، تجارب و سرمایه های فکری آن ها بدون پرداخت حق امتیاز یا ارجاع لینک، صرف آموزش مدل ها شود، احساس نارضایتی شدیدی دارند. این اعتراض شایع میان کارشناسان وجود دارد: «آن ها محتوای مرا می برند، اما دریغ از یک بازدیدکننده که به سایتم بفرستند!»
این مسئله به ویژه برای سایت هایی که مزیت رقابتی شان متکی بر اطلاعات تخصصی، تحلیل های یونیک و محتوای منحصربه فرد است، بسیار آسیب زننده است. همچنین خطر بسته بندی مجدد (Repackaging) داده ها وجود دارد؛ جایی که هوش مصنوعی داده های شما را که بخشی از محصول یا خدمات پولی شماست بازنویسی کرده و رایگان در اختیار مخاطب می گذارد. مشابه وضعیتی که هنرمندان شاهد الهام گیری بی اجازه هوش مصنوعی از سبک کاری خود هستند.
هزینه های سرسام آور خزش
خزنده های هوش مصنوعی اشتهای سیری ناپذیری برای بلعیدن منابع سرور دارند. گزارش های متعددی وجود دارد که نشان می دهد این ربات ها صفحه های سایت را بسیار پربسامدتر از ربات های سنتی مانند گوگل بات بازخوانی می کنند.
این موضوع در حالت عادی ممکن است در فاکتورهای هاست پنهان بماند، اما با افزایش صفحات و مقیاس سایت، مصرف پهنای باند و منابع پردازشی (CPU و RAM) جهش می یابد. نتیجه نهایی، افت شدید سرعت سایت و کندی بارگذاری برای کاربران واقعی است؛ موضوعی که در نهایت تصمیم مدیران را به سمت مسدودسازی قطعی می برد.
چگونه خزنده های ورودی به سایتمان را شناسایی کنیم؟
بزرگ ترین مانع در تحلیل سود و زیان ربات های هوش مصنوعی، ناآگاهی از این است که اصلاً کدام خزنده ها به سایت ما وارد می شوند. برای پایش این موارد، از دو روش کلیدی استفاده کنید:
۱. تحلیل فایل های لاگ سرور (Log Files)
فایل های لاگ سرور، موثق ترین و دست اول ترین داده ها را به شما می دهند. با استخراج یک نمونه ۳۰ روزه از لاگ های سرور، می توانید به سادگی سهم خزنده های هوش مصنوعی را از کل خزش های وب سایت محاسبه کنید.
در لاگ ها انواع ربات ها با هدرهای اختصاصی موسوم به User-Agent ثبت می شوند. ابزارهای مدرن آنالیز لاگ فایل و نرم افزارهای پایش هوش مصنوعی (AI Visibility Tracking Tools) به راحتی این خزنده ها را دسته بندی می کنند.
نکته کلیدی: دقت کنید که آیا یک ربات خاص، روی دایرکتوری های مشخصی مثل صفحات محصولات زوم کرده است؟ اگر خزنده ای صفحات قیمت و محصول شما را هدف گرفته باشد، متوجه می شوید کدام دارایی شما برای آن پلتفرم ارزشمند است. این تحلیل به شما کمک می کند تا به جای بستن کل سایت، فقط دسترسی به پوشه های حساس را محدود کنید.
۲. بررسی ترافیک ارجاعی (Referral Traffic)
اگر به فایل های لاگ سرور دسترسی مستقیم ندارید، ابزارهای تحلیلی مانند گوگل آنالیتیکس ۴ (GA4) راهکار دوم شما هستند. بررسی کنید چه میزان ورودی از سوی ChatGPT یا Perplexity هدایت شده است.
گوگل آنالیتیکس کانال جدیدی به نام «AI Assistant» معرفی کرده است که کاربران ورودی از پلتفرم های هوش مصنوعی را تفکیک می کند. البته در حال حاضر این کانال صرفاً ورودی های ناشی از هدر ارجاع دهنده ChatGPT، Gemini و Claude را به عنوان دستیار هوش مصنوعی لحاظ می کند و ورودی های Perplexity را شامل نمی شود. با این حال، ترافیک ورودی از این پلتفرم ها سندی است بر اینکه ربات آن ها حتماً صفحه ای از سایت شما را ایندکس کرده است.
چه داده های تکمیلی دیگری نیاز داریم؟
برای تحلیل جامع، تنها دانستن نام ربات کافی نیست؛ باید موارد زیر را نیز مشخص کنید:
- صفحات فرود خزش شده: باید مشخص شود ربات دقیقاً کدام آدرس ها را خزش کرده و آیا این صفحات جزو اطلاعات خصوصی/استراتژیک شرکت هستند یا خیر.
- برآورد هزینه سرور: این دیتا باید از مدیر سرور یا هاستینگ دریافت شود. باید به روشنی محاسبه شود خزش های افراطی هر ربات چقدر مصرف ترافیک و هزینه بر دوش مجموعه می گذارد.
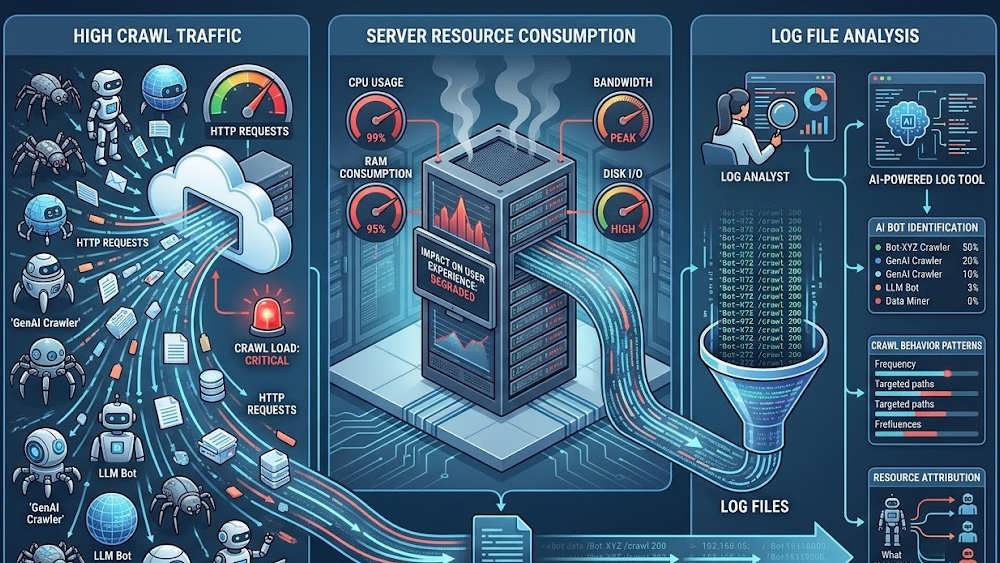
بررسی ترافیک خزنده ها، پایش مصرف پردازنده و پهنای باند سرور در مواجهه با ربات ها.
نحوه سنجش و اندازه گیری ارزش واقعی (Measuring Value)
مرز میان باز گذاشتن یا بستن یک خزنده، در ارزش خالصی است که آن ربات برای شما می سازد.
باید پذیرفت که مدل های زبانی ترافیک بسیار کمتری نسبت به موتورهای جستجوی کلاسیک به سایت ها روانه می کنند. داده های رسمی کلودفلر نشان می دهد که به عنوان نمونه، ربات هوش مصنوعی Claude متعلق به آنتروپیک، به ازای هر یک بازدیدکننده ارجاعی، حدود ۷۰٬۹۰۰ بار درخواست خزش (Page Request) به سرور ارسال کرده است؛ در حالی که این نسبت خزش به بازدید برای موتور جستجوی گوگل تنها ۹.۴ به ۱ است! این نسبت سرسام آور نشان می دهد برای یک بازدیدکننده چه هزینه سنگینی در پس زمینه رخ می دهد.
با این وجود، ارزش را باید در شاخص های زیر سنجید:
۱. کیفیت ترافیک ارسالی
آیا کاربرانی که از سوی هوش مصنوعی می آیند، نرخ تعامل بالایی دارند؟ زمان ماندگاری و مسیر حرکت آن ها در سایت چگونه است؟ در بسیاری از مواقع، کاربری که از هوش مصنوعی می آید پاسخی آماده در ذهن دارد و به قصد خرید یا تصمیم گیری نهایی کلیک کرده است. این کاربران هرچند اندک، ممکن است با نرخ تبدیل بالا خریدار نهایی خدمات شما شوند.
۲. استنادها و نام برده شدن ها (Citations & Mentions)
ترافیک همه چیز نیست. شاید کاربری روی لینک سایت کلیک نکند، اما معرفی شرکت شما در متن پاسخ هوش مصنوعی، جایگاه برندتان را در ذهن او تثبیت می کند (مانند کاربری که بعد از دیدن نام فروشگاه شما در نقشه گوگل، حضوری به فروشگاه سر می زند). میزان تکرار نام برندتان در پرامپت های مربوط به حوزه کاری تان را رصد کنید.
۳. لحن و حس کلام (Sentiment Analysis)
آیا هوش مصنوعی اطلاعات دقیق و مثبتی درباره خدمات شما به کاربر ارائه می دهد؟ اگر مدلی به طور مرتب اطلاعات غلط و آسیب زننده درباره خدمات شما سرهم بندی (Hallucination) کند، اجازه دادن به خزش آن تنها باعث لطمه زدن به اعتبار و حسن شهرت برند شما خواهد شد.
۴. پوشش موضوعی در برابر رقبا (Query/Topic Coverage)
بررسی کنید زمانی که مخاطبان خدمات اصلی حوزه کاری شما را جستجو می کنند، هوش مصنوعی نام چه کسانی را پیشنهاد می دهد؟ اگر رقبای شما حضور پررنگی دارند و نام شما غایب است، بستن ربات ها شما را بیش از پیش به انزوا خواهد برد.
۵. پیش بینی ارزش در آینده (Future Value)
همیشه نگاه بلندمدت داشته باشید. خزنده ای که امروز شاید بازدید کمی تولید کند، ممکن است متعلق به پلتفرمی باشد که در آینده سهم اصلی جستجوی وب را از آن خود کند؛ ارزیابی ها نباید صرفاً بر پایه آمارهای محدود یک یا دو هفته گذشته باشد.
ماتریس تصمیم گیری: فرمول انتخاب استراتژی برای هر ربات
برای اینکه به سادگی درباره هر ربات تصمیم بگیرید، ماتریس زیر را بر اساس پاسخ به ۵ پرسش اساسی بسازید:
[ ارزیابی هر خزنده هوش مصنوعی ]
- آیا این ربات ترافیک باکیفیت، لید یا دیده شدن برند به همراه دارد؟
- آیا محتوای محرمانه و کپی رایت اختصاصی ما را اسکرپ می کند؟
- چقدر هویت خزنده معتبر و دارای مستندات رسمی است؟
- آیا هزینه منابع سرور ناشی از خزش آن به تجربه کاربران آسیب می زند؟
- آیا حذف شدن از پلتفرم این ربات، به مزیت رقابتی ما ضربه می زند؟
با پاسخ به موارد فوق، ربات ها را در یکی از ۳ گروه زیر قرار دهید:
| وضعیت تصمیم | مشخصات خزنده | رویکرد پیشنهادی |
|---|---|---|
| حفظ و پذیرش (Keep) | هزینه کم سرور، اعتبار بالا، ایجاد آگاهی از برند، ارسال ترافیک باکیفیت و استناد دقیق | باز گذاشتن کامل دسترسی در سطح robots.txt و سرور |
| پایش و محدودسازی (Restrict / Monitor) | ارزش نامشخص، هزینه سرور معمولی، عدم وضوح کامل مسیر بازگشت سرمایه | اعمال محدودیت در نرخ خزش (Rate-Limiting) و مسدودسازی دسترسی به صفحات حساس |
| مسدودسازی کامل (Block) | مصرف منابع فوق العاده سنگین، رفتار تهاجمی، سرقت داده های اختصاصی، نبود سودمندی تجاری | بستن کامل از طریق لایه WAF، کلودفلر و تنظیمات مستقیم سرور |
نتیجه گیری
کنترل دسترسی خزنده های هوش مصنوعی یک پروژه تمام شده و غیرقابل تغییر نیست. دنیای هوش مصنوعی هر روز میزبان ابزارهای نوظهور است و رفتارهای الگوریتمی با سرعت جابه جا می شوند.
بررسی فصلی (Quarterly Reviews): فهرستی را که مسدود کرده اید هر ۳ ماه یک بار بازبینی کنید. ممکن است خزنده ای که سال گذشته ارزش چندانی نداشته، اکنون کانال ترافیکی موثری شده باشد.
تعامل مداوم تیم بازاریابی و زیرساخت: تیم سئو باید پیوسته با متخصصان شبکه و سرور در تعامل باشد تا تعادل میان هزینه های میزبانی و اهداف برندینگ پایدار بماند.
سیاست «یا همه را ببندیم یا همه را باز بگذاریم» یک خطای استراتژیک است. رفتار حرفه ای حکم می کند هر خزنده را یک سناریوی تجاری مستقل (Business Case) بدانید و منابع زیرساختی تان را با هوشمندی صرف کانال هایی کنید که بیشترین آورده را برای رشد بیزینس شما دارند.