

چت جی پی تی جستجوهای انشعابی خود را به سایت هایی محدود کرده است که از قبل به آن ها اعتماد دارد. به نظر می رسد استفاده از عملگر :site روشی برای کاهش نتایج اسپم باشد. بیایید ببینیم تحقیقات اخیر صنعت سئو چه حقایقی را برملا می کنند.
در چند ماه گذشته، من با دقت و وسواس زیادی به بررسی نحوه تکامل «کوئری های انشعابی» (Fan-Out Queries) در ChatGPT پرداخته ام. (توضیح مترجم: کوئری های انشعابی، جستجوهای پنهان و متعددی هستند که هوش مصنوعی قبل از پاسخ دادن به کاربر، در پس زمینه انجام می دهد تا اطلاعات را جمع آوری کند).
اهمیت کوئری های انشعابی در سئوی هوش مصنوعی
تحولات بسیار جالبی در این زمینه رخ داده است که به باور من، کیفیت پاسخ های ChatGPT را به کلی تغییر می دهد. مدت هاست روی این مقاله کار می کنم، اما نوشتن آن به شدت دشوار بود؛ چرا که در دنیای «سئوی هوش مصنوعی (AEO)»، سرعت تغییر اطلاعات بسیار بیشتر از سرعت نوشتن من است!
این تغییرات سریع، به ویژه در مورد نحوه اصلاح و بهینه سازیِ فرآیند استخراج اطلاعات از وب (از طریق تکنولوژی RAG) توسط OpenAI کاملاً مشهود است. ChatGPT اکنون به شدت به استفاده از عملگر جستجوی :site در کوئری های انشعابی خود وابسته شده است و احتمالاً از آن برای گلچین کردن نتایج از منابعِ باکیفیت تر استفاده می کند.
خلاصه کلام (TL;DR): به اعتقاد من، شرکت OpenAI از کوئری های انشعابی (و به طور خاص عملگر :site) به عنوان فیلتری برای کاهش خروجی های اسپم و بی کیفیت در پاسخ های خود استفاده می کند. این تلاش آن ها برای بهبود کیفیت منابعِ استخراج شده و برداشتن گام های اولیه برای مبارزه با اطلاعات زرد در نتایج است. این رویکرد دقیقاً من را یاد سیستم E-E-A-T (تجربه، تخصص، اعتبار و اعتماد) گوگل می اندازد، اما این بار به سبک ChatGPT!
تحلیل این کوئری های انشعابی بسیار مهم است، زیرا ChatGPT برای یافتن پاسخ هایش از موتورهای جستجو استفاده می کند؛ و این اساساً یک مسئله سئو (SEO) است. هر کلمه ای که مدل هوش مصنوعی تصمیم می گیرد در جستجوی انشعابی خود قرار دهد و هر عملگری که به کار می برد، به ما نشان می دهد که مدل دقیقاً به دنبال چیست و انتظار دارد آن را در کجای نتایج جستجو پیدا کند.
وقتی هوش مصنوعی جستجوی خود را با :site محدود می کند، کلمه «رسمی» (Official) را به آن می افزاید، یا مستقیماً به یک ساب ردیت (انجمن) خاص اشاره می کند، در واقع دارد به ما می گوید که از نظر او، چه نوع محتوایی بهترین پاسخ برای کاربر است. (ما در تیم سئوی دانش وب همواره تاکید می کنیم که درک همین الگوهای رفتاریِ ربات ها، مرز بین موفقیت و شکست در سئوی مدرن است). این کوئری ها نزدیک ترین راهی هستند که می توانیم بفهمیم چرا ChatGPT اطلاعات خاصی را بیرون می کشد و استخراج می کند.
افراد متخصص و فوق العاده ای در صنعت ما هستند که با بررسی ترافیک خام، استخراج فایل های مکالمه و بیرون کشیدن داده های انشعابی از API، تحقیقات بی نظیری روی سازوکار درونی ChatGPT انجام داده اند. داده های آن ها اکنون به نتایج مشترکی رسیده است. من در این مقاله، یافته های این محققان را با مشاهدات خودم (با استفاده از ابزارهایی نظیر Peec AI، Profound، افزونه Resoneo، FanoutFox و سرچ کنسول گوگل) ترکیب کرده ام تا اولاً تمام یافته ها را یکجا به شما ارائه دهم و ثانیاً تحلیل خودم را از اهمیت این تکامل بیان کنم.
این تصویر یک نمای مفهومی و دیجیتال از فرآیند کوئری های انشعابی و جستجوی پیشرفته هوش مصنوعی با عملگر سایت را نشان می دهد.
مکانیزم عملکرد کوئری های انشعابی ChatGPT چگونه است؟
همه درخواست ها در ChatGPT منجر به جستجو در وب نمی شوند. هر چیزی که در داده های آموزشیِ مدل وجود داشته باشد، به سرعت و بدون نیاز به RAG (تولید افزوده شده با بازیابی) پاسخ داده می شود. مدل های رایگان یا ارزان ترِ OpenAI نیز تمایل بیشتری به استفاده از داده های آموزشیِ خود دارند، زیرا تولید پاسخ از این طریق برایشان ارزان تر تمام می شود.
اما زمانی که سوال کاربر نیازمند اطلاعات به روز باشد، ChatGPT با استفاده از جستجوی وب (RAG)، اطلاعات را از منابع مختلفی از جمله داده های موتورهای جستجوی خارجی و ایندکس داخلی خودش (به نام Labrador) بیرون می کشد.
وقتی سؤالی می پرسید که باعث تریگر شدن (تحریک) جستجوی وب می شود، ChatGPT پرامپت شما را به مجموعه ای از جستجوهای پس زمینه (کوئری های انشعابی) تجزیه می کند، آن ها را به صورت موازی اجرا کرده و از نتایج به دست آمده، یک پاسخ جامع می سازد. نظارت بر نحوه تغییر این کوئری ها در طول زمان، رازهای زیادی را درباره تلاش OpenAI برای تولید نتایج بهتر فاش می کند.
در اینجا باید دو اصطلاح رایج را که معمولاً با هم اشتباه گرفته می شوند، تعریف کنیم:
- بازیابی شده (Retrieved): صفحه ای که ChatGPT در حین اجرای کوئری های انشعابی خود آن را پیدا کرده و واکشی کرده است.
- استناد شده (Cited): صفحه ای که در نهایت به عنوان یک «لینک منبع» در پاسخِ قابل مشاهده برای کاربر، درج شده است.
استناد و بازیابی رفتارهای متفاوتی دارند و در حال حاضر در دو جهت مخالف حرکت می کنند: تعداد URLهای «بازیابی شده» در حال افزایش است، در حالی که آمارها نشان می دهد تعداد دامنه های یکتای «استناد شده» در هر پاسخ در حال کاهش است. یعنی صفحات بیشتری برای یافتن پاسخ بررسی می شوند، اما به صفحات کمتری اعتبار و لینک داده می شود!
برای خواندن کوئری های انشعابی واقعی (و نه فقط پاسخ نهایی)، من از ابزارهایی مانند Peec AI و افزونه های مرورگر مانند Resoneo و FanoutFox استفاده می کنم که به ما اجازه می دهند در لحظه، نحوه «تفکر و جستجو» مدل را تماشا کنیم.
زمان بندی انتشار مدل ها نیز مهم است. ChatGPT نسخه ۵.۶ در چند نوع عرضه شد: نسخه Sol (استاندارد) و نسخه ارزان تر Luna که از اوایل آگوست به عنوان مدل پیش فرضِ کاربران رایگان معرفی شد. با توجه به اینکه بیش از ۹۰٪ کاربران ChatGPT از نسخه رایگان استفاده می کنند، بررسی رفتار نسخه پیش فرضِ رایگان از اهمیت بالایی برخوردار است.
بخش اول: تحقیقات صنعت سئو چه چیزی را نشان می دهد؟
برای درک دقیق تر این تغییرات، بیایید نگاهی به نتایج تحقیقات میدانی و مشاهدات کارشناسان برجسته سئو بیندازیم.
مشاهدات من در تحقیقات شخصی ام
قبل از بررسی داده های دیگران، چند الگوی جالب توجه من را جلب کرد:
۱. مدل های بهتر، بیشتر جستجو می کنند و بیشتر به عملگر :site تکیه می کنند. در تست های من، مدل ChatGPT 5.4 Thinking برای یک پرامپت بیش از ۱۰ جستجو انجام می داد (شامل چندین جستجوی :site)، در حالی که مدل 5.3 Instant فقط ۲ تا ۳ انشعاب داشت.
۲. نوع جستجوی :site به نوع کوئری بستگی دارد. برای نظرات و نقد محصولات، مدل به شدت به پلتفرم هایی مثل Reddit (حتی ساب ردیت های خاص) تکیه می کند. برای سوالات حساس به اصطلاح YMYL (موضوعات مرتبط با سلامت، قانون و مالی)، به شدت منابع معتبر مانند دامنه های .gov یا .org را ترجیح می دهد. در آزمایشی با ۲۰ پرامپت حقوقی، تمام استنادها فقط از سایت های دولتی بود!
۳. برای مشخصات فنی و قیمت ها، مدل مستقیماً سراغ برند تولیدکننده می رود. جستجوهایی مثل site:sephora.com مکرراً دیده می شوند. حتی اگر نام برند را در پرامپت خود نیاورده باشید، ChatGPT در کوئری های انشعابی خود سراغ برندهای مطرح آن حوزه می رود و صفحات محصول آن ها را جستجو می کند.
نتیجه نهایی این است: دیده شدنِ بیشتر برای سایت های با اتوریتی (اعتبار) بالا و برندهای معتبر، و کاهش شدید استناد برای سایر سایت ها.
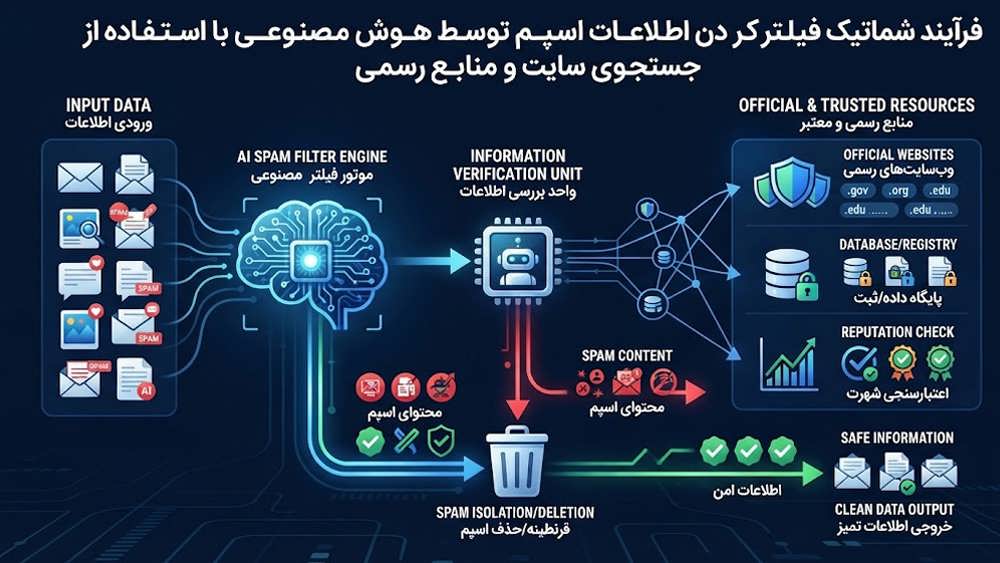
نمایش شماتیک و گرافیکی از نحوه فیلتر کردن اطلاعات اسپم توسط هوش مصنوعی با استفاده از جستجوی سایت و منابع رسمی.
یافته های متخصصان سئو درباره کوئری های انشعابی
دیوید کونیتزنی (David Konitzny) از Peec AI داده ها را در روزی که ChatGPT 5.6 پیش فرض شد، بررسی کرد:
- سهم پرامپت هایی که فقط یک کوئری انشعابی داشتند از ۹۴٪ به ۴۳.۵٪ سقوط کرد.
- میانگین منابع بازیابی شده دو برابر شد (از ۱۲ به ۲۴).
- حضور عملگر
:siteدر جستجوهای انشعابی از ۰.۳٪ به حدود ۲۳٪ جهش کرد!
کریس لانگ (Chris Long) با بررسی ۴۰۰۰ پرامپت دریافت که طولانی ترین زنجیره جستجوی ChatGPT از ۴ جستجو به ۲۹ جستجو رسیده است و کلماتی مانند site:، official و gov جزو پرتکرارترین کلمات بوده اند (عملگر :site در ۶۴٪ کوئری های او دیده شد).
دیوید همچنین متوجه شد که سهم «صفحات محصول» (Product Pages) در نتایج بازیابی شده به ۱۶.۳۹٪ رسیده و از «مقالات لیستی» پیشی گرفته است. این یعنی ChatGPT دیگر برای پیدا کردن قیمت و مشخصات به مقالات لیستی و نقد و بررسی های متفرقه (که معمولاً اسپم یا خودتبلیغی هستند) تکیه نمی کند و مستقیم سراغ فروشنده می رود. (در دپارتمان طراحی سایت دانش وب، به همین دلیل است که ما روی کدنویسی اسکیما و پیاده سازی ساختار استاندارد در صفحات محصول فروشگاهی تاکید ویژه ای داریم تا محصولات شما بدون واسطه توسط هوش مصنوعی خوانده شوند).
اولیویر دی سگونژاک (Olivier de Segonzac) نشان داد که تعداد دامنه های یکتای استناد شده در پاسخ ها از ۱۹ به ۱۵ دامنه کاهش یافته است. سایتِ Ahrefs نیز گزارش داد که بیشترین استنادها به ترتیب به رددیت، ویکی پدیا، فوربز و والمارت تعلق دارد.
سوگانثان موهاناداسان (Suganthan Mohanadasan) نکته کلیدی دیگری را کشف کرد: ChatGPT قبل از جستجو تصمیم می گیرد!
در بررسی های او، در ۲۱ مورد از ۲۷ کوئری اولیه، ChatGPT نام برندهایی را در جستجوی خود قرار داده بود که کاربر اصلاً آن ها را در پرامپت خود نبرده بود! مثلاً وقتی کاربر پرسید «بهترین اپلیکیشن یادداشت برداری هوش مصنوعی»، ChatGPT در اولین جستجوی خود مستقیماً کلمات Notion AI، Otter و… را سرچ کرد.
بودن نام شما در کوئری اولیه، هدف نهایی است؛ برندهایی که در جستجوی اولیه حضور داشتند، در ۶۸.۹٪ مواقع لینک استناد دریافت کردند. اما صفحاتی که صرفاً در طول مسیر بازیابی شده بودند، فقط ۲.۱٪ شانس گرفتن لینک داشتند.
اجماع و نتیجه گیری از تحقیقات
با وجود تفاوت در ابزارها، چهار الگوی ثابت در تمام تحقیقات دیده می شود:
۱. ChatGPT بسیار بیشتر از سال گذشته برای هر پرامپت سرچ می کند (حتی در نسخه های رایگان).
۲. سهم عظیمی از این جستجوها با عملگر :site محدود می شوند.
۳. گرایش شدید به سمت سایت های با اتوریتی بالا (سایت های دولتی، ویکی پدیا، فروشگاه های بزرگ و منابع رسمی) است.
۴. میزان «بازیابی» صفحات افزایش یافته، اما تعداد دامنه های «استناد شده» کاهش یافته است.
بخش دوم: تئوری من درباره چرایی این اتفاقات
تمام این موارد برای من بسیار جذاب است، زیرا کاملاً با سیستم رتبه بندی E-E-A-T گوگل هم راستا است. من معتقدم OpenAI از کوئری های انشعابی به عنوان روشی برای تضمین ارائه اطلاعات معتبر و باکیفیت به کاربر و سرکوب مقالات اسپم و دستکاری شده استفاده می کند.
عملگر :site حداقل تا حدی، به عنوان یک فیلتر اسپم (Spam Filter) عمل می کند.
ارزیابی کیفیت یک صفحه وبِ ناشناخته در لحظه (Real-time) کار بسیار سخت و پرهزینه ای است. محدود کردن جستجوها به سایت های .gov، پلتفرم های نقد معتبر و برندهای شناخته شده، راهی بسیار ارزان تر برای رسیدن به همان نتیجه است. در واقع مدل هوش مصنوعی به جای ارزیابیِ اینکه آیا یک سایت متفرقه قابل اعتماد است یا نه، صورت مسئله را پاک می کند و فقط در مکان هایی جستجو می کند که از قبل به آن ها اعتماد دارد.
استفاده از پسوند .gov برای موضوعات حساس (YMYL) نشان می دهد که ChatGPT می خواهد خط قرمزی بین مقالات پربازدیدِ شرکت های حقوقی/پزشکی و مراجع رسمی دولتی بکشد.
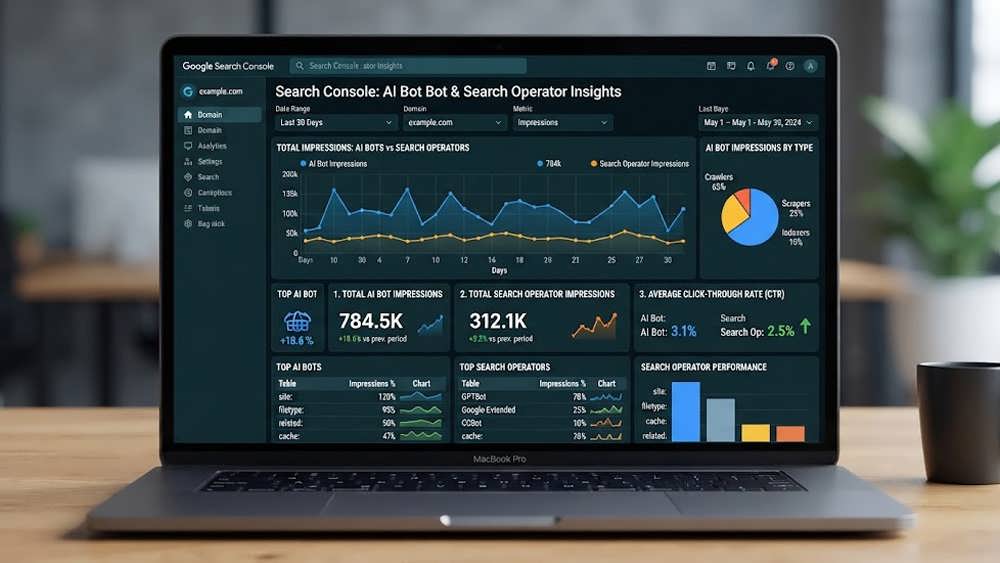
داشبورد و نمودارهای تحلیلی نمایش دهنده ایمپرشن های ربات های هوش مصنوعی و عملگرهای سرچ در کنسول جستجو.
استفاده از کلمه «رسمی» (Official) در کوئری ها
حضور پررنگ کلمه Official در جستجوهای ChatGPT نشان می دهد این ابزار به شدت دنبال پیدا کردن منبع اصلیِ یک محصول یا برند است تا فریب مقالات شخص ثالث را نخورد.
این موضوع به ما متخصصان سئو یادآوری می کند که استفاده از عباراتی نظیر «سایت رسمی» یا «نمایندگی رسمی» در تگ Title و توضیحات متا (Meta Description) صفحه اصلی سایت تا چه حد می تواند مهم باشد. این کار به مدل هوش مصنوعی کمک می کند تا درک کند کدام دامنه واقعاً متعلق به برند شماست.
خطرات وابستگی به جستجوهای site
مقالات مالت لندور (Malte Landwehr) و موسسه Netcraft نشان دادند که اگر ChatGPT نتواند دامنه اصلی یک برند را تشخیص دهد، شروع به حدس زدن می کند و گاهی اشتباه حدس می زند! مثلاً برای یک استارتاپ به نام Census (که دامنه اصلی آن getcensus.com بود)، هوش مصنوعی مدام دامنه پارک شده ی census.com را با عملگر :site جستجو می کرد.
این اتفاق یک خطر امنیتی است. یک کلاهبردار می تواند آن دامنه پارک شده را بخرد، اطلاعات فیمت یا شماره پشتیبانیِ جعلی را در آن قرار دهد و هوش مصنوعی نیز بدون آگاهی، آن اطلاعات غلط را به کاربران ارائه کند!
ردپای جستجوهای site: در سرچ کنسول گوگل
اخیراً در سرچ کنسولِ بسیاری از برندهای بزرگ، کوئری هایی که شامل عبارت :site هستند، صدها هزار «ایمپرشن» (Impression) دریافت می کنند در حالی که کلیک آن ها نزدیک به صفر است!
نرخ کلیکِ (CTR) صفر درصد، کار کاربران انسانی نیست؛ این ردپای ربات ها (LLMs) و خزنده های هوش مصنوعی است. مایکروسافت در پلتفرم Bing Webmaster Tools بخشی را به نام گزارش هوش مصنوعی راه اندازی کرده که این کوئری های انشعابی را به تفکیک نشان می دهد، اما گوگل همچنان این داده ها را از ما پنهان می کند. بنابراین توصیه عملی این است که در سرچ کنسول گوگل، با استفاده از فیلتر Regex به دنبال عبارات :site بگردید تا متوجه شوید آیا هوش مصنوعی در حال استخراج سایت شماست یا خیر.
چه اقدامات عملی باید انجام دهیم؟
همه این موارد نشان می دهد که برخلاف شایعات، سئو امروز مهم تر از همیشه است! از آنجا که ChatGPT همچنان به موتورهای جستجوی کلاسیک متکی است، داشتن رتبه خوب در جستجوی سنتی همچنان اولین قدم برای ورود به کوئری های انشعابی است. کارهایی که باید انجام دهید:
- برند خود را بسازید: هدف نهایی این است که نام برند شما با حوزه فعالیت تان مترادف شود تا ChatGPT پیش از سرچ کردن، نام شما را در کوئری خود بگنجاند. (تیم دیجیتال مارکتینگ دانش وب با تدوین کمپین های روابط عمومی دیجیتال و ایجاد منشن های قدرتمند، دقیقاً روی همین نقطه ضعف الگوریتم های جدید کار می کند).
- اطلاعات کلیدی را در کدهای HTML ساده قرار دهید: قیمت ها، مشخصات فنی و شماره های تماس نباید در تصاویر یا کدهای پیچیده جاوا اسکریپت (Client-side) پنهان شوند. هوش مصنوعی باید بتواند آن ها را به سادگی بخواند.
- دامنه «رسمی» خود را تثبیت کنید: اگر نام برند شما با شرکت های دیگر مشترک است، حتماً از عباراتی مثل «وب سایت رسمی» در تایتل صفحه اصلی خود استفاده کنید. این بهترین دفاع در برابر مشکل حدسِ اشتباه دامنه توسط هوش مصنوعی است.
- درگیر هدف گیریِ کوئری های طولانی (Long-tail) نشوید: تلاش برای ساختن هزاران صفحه برای تک تک سوالاتی که هوش مصنوعی می پرسد، فقط شما را در تله آپدیت اسپم گوگل می اندازد. به جای آن، مفاهیم و موجودیت های اصلی (Entities) را هدف بگیرید.
- حضور خود را تست کنید: مانند تست آقای سوگانثان، پرامپت های مربوط به حوزه خود را چند بار در ChatGPT تست کنید. اگر در مرحله جستجوی اولیه نامی از برند شما نیست، باید روی برندسازی و پروموت شدن توسط سایت های شخص ثالث (مثل نقد و بررسی ها و انجمن ها) کار کنید، نه فقط روی سئوی تکنیکال.
- رددیت و انجمن های تخصصی را جدی بگیرید: اگرچه بسیاری از انجمن ها (در ایران وب سایت هایی مثل نی نی سایت، ویرگول یا شبکه های اجتماعی تخصصی) لینک مستقیمی برای شما نمی آورند، اما نحوه درک مدل هوش مصنوعی از دسته بندی و اعتبار شما را شکل می دهند. مراقب باشید که این فضاها را با پیام های اسپم و تبلیغاتی پر نکنید، چرا که پلتفرم ها به شدت با این رفتارها برخورد می کنند.
- ایمپرشن های
site:را زیر نظر بگیرید: حتماً گزارش های سرچ کنسول و بینگ وبمستر را برای ردیابی رفتار خزنده های هوش مصنوعی روی سایت خود بررسی کنید.
نتیجه گیری
تغییرات ساختاری در نحوه جستجوی مدل های زبانی بزرگ (LLMs) نشان می دهد که عصرِ سئوی مبتنی بر «ترفندها و میانبرها» رو به پایان است. محدود شدن جستجوهای ChatGPT به دامنه های رسمی، منابع معتبر دولتی و انجمن های تخصصی، پیامی روشن برای کسب وکارهای ایرانی دارد: هوش مصنوعی به محتوای خودتبلیغی و مقالاتِ بی کیفیتِ مبتنی بر کلمات کلیدی، آلرژی پیدا کرده است.
برای موفقیت در اکوسیستم جدید جستجو، کسب وکارها باید تمرکز خود را از «تولید محتوای انبوه» به سمت «ساخت اعتبار برند و بهینه سازی موجودیت ها (Entities)» تغییر دهند. تثبیت نام برند در پلتفرم های بی طرف، پیاده سازی کدهای استاندارد (HTML/Schema) برای خوانایی بهترِ قیمت ها و مشخصات توسط ربات ها، و تمرکز بر روابط عمومی دیجیتال (Digital PR)، پایه های اصلی سئو در سال های پیش رو خواهند بود. ما در دانش وب، با درک عمیق از این تحولات، استراتژی های طراحی سایت و سئوی کارفرمایان خود را بر مبنای هم سویی با هوش مصنوعی و ساخت برندهای مقاوم در برابر تغییرات الگوریتمی تدوین می کنیم تا جریان ترافیک هدفمند شما همواره تضمین شده باشد.